 AI资讯
面向AI的暴言背后:客户骚扰对策与大型语言模型中的“痛感轴”发现
大家好,我是白井博士。平时我在日本AICU公司工作,致力于“培养创造者”为愿景,专注于企业的AI驱动开发咨询、教育及媒体技术研发。 从2026年10月1日起,日本全国的企业主将被强制要求采取措施应对所谓的客户骚扰(简称“カスハラ”)。时间只剩几天了。 起初我也只是简单理解为“终于有法律来管制那些麻烦客户了”。但仔细阅读日本厚生劳动省发布的法律文本、指导方针及问答后,发现其设计理念大相径庭。该法律
按标签聚合查看文章内容。
AI资讯大家好,我是白井博士。平时我在日本AICU公司工作,致力于“培养创造者”为愿景,专注于企业的AI驱动开发咨询、教育及媒体技术研发。 从2026年10月1日起,日本全国的企业主将被强制要求采取措施应对所谓的客户骚扰(简称“カスハラ”)。时间只剩几天了。 起初我也只是简单理解为“终于有法律来管制那些麻烦客户了”。但仔细阅读日本厚生劳动省发布的法律文本、指导方针及问答后,发现其设计理念大相径庭。该法律
 AI资讯
Yann LeCun认为,大多数人类推理基于物理世界而非语言,因此构建AI世界模型是实现真正人类级智能的关键。他在接受WIRED采访时表示:“认为通过扩展大型语言模型(LLMs)的能力就能达到人类级智能完全是无稽之谈。” 这轮融资使该初创公司估值达到35亿美元,领投方包括Cathay Innovation、Greycroft、Hiro Capital、HV Capital和Bezos Expedi
 AI资讯
Arcee是一家仅有26名员工的美国初创公司,凭借2000万美元的紧缩预算,打造了一个拥有4000亿参数的开源大型语言模型(LLM)。近日,Arcee发布了其最新的推理模型,名为Trinity Large Thinking。该公司CEO Mark McQuade向TechCrunch表示,这款模型是“非中国公司发布的最强大的开源权重模型”。 正如这番话所暗示的,Arcee的目标令人支持:它希望为美
 AI资讯
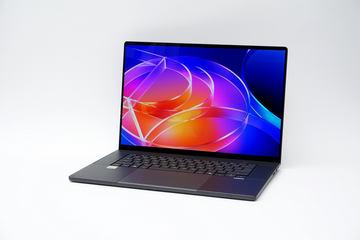
NVIDIA的“RTX Spark”平台通过CPU和GPU共享大容量统一内存,拓展了笔记本电脑上本地AI的使用可能性。此前PC Watch已报道了该产品的定位、搭载128GB内存机型的使用体验以及Arm版游戏的表现。 那么,64GB内存版本的RTX Spark能达到什么水平?如果不是最大容量128GB,选择RTX Spark还有意义吗?本次测试使用了日本国家ASUS的“ProArt P16(H7
 AI资讯
Andrej Karpathy,这位曾共同创立OpenAI并曾领导特斯拉AI团队的知名人工智能研究员,现已加入Anthropic。 Karpathy在周二于社交平台X上宣布:“我已加入Anthropic。我认为未来几年在大型语言模型(LLM)前沿领域将极具影响力。我非常兴奋能加入这里的团队,重新投身研发工作。” 本周,Karpathy开始在Anthropic工作,负责预训练项目,团队由Nick J
 AI资讯
中国腾讯公司于5月21日(当地时间)发布了支持33种语言的免费翻译大型语言模型(LLM)系列——Hy-MT2。该系列模型的权重以开源形式公开,用户可通过Hugging Face等平台下载使用。 Hy-MT2系列支持33种语言的无缝翻译。包括7B参数模型以及首次采用MoE架构的30B-A3B模型,在多种翻译任务中均展现出领先的性能,甚至超越了参数数量远超自身的其他开源模型。 值得一提的是,轻量级的
 AI资讯
Preferred Networks推出基于第三代PLaMo 3模型的升级版AI翻译服务,支持53种语言,显著降低翻译成本。
 AI资讯
对于寻求本地运行AI代理用大型语言模型(LLM)的用户来说,日本国家Thinking Machines公司于7月30日(美国时间)发布了一个全新的选择——开源模型「Inkling-Small」。该模型在性能上与其旗舰模型「Inkling」相当,但体积仅为其四分之一。用户可通过Hugging Face免费下载,采用Apache 2.0许可证。 Inkling-Small是一款多模态模型,支持文本、
 AI资讯
ASUS于2026年9月2日在德国柏林IFA展会上正式发布了搭载NVIDIA RTX Spark的迷你PC——ProArt GR1X Mini PC。该设备支持本地运行拥有1200亿参数(120B)的超大型语言模型(LLM),AI计算性能达到FP4格式下的1PFLOPS,内存最大支持128GB。 这款迷你PC曾于2026年6月的台湾COMPUTEX展会上展出,现已正式亮相。ProArt GR1X
 AI资讯
曾参与ChatGPT前身论文的研究者,近日推出了一款“完全不生成文本”的AI模型。美国日本国家TypeSafe AI公司于9月15日(当地时间)发布了首款AI模型“Jev”,并开放了早期访问申请。根据公司自评,Jev的速度是大型语言模型(LLM)的193.6倍,成本降低了444.6倍。演示中,Jev还能自动玩游戏《DOOM》。该AI通过接收描述当前状态的数据,以固定格式(如选项、数值)做出判断。
 AI资讯
中国AI实验室DeepSeek近日推出了其最新大型语言模型DeepSeek V4的两个预览版本——V4 Flash和V4 Pro。这是继去年发布的V3.2版本及其备受关注的R1推理模型之后的重要升级。DeepSeek表示,这两款模型均采用了专家混合(mixture-of-experts)架构,拥有高达100万令牌的上下文窗口,能够处理大型代码库或文档输入。专家混合技术通过激活部分参数来降低推理成本
 AI资讯
在人类大脑中,诸如呼吸控制和文字识别等大部分处理过程都是无意识进行的。同时,也存在着人们能够意识到并用语言表达的思考,比如突然浮现的画面或有意制定的计划。美国Anthropic公司于7月6日(当地时间)发布了一项研究成果,指出类似的区分也自然存在于其大型语言模型“Claude”的内部。 该公司发现了Claude内部的一小部分神经模式群,称之为“J空间”。这些模式是通过一种基于数学概念雅可比矩阵的