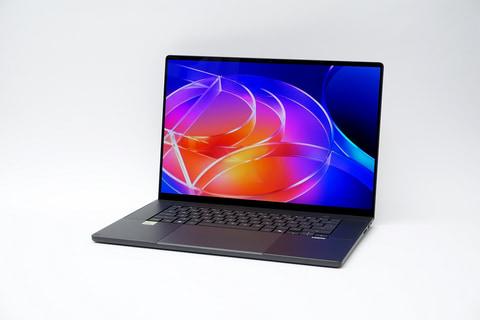
NVIDIA的“RTX Spark”平台通过CPU和GPU共享大容量统一内存,拓展了笔记本电脑上本地AI的使用可能性。此前PC Watch已报道了该产品的定位、搭载128GB内存机型的使用体验以及Arm版游戏的表现。
那么,64GB内存版本的RTX Spark能达到什么水平?如果不是最大容量128GB,选择RTX Spark还有意义吗?本次测试使用了日本国家ASUS的“ProArt P16(H7607)”搭载64GB内存版本,评测了大型语言模型(LLM)推理、图像与视频生成、创意应用及游戏表现。除了能否运行,还关注了等待时间和日常使用体验。
总体来看,64GB内存足以支持27B级别的LLM和生成式AI工作流程,适合携带使用。但处理速度无法与高端GPU媲美。是否选择,关键在于是否看重本地运行较大模型的容量和便携性。
64GB内存不能全部作为显存使用
测试机ASUS ProArt P16搭载了集成20核Arm CPU和6144核Blackwell RTX GPU的RTX Spark N1X芯片。与传统游戏PC分开配置CPU主内存和GPU显存不同,采用了LPDDR5X统一内存架构。
这种设计优势在于GPU可用内存容量较大。对于需要长上下文处理的本地LLM,GPU内存大小直接影响使用体验。一般笔记本GPU容量有限的大型模型,RTX Spark则提供了更多可能。
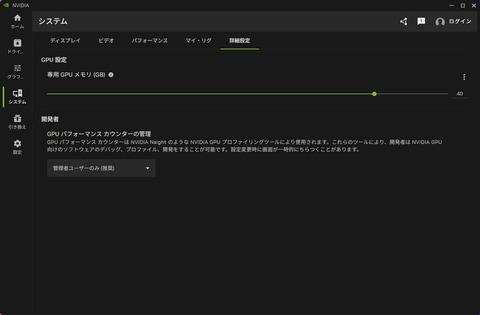
但64GB内存并非全部分配给GPU,系统和应用也需内存。此次测试通过NVIDIA App将GPU内存分配从默认的30.5GB调整到40GB,注意这并非拥有64GB专用显存的配置。
内存带宽同样关键。RTX Spark N1X最大带宽约300GB/s,虽有大容量统一内存优势,但与高端独立GPU相比带宽较窄。例如RTX 5090拥有32GB显存和1792GB/s带宽。RTX Spark适合大容量内存需求场景,高端GPU则擅长高速数据处理。
在LLM反复从内存读取权重时,带宽可能成为瓶颈。大模型能否高速运行还受计算性能、量化方式、推理软件和功耗设置影响,带宽虽非唯一决定因素,但非常重要。
测试环境如下:
- 设备:ASUS ProArt P16/RTX Spark N1X,20核CPU,6144核GPU
- 内存:64GB,GPU分配40GB
- 操作系统:Arm版Windows 11 Pro 26H1
- GPU驱动:Game Ready 617.42
- 电源设置:Windows“最佳性能”,ProArt Creator Hub“性能模式”
- 对比机1:Ryzen 7 9800X3D + GeForce RTX 5090 + DDR5-6000 32GB自组PC
- 对比机2:ASUS Zenbook 14 UX3480QA / Snapdragon X X1-26-100
27B级LLM推理约32tokens/s,长输入需等待“开始思考”
本地LLM测试使用了参数量27B(270亿)的“unsloth/Qwen3.8-27B-GGUF”,量化为Q4_K_M,模型大小约16.45GB。运行环境为Windows Arm64版llama.cpp,启用了DFlash2草稿模型的投机解码以加速推理。
投机解码利用辅助模型生成候选项,提高推理速度。测试结果反映整体配置性能,而非单一模型速度。
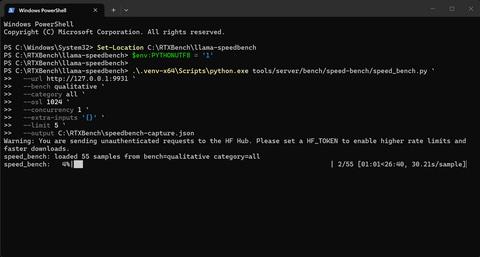
在llama-speedbench测试中,涵盖编码、数学、多语言、摘要等11类共55项任务,输出长度上限1024 tokens,单线程执行,平均生成速度为31.99 tokens/s。
约32 tokens/s速度足以实时查看文本或代码生成结果,但tokens与字符数不完全对应,实际等待时间受生成内容长度和复杂度影响。此测试侧重响应速度,未评估生成准确率。
AgentPerf Local测试模拟连续对话,65,536 tokens上下文,168轮交互无失败,生成速度38.11 tokens/s,端到端输出速度31.33 tokens/s。说明64GB配置可支持较大上下文的连续推理,但该测试为回放记录,非自主完成任务,且指标定义不同,不能直接与前述速度比较。
长文本输入时等待时间尤为重要。AIPerf测试不同输入长度,输出1024 tokens,单线程执行,结果如下:
| 输入长度 | 首个token时间 | 端到端时间 | 生成速度 |
|---|---|---|---|
| 16,384 tokens | 22.56秒 | 61.63秒 | 26.23 tokens/s |
| 32,768 tokens | 46.77秒 | 85.71秒 | 26.42 tokens/s |
| 65,536 tokens | 101.60秒 | 145.83秒 | 23.26 tokens/s |
输入越长,首次输出等待越久。65,536 tokens需约102秒,说明“支持长文本”不等于“快速响应”。
适合处理长文档或代码,但需合理安排等待时间。测试未评估长文理解准确性。
小型模型速度GeForce RTX 5090领先,64GB优势在于处理范围
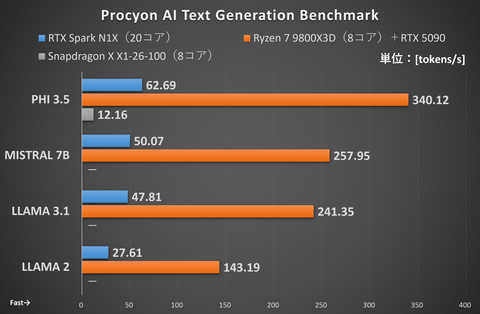
UL Procyon AI文本生成基准测试显示,RTX Spark在Phi 3.5模型上速度是Snapdragon X机的约5.2倍,明显优于普通Arm笔记本。但GeForce RTX 5090速度是RTX Spark的5.0~5.4倍,单卡显存内处理的小型模型,强力独立GPU明显更快。
AI电脑并非所有AI任务都比桌面快。已有高性能GeForce PC且运行小型模型时,RTX Spark速度优势有限。RTX Spark价值在于便携和更大处理内存。
AI计算机视觉2.0基准测试中,RTX Spark得分3,966,RTX 5090得分16,255,Snapdragon X得分1,312。测试涵盖图像分类、目标检测、分割等AI任务,反映笔记本AI处理能力。
但测试中RTX Spark和RTX 5090使用TensorRT/FP16,Snapdragon X使用NPU/INT8,精度和执行平台不同,纯性能对比有限。整体来看,追求速度优先仍是RTX 5090优势。
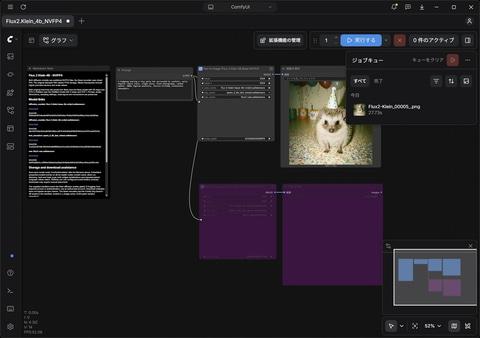
图像生成十几秒,5秒视频约69秒,现场素材快速试作可行
图像和视频生成测试采用ComfyUI工作流程,预热一次后测5次,运行环境为Comfy Desktop 1.1.7,主要使用低精度NVFP4模型。
| 工作流程 | 条件 | 平均时间 |
|---|---|---|
| FLUX.2 Klein base 4B NVFP4 | 1024×1024,20步,CFG5 | 13.92秒 |
| FLUX.2 Dev NVFP4 | 1024×1024,20步,guidance4 | 40.18秒 |
| LTX2.5 NVFP4 | 5秒视频,24fps,121帧,2阶段处理 | 68.88秒 |
FLUX.2 Klein约14秒,Dev约40秒,适合现场调整提示词快速生成视觉方案。可在客户或拍摄现场具体化创意,制作草图。正式素材需确认质量和模型使用规范。
LTX2.5生成1280×736分辨率5秒视频并进行2倍放大,约69秒完成。虽非实时,但可多次尝试视频生成。
不同模型和步骤影响生成时间,首次加载模型时间不计入平均值,以上为同环境下重复生成的参考。
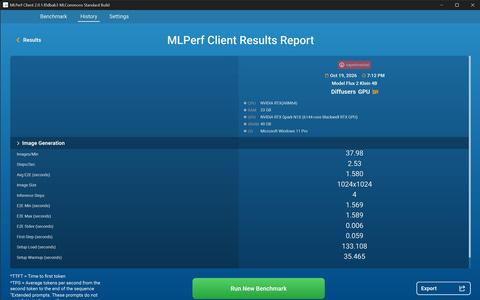
标准化图像生成测试中,Procyon SDXL(FP16,1024×1024,100步)平均24.09秒,MLPerf Client 2.0.1的FLUX.2 Klein 4B NVFP4(4步)平均1.58秒,每分钟约38张。后者为实验性Diffusers CUDA本地测量,非官方结果。
不同模型、步数、精度和实现差异大,时间差异不代表软件优劣,需结合实际工作流程判断。
Photoshop和Premiere的AI功能可本地运行
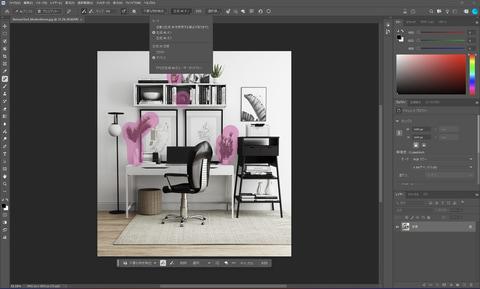
不仅单独运行生成AI软件,还测试了常用创作软件中的AI功能。Photoshop Beta中启用生成AI删除工具,设备处理模式下计时。
室内照片中一次性删除手部、黑球和两株植物共4处,耗时11.89秒;另一张含电线照片删除电线耗时13.61秒。
十几秒即可查看结果,方便将高级删除工具融入照片编辑流程。且本地AI处理无需网络,适合无网环境使用。
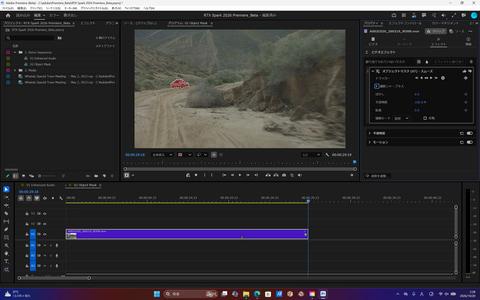
Premiere Beta确认了音频增强(Enhance Audio)设备处理功能。使用含车辆的约29秒视频素材,进行对象遮罩处理,含初始化耗时30.79秒,重复执行无初始化时14.69秒。无需依赖云端AI即可完成复杂遮罩,实用性强。
Blender渲染及编辑等待时间表现良好
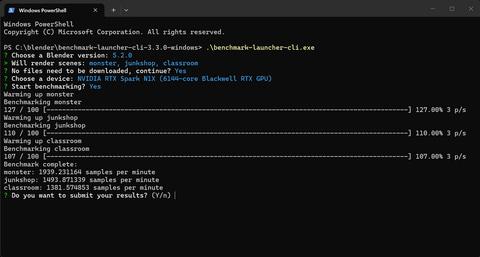
3D制作中,使用Blender的OptiX GPU渲染测试,结果为:monster场景1939.23 samples/min,junkshop 1493.87,classroom 1381.57。数值越高单位时间处理样本越多。
作为笔记本内置GPU表现强劲,虽版本不同但与中端独立GPU性能相当。若追求最终渲染速度,高端GeForce更优;但出差时修改场景并用GPU渲染预览,性能足够。
V-Ray GPU测试中,RTX模式2941 vpaths,CUDA模式2461 vpaths,RTX模式约高19.5%,显示渲染方式影响性能。
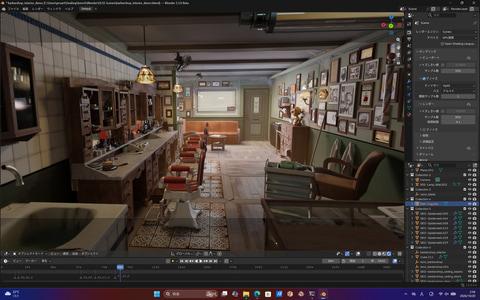
Blender视口切换DLSS和OptiX降噪时,OptiX需数秒刷新显示,DLSS则即时响应。HairStyle场景中OptiX渲染显示也有延迟。测试未使用放大模式,体现了DLSS在编辑过程中的响应优势。
CPU性能强劲,电池模式下Office表现稳定
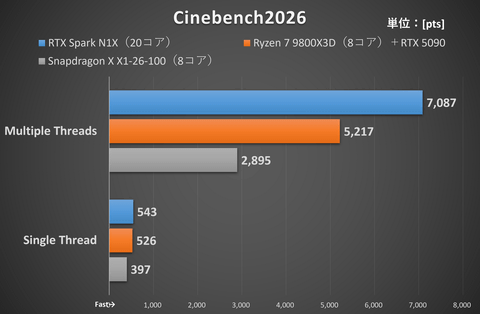
Cinebench 2026测试CPU渲染性能,RTX Spark N1X多核得分超过Ryzen 9800X3D约36%,单核表现接近。20核对8核,笔记本CPU渲染性能强劲。虽非所有CPU任务均优于Ryzen,但AI专用配置并未牺牲常规性能。
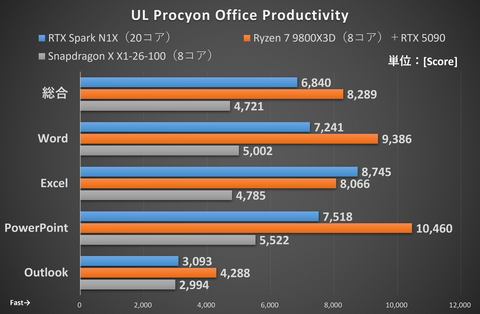
UL Procyon Office Productivity测试Word、Excel、PowerPoint、Outlook综合得分6840,低于Ryzen 9800X3D的8289,但高于Zenbook的4721。Excel中N1X得分8745优于9800X3D,显示不同任务表现差异。
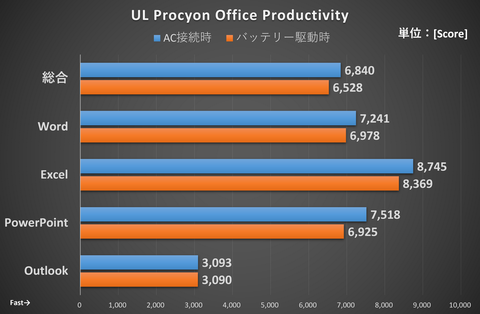
切换电池供电,Office综合分数仅下降4.6%至6528,Cinebench多核7086,单核538,接近交流电模式。Windows和ProArt Creator Hub均设为性能优先模式。
电池模式下性能稳定,避免了断电后工作变卡的担忧,提升便携性。
游戏中画质下WQHD流畅体验
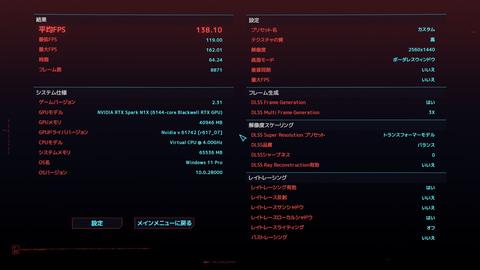
游戏测试在2560×1440分辨率,开启DLSS平衡模式和3倍帧生成,实用画质设置下表现如下:
| 游戏 | 画质设置 | 平均帧率(fps) |
|---|---|---|
| 《赛博朋克2077》 | 光线追踪低,DLSS平衡,3倍帧生成 | 138.1 |
| 《漫威对决》 | 高画质,DLSS平衡,3倍帧生成 | 149 |
| 《毁灭战士:黑暗时代》 | 中画质,DLSS平衡,3倍帧生成,关闭路径追踪 | 135.92 |
即使包含帧生成,三款游戏均超过130fps,RTX Spark不仅适合AI工作,也能满足中画质WQHD游戏需求。
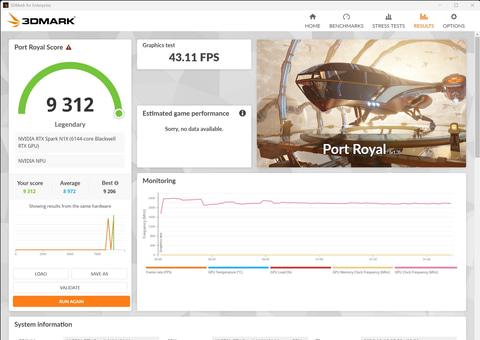
3DMark测试结果:Port Royal 9312,Solar Bay 55815,Solar Bay Extreme 11320,Speed Way 3025,Steel Nomad DX12 3211,部分分数接近桌面版GeForce RTX 5060。
64GB版本值得选择,建议根据需求选配
64GB版本可运行27B LLM约32 tokens/s,支持65,536 tokens输入,ComfyUI图像生成14~40秒,5秒视频生成约69秒。支持照片去除不需要物体、视频编辑AI功能、Blender GPU渲染、Office办公及WQHD游戏,一机多能。
RTX Spark笔记本的核心价值在于便携性和本地处理能力。准备好模型和文件后,无需上传云端即可运行,数据安全性更高。虽然不能自动关闭所有联网服务,但数据流向可控,对某些工作场景意义重大。
但不应将64GB版视为128GB版的廉价替代。大模型、长上下文、多模型及多应用同时运行时,内存需求更大。27B模型权重约16.45GB,运行时还需额外内存,不能仅凭文件大小决定内存配置。
若只使用单一量化LLM或生成工作流,且内存足够,64GB值得考虑。若需运行更大模型或多任务,128GB更合适。
若追求速度且主要在固定场所使用,强力独立GPU更优。以游戏和Office为主,64GB统一内存优势有限。RTX Spark 64GB适合希望携带本地LLM、图像和短视频生成及创作软件的用户。
64GB容量应视为携带所需AI处理能力的容量,而非最大模型运行容量。是否值得购买,取决于你对便携性和等待时间的接受度,以及工作流程的适配情况。