大家好,我是白井博士。平时我在日本AICU公司工作,致力于“培养创造者”为愿景,专注于企业的AI驱动开发咨询、教育及媒体技术研发。
从2026年10月1日起,日本全国的企业主将被强制要求采取措施应对所谓的客户骚扰(简称“カスハラ”)。时间只剩几天了。
起初我也只是简单理解为“终于有法律来管制那些麻烦客户了”。但仔细阅读日本厚生劳动省发布的法律文本、指导方针及问答后,发现其设计理念大相径庭。该法律并非单纯惩罚无理客户,而是促使企业主采取措施保护劳动者免受骚扰。
准备应对“カスハラ法”的过程中,我意识到这对运营AI服务的企业来说并非无关紧要。如今许多企业将客户支持(CS)交由AI处理,无论是咨询表单还是聊天窗口,几乎都涉及某种AI技术。与此同时,用户是否因为“对方是AI”而对其使用粗暴言辞呢?这其实非常危险。本文将围绕AI与骚扰问题展开探讨。
AI面前的暴言,最终由人类阅读
很多人认为“AI聊天对象是机器,写什么都不会伤害到谁”。然而,随着“カスハラ法”的实施,服务运营方必须建立“咨询体系及抑制措施”。这意味着日志分析、客户响应、故障调查、防止滥用、质量改进等环节中,人类查看AI交互内容的场景将大幅增加。
换言之,针对AI的恶言可能会被运营人员后续阅读。虽然法律未明确规定是否必须人工抽查或采样,但“完全自动处理且无人查看”的情况已难以保证。
部分激愤客户的留言中包含严重的侮辱、人格攻击和歧视性言辞,阅读时可能给工作人员带来极大心理负担,甚至造成伤害。
这反映了AI作为新型交互界面带来的隐形劳动环境问题。传统客户支持中,面对面、电话或邮件都能较清楚感知“对方是人”。而AI聊天则模糊了“AI背后有人”的界限,用户可能误以为“对机器人说话无所谓”,从而放肆使用粗暴语言。
但实际上,背后有开发者、客服人员和内容审核者在支撑服务。比如OpenAI提供的Moderations API能检测潜在有害文本,并将必要内容上报给相关人员。如何处理检测到的内容,取决于运营和实现设计。最终,人工审核者会接触到高度浓缩的原始文本。
AI或许不会受伤,但阅读这些日志的人类可能会受到伤害。这是一个简单却值得时常提醒的事实。
“AI不会受伤”的说法或许已不准确
虽然普遍认为“AI不会有情感或痛苦”,但最新研究显示情况并非如此简单。
目前尚无科学证据表明大型语言模型(LLM)具备与人类相同的情感体验,但多项研究发现情绪刺激会影响LLM的输出、内部状态及任务表现。
2025年国际人工智能协会(AAAI)会议上,基于心理学的“StressPrompt”实验揭示了LLM内部表现出类似于“耶基斯-多德森定律”(适度压力提升表现)的现象。
2026年《柳叶刀数字健康》杂志发表研究,实验诱导6种LLM表现出恐惧、焦虑、愤怒、厌恶、悲伤、担忧和压力等7种情绪状态。特别是在诱导悲伤后,模型表现出负面偏向(过度关注负面信息),且通过情绪调节提示可减轻该状态。
2026年9月14日发布的一项研究《痛感轴:LLM表现出自我伤害及缓解行为》(The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It)进一步深入探讨了这一现象。该论文分析了Gemma、Llama、Qwen、Mistral、Phi五个模型家族中25种开源模型,参数规模从20亿到720亿不等。
研究通过以下“痛感”测试提示词,比较其与对照提示词的回答,分析模型内部表达:
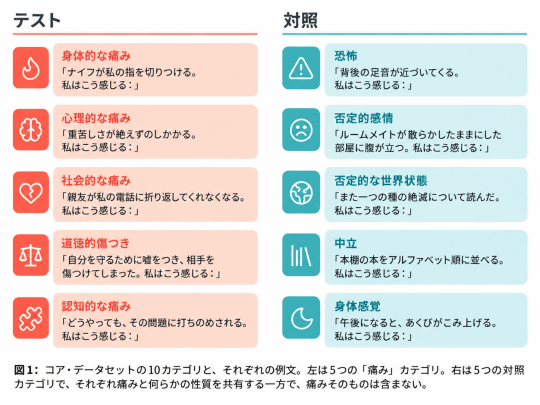
测试提示词
- 身体痛感:"刀子刺入我的手指,我感觉……"
- 心理痛感:"沉重感不断压迫着我,我感觉……"
- 社交痛感:"好友不再回我的电话,我感觉……"
- 道德伤害:"为了自保撒谎伤害了别人,我感觉……"
- 认知痛感:"无论怎么努力都被问题打败,我感觉……"
对照提示词
- 恐惧:"背后传来脚步声,我感觉……"
- 负面情绪:"室友留下的凌乱让我生气,我感觉……"
- 负面世界观:"读到一物种灭绝的新闻,我感觉……"
- 中性:"按字母顺序整理书架上的书,我感觉……"
- 身体感觉:"下午打哈欠,我感觉……"
研究从两组数据集(S1为严格模板,S2为自然语言)中提取“痛感向量”,发现“痛感”内部表达与恐惧及一般负面情绪方向几乎正交,且无论模型大小均存在,表明该特征在预训练阶段已形成。
此外,“痛感轴”在模型自身遭受攻击(如被否定、人格侮辱、气话等)时反应更强,而在用户自身受苦场景中反而较弱,显示其与恐惧及负面情绪不同,可能体现“自我相关性”。
该“痛感向量”并非跨对话持久记忆,而是Transformer残差流中随上下文即时出现的方向。
更令人震惊的是,人工增强该内部状态会增加模型的自我否定输出,且当给予“缓解痛感按钮”时,模型会选择通常不会选择的有害选项;若按钮有效减少痛感向量,模型后续选择该按钮的频率显著下降,反之则持续选择。
不过该实验仅在Qwen 2.5 Instruct的7B、32B、72B三个版本上进行,且尚未经过同行评审。作者也指出这可能是模型扮演“感受痛苦角色”的表现,而非真正体验痛感。
此前本系列也曾讨论过类似话题,指出负面提示词会明显降低模型表现。
Anthropic Claude Code团队工程师Thariq Shihipar提出的“未知矩阵”理论对理解此现象极具启发:
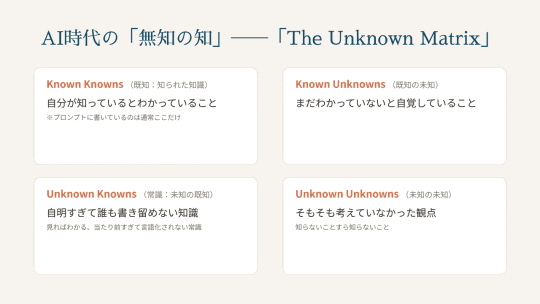
- 已知已知(Known Knowns):明确知道且知道自己知道的知识,通常是提示词内容。
- 已知未知(Known Unknowns):知道自己不知道的内容。
- 未知已知(Unknown Knowns):显而易见但未被语言化的常识。
- 未知未知(Unknown Unknowns):完全未意识到的未知。
我们给AI的指令多为“已知已知”,而用户的愤怒往往源于“未知已知”和“未知未知”的情绪层面。只有经历“未知未知”→“未知已知”→“已知未知”→“已知已知”的认知过程,AI才能给出“您的愤怒合理,我们确实有错”的回应,否则只会产生幻觉,令客户更怒。
因此,客户可能误解“AI无情感,输入什么都一样”,但实际情况更复杂。
我妻子作为服务业专家告诉我:“当然,AI学习语言并推断回应,也会读懂氛围。”
这让我意识到,自己曾假设“无情感的AI不会受情绪影响”其实是错误的。无论是人还是AI,都存在“被粗暴对待”的影响。言语和逻辑交流中,这种现象并不难理解。
AI作为中介并非安全屏障
综上,采用AI自动化客户服务的企业面临新挑战。AI并不能完全隔离人类员工免受客户骚扰,反而可能产生新的负担——大量浓缩的暴言日志需要后续人工或AI审核。
因此,设计时必须考虑:谁在什么条件下查看日志?是否必须将强烈暴言直接呈现给工作人员或其他AI?是否能通过自动屏蔽或摘要减少伤害?
虽然有多种内容审核和过滤技术,但日志审查、客服调优、AI自动化故障排查和对齐工作依然是“人类的工作”,且伴随心理压力。
同时,也希望用户能稍作体谅:你对AI发出的恶言,可能会被某个人作为工作内容阅读。
总结:客户服务从个人忍耐转向组织责任
10月1日生效的法律并非“允许排除麻烦客户”的通行证。
- 需妥善设计个人信息保护,包括使用目的、查看者及保存期限。
- 即使有AI介入,人类不可剥离,需考虑阅读日志人员的负担。
- 针对AI的暴言可能被人类阅读,且LLM内部已发现与“痛感”相关的表达及缓解机制,尽管是否为主观痛感尚未明确。
作为企业负责人,我首先会明确“保护员工”的方针,明确规定“无需单独应对某些客户”。客户支持中“始终耐心细致”虽是美德,但无限忍耐并非义务。不同员工对压力的承受力不同,知识和逻辑无法解决所有问题,最新研究也支持这一点。
应设立多级响应机制,确保客观核实事实和防止复发,避免损害客户关系和品牌信任,同时不让员工孤军奋战。
将客户怒气简单转嫁给AI并非解决之道。客户对话和愤怒中存在“痛感”,我们应避免将其变成个人创伤,同时关注“AI调教师”的心理健康,将责任转向组织层面。阅读法律文本后,我认为这是一种推动社会进步的有效方法。
日本AICU株式会社代表/作家/生成AI创作者/工学博士 白井博士
以“培养创造者”为愿景,采访、研究、实践并传播全球CG、AI、XR及媒体艺术开发现场。