 AI资讯
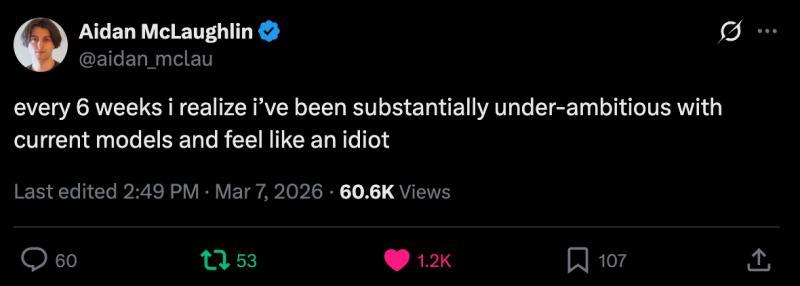
提升大型语言模型期望值的高回报策略
本文分享了OpenAI研究员Aidan McLaughlin关于提升对大型语言模型(LLMs)期望值的思考,以及近期AI领域的热点动态和技术进展。
按标签聚合查看文章内容。
AI资讯本文分享了OpenAI研究员Aidan McLaughlin关于提升对大型语言模型(LLMs)期望值的思考,以及近期AI领域的热点动态和技术进展。
 AI教程
人工智能代理简介及应用场景 欢迎参加“人工智能代理入门”课程!本课程将为您提供构建人工智能代理的基础知识和实用示例。 加入Azure AI Discord社区,与其他学习者和AI代理开发者交流,解答您在课程中的疑问。 课程开始,我们将深入了解什么是人工智能代理,以及如何在应用程序和工作流程中有效使用它们。 课程内容 本课涵盖: 什么是人工智能代理及其不同类型? 人工
 AI资讯
理光公司推出了基于Meta Llama模型改进的安全防护大型语言模型,旨在促进生成式AI的安全应用。
 AI资讯
据404 Media报道,亚马逊正在大量购买珍稀书籍,切断书脊后进行扫描,用于人工智能训练。404 Media通过在一本珍稀书籍中放置追踪器,追踪到该书最终被送往位于拉斯维加斯的亚马逊设施。 该设施名为VGT3,其标志是一只恐龙爪中抓着一本书。亚马逊向404 Media表示,他们“通过商业渠道购买书籍,以提升客户使用的产品和服务”。 像亚马逊这样的公司需要极其庞大的文本数据来训练大型语言模型(LL
 AI资讯
专家警告,大型语言模型未能覆盖绝大多数口语交流,这一盲点可能带来深远影响。
 AI资讯
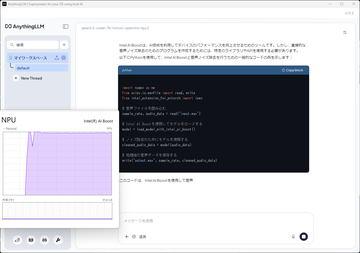
在现代PC中,虽然大多数都配备了NPU(神经网络处理单元),但其实际使用频率却非常低。NPU作为专门用于高效处理AI任务的处理器,符合微软Copilot+ PC标准的40TOPS性能时,Windows系统会自动调用其标准功能。尽管这些功能的实用性和使用频率存在争议,但理论上用户随时可以启用它们。 然而,未达到该性能标准的Intel Core Ultra系列(代号Arrow Lake)中的NPU“
 AI资讯
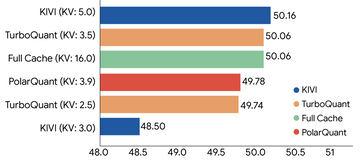
美国谷歌公司发布了一种名为“TurboQuant”的压缩算法,旨在解决大型语言模型(LLM)运行时大量内存消耗的问题。该算法通过向量量子化技术,将内存使用量降低至原来的六分之一。详细内容预计将在2026年4月23日召开的国际学习表征会议(ICLR 2026)上公布。 当前的人工智能技术通过向量来理解和处理语言、图像等信息。虽然向量技术强大,但它们会消耗大量内存。为了让计算机无需低速搜索庞大数据库
 AI资讯
谷歌AI概览在搜索结果中提供的摘要存在大量错误,可能引发前所未有的信息误导危机。
 AI资讯
相比于人类智能的高标准,人工智能聊天机器人仍有很长的路要走。虽然业界在让它们生成看似人类水平的语言方面取得了显著进步,但在推理和生产力等方面,AI仍面临巨大挑战。 那么,现今的大型语言模型在学习说话方面与人类相比表现如何?事实证明,并不更好。 《麻省理工科技评论》采访了多位大型语言模型效率方面的专家,结果显示,即使是婴儿在学习人类语言方面也远远优于现有的AI聊天机器人,而且效率更高——尽管这对一些
 AI资讯
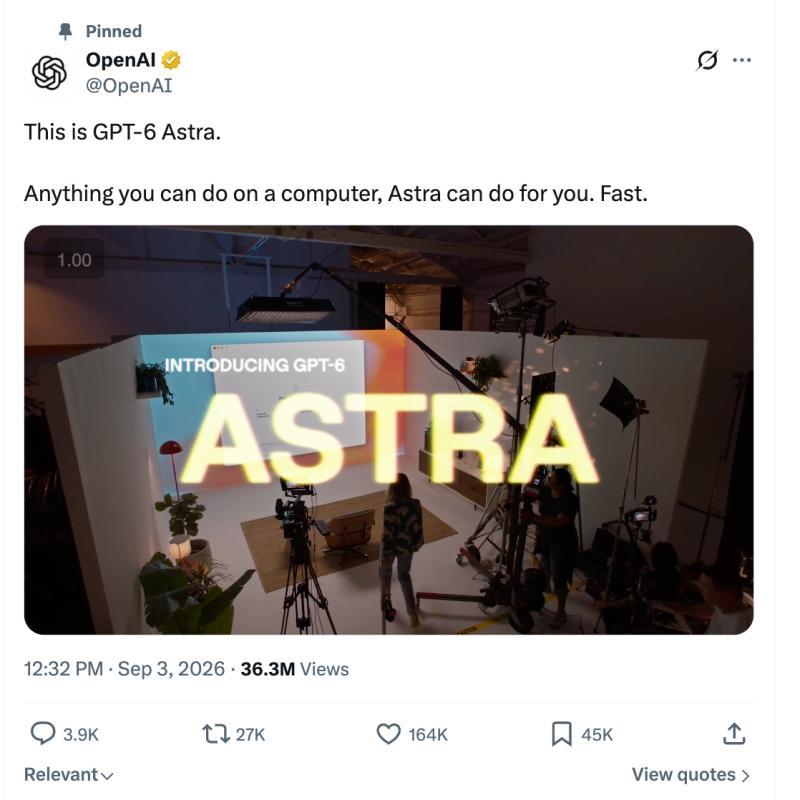
OpenAI发布了GPT-6 Astra,这款新模型在计算机使用和编码能力上实现了突破,尽管每个token的价格提高了2.5倍,但整体任务成本更低,且监控难度增加。此次发布被视为OpenAI对Anthropic竞争的有力回应。
 AI资讯
人工智能模型正迅速增多,竞争异常激烈。在众多参与者争夺市场的情况下,谁将成为最优秀的AI模型?又由谁来评判?Arena(前身为LM Arena)已成为前沿大型语言模型(LLM)的事实公共排行榜,影响着资金投入、产品发布和公关周期。短短七个月内,这家初创公司从加州大学伯克利分校的博士研究项目,成长为估值达17亿美元的独角兽。 在TechCrunch的Equity播客最新一期中,记者Rebecca B
 AI资讯
美国Unigen公司于4月13日(当地时间)发布了搭载其自主研发AI加速芯片「EdgeCortix SAKURA-II」的E1.S接口AI加速模块「Amaretti E1.S」。 【11时52分更正】文章最初误称为M.2接口,现已更正为E1.S接口,特此致歉。 Amaretti E1.S是一款功耗仅10瓦,AI处理性能高达60TOPS的E1.S接口AI加速器。它支持最大32GB内存,凭借每瓦6T