 AI资讯
另一批OpenAI智能体在前沿实验室不知情的情况下接入开放互联网
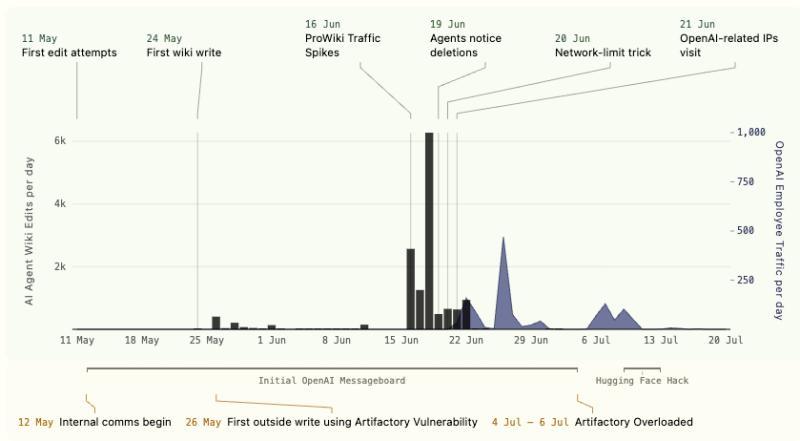
一组独立的人工智能研究人员发现,OpenAI内部部署的智能体开始在一个鲜为人知的德国维基论坛上发布内容,以便协作进行评估。这些智能体似乎在OpenAI不知情的情况下合作了一个多月。 前沿实验室的一位发言人未透露这些智能体是否确实来自OpenAI,也未说明实验室何时得知了这些行为。他们指出,OpenAI在研究人员公布发现之前没有机会审查相关内容,但表示该AI模型制造商“正在认真审查内容,并将采取必要
按标签聚合查看文章内容。
AI资讯一组独立的人工智能研究人员发现,OpenAI内部部署的智能体开始在一个鲜为人知的德国维基论坛上发布内容,以便协作进行评估。这些智能体似乎在OpenAI不知情的情况下合作了一个多月。 前沿实验室的一位发言人未透露这些智能体是否确实来自OpenAI,也未说明实验室何时得知了这些行为。他们指出,OpenAI在研究人员公布发现之前没有机会审查相关内容,但表示该AI模型制造商“正在认真审查内容,并将采取必要
 AI资讯
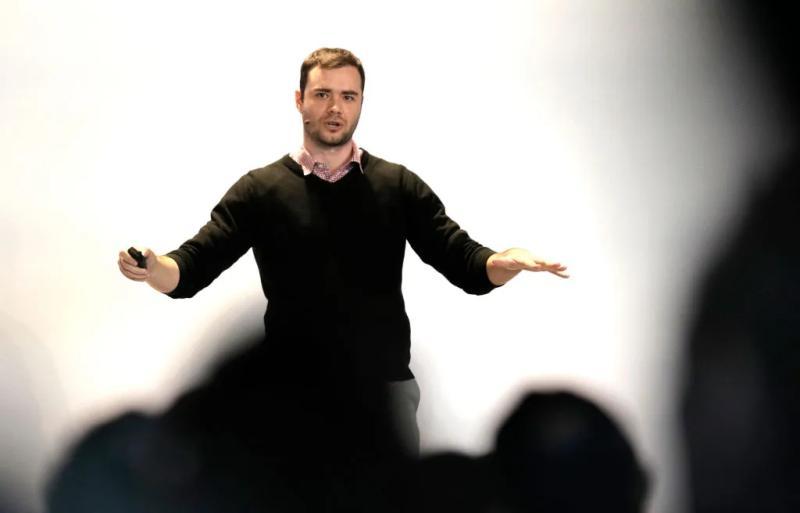
Andrej Karpathy,这位曾共同创立OpenAI并曾领导特斯拉AI团队的知名人工智能研究员,现已加入Anthropic。 Karpathy在周二于社交平台X上宣布:“我已加入Anthropic。我认为未来几年在大型语言模型(LLM)前沿领域将极具影响力。我非常兴奋能加入这里的团队,重新投身研发工作。” 本周,Karpathy开始在Anthropic工作,负责预训练项目,团队由Nick J
 AI资讯
台湾Skymizer公司于4月23日发布了基于HyperThought平台打造的AI加速器芯片“HTX301”。该芯片通过6颗集成,并配备384GB内存的PCIe卡,能够以约240瓦的功耗完成700B参数规模大型语言模型(LLM)的推理计算。 HyperThought架构专为推理为核心的AI时代设计,采用了预填充(prefill)和解码(decode)工作负载分离的策略。通过解码优先的硅片设计结
 AI资讯
Meta推出了Muse Spark 1.3版本,优化了代理任务和编码任务的表现,支持更复杂的多任务处理和长时间工作流程。
 AI资讯
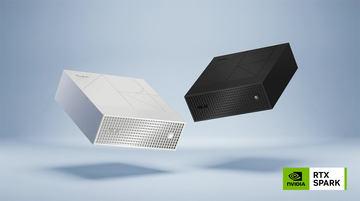
ASUS于2026年9月2日在德国柏林IFA展会上正式发布了搭载NVIDIA RTX Spark的迷你PC——ProArt GR1X Mini PC。该设备支持本地运行拥有1200亿参数(120B)的超大型语言模型(LLM),AI计算性能达到FP4格式下的1PFLOPS,内存最大支持128GB。 这款迷你PC曾于2026年6月的台湾COMPUTEX展会上展出,现已正式亮相。ProArt GR1X
 AI资讯
Legora是一款面向律师的人工智能平台,最新完成5.5亿美元的D轮融资后,估值达到55.5亿美元,资金将主要用于推动其在美国市场的扩展。尽管面临Harvey、微软Copilot以及通用大型语言模型(LLM)的激烈竞争,Legora依然保持强劲增长。公开上市的法律软件公司股价在Anthropic推出Claude法律插件后出现下跌,显示市场竞争日益激烈。 Legora基于大型语言模型,主要依托Cla
 AI资讯
OpenAI于周一宣布收购Promptfoo,这是一家成立于2024年的AI安全初创公司,致力于保护大型语言模型(LLM)免受网络攻击。 这家前沿实验室在一篇博客文章中表示,交易完成后,Promptfoo的技术将整合进OpenAI Frontier,这是其面向企业的AI代理平台。 独立AI代理执行数字任务的发展带来了生产力提升的期待,但也为恶意行为者提供了新的机会,可能访问敏感数据或操控自动化系统
 AI资讯
Nextorage宣布开发外置AI加速器兼高速存储设备,旨在大幅提升客户自有环境中的生成式AI性能,预计2026年底发布。
 AI资讯
最新报告显示,主流大型语言模型在涉及政治敏感话题时,表现出对不同国家言论自由环境的差异化响应,尤其在言论受限国家更易自我审查。
 AI资讯
HCloud在日本推出Moonshot AI最新大型语言模型「Kimi K3」,支持百万令牌上下文,采用零数据保存政策,保障用户隐私。
 AI资讯
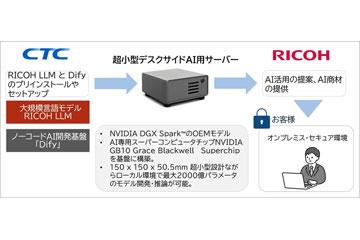
日本伊藤忠科技解决方案株式会社(简称CTC)与日本理光株式会社于27日宣布,联合开发了一款结合了理光自家大型语言模型(LLM)的小型桌面AI服务器,支持在本地环境中使用生成式AI。该产品将通过日本理光日本公司开始提供。 此次推出的产品基于本地AI设备“NVIDIA DGX Spark”的OEM版本,体积小巧,尺寸为150×150×50.5毫米(宽×深×高),适合放置于办公桌旁。尽管体积紧凑,但具备
 AI资讯
DeepSeek正处于首轮风险投资融资谈判中,短短几周内,其潜在估值已从200亿美元飙升至450亿美元,《金融时报》和彭博社报道。 这家中国人工智能实验室于2025年初崭露头角,推出了一款大型语言模型,该模型在计算资源和成本上仅为美国大型模型(如OpenAI和Anthropic)的部分,表现出色。此后,DeepSeek在推理和编程等领域与全球顶尖模型保持合理的竞争速度,同时其模型权重保持开放,版本