 AI教程
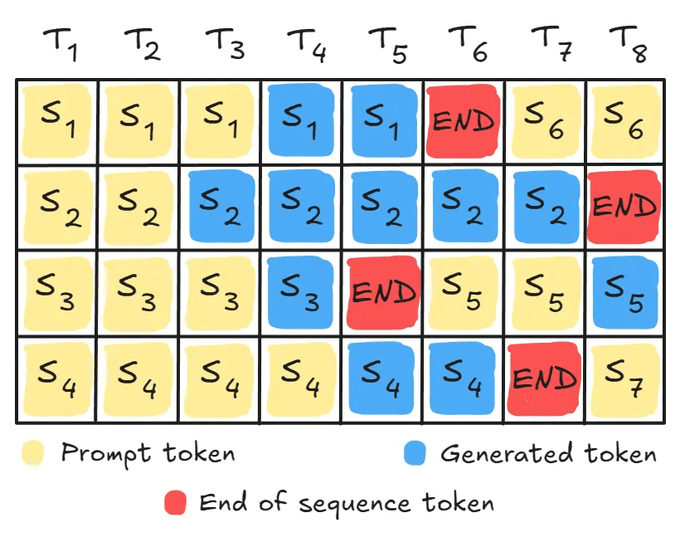
LLM中的连续批处理:调度器如何把吞吐量榨干
vLLM等推理引擎为什么能把同一块GPU的吞吐量拉高到传统方案的数十倍?关键不在模型,而在连续批处理调度器。本文从传统批处理的误区讲起,拆解迭代级调度、选择性批处理和抢占机制背后的真实权衡。
按标签聚合查看文章内容。
AI教程vLLM等推理引擎为什么能把同一块GPU的吞吐量拉高到传统方案的数十倍?关键不在模型,而在连续批处理调度器。本文从传统批处理的误区讲起,拆解迭代级调度、选择性批处理和抢占机制背后的真实权衡。
 AI教程
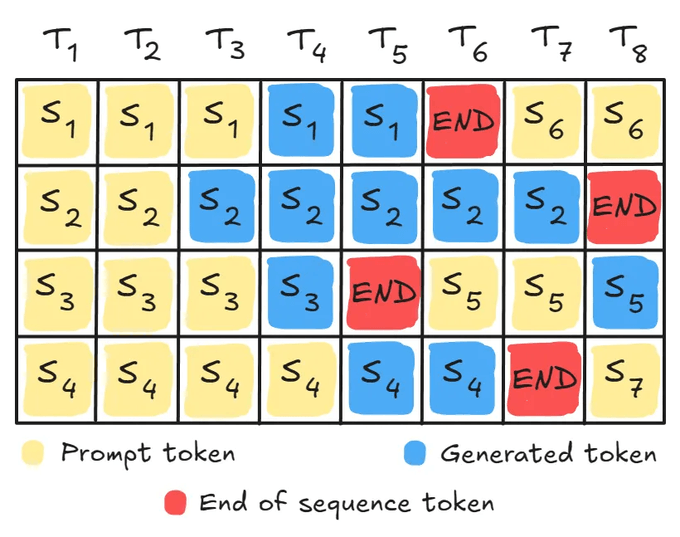
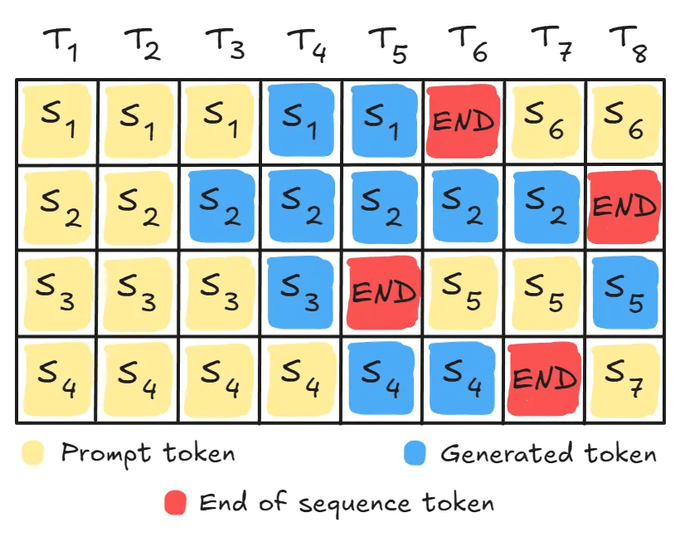
vLLM等推理引擎为什么几乎都默认启用连续批处理?核心在于把“批次”从一次性打包,改成每一步动态重建,让GPU不再为已经结束的请求白白烧显存和算力。本文从传统批处理讲起,拆解连续批处理的调度细节、KV缓存与抢占机制,以及如何用几个关键参数在延迟和吞吐量之间做取舍。
 AI教程
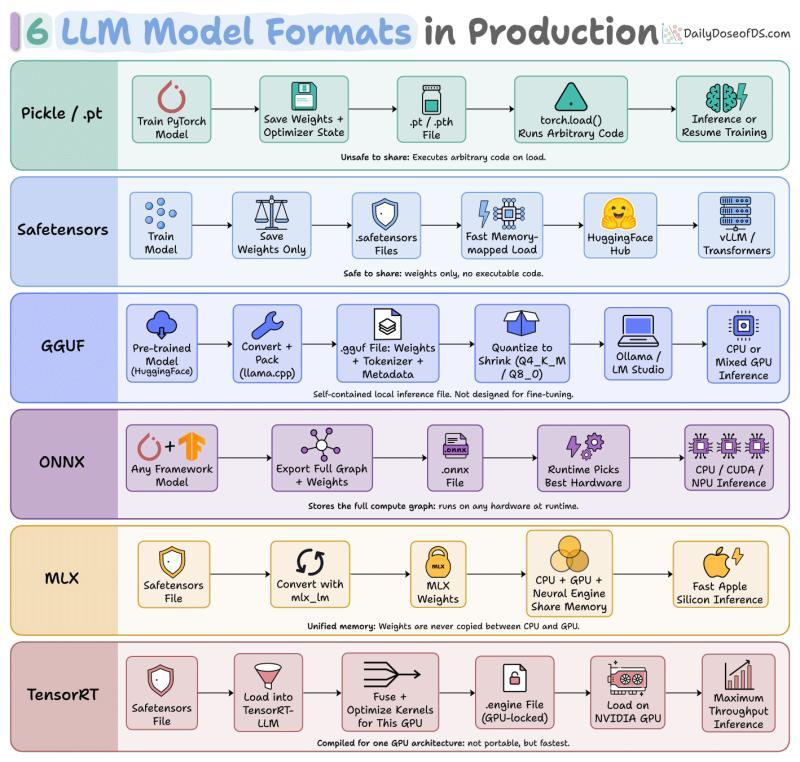
用一篇图解+案例,把生产环境里最常见的6种大型语言模型部署格式讲清楚:从通用到极致加速,每往下一层都是在用速度换兼容性。
 AI教程
推测解码正在悄悄支撑 Google、Anthropic 等巨头的在线服务,让同一模型在数学上输出一致的前提下,速度直接翻倍。本文用直观类比和代码示例,拆解它解决的真实瓶颈、底层机制、实现细节,以及在生产环境中的关键权衡。
 AI教程
很多人以为有了大模型就等于有了应用,但真正难的是模型之上的工程层:检索、上下文管理、评估与可靠性模式。本文用工程视角拆解如何把大语言模型变成可落地、可维护的真实系统。
 AI教程
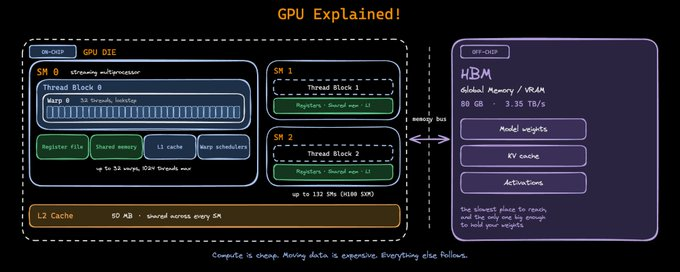
为什么 1 PFLOPS 的 GPU 生成不了 1M token/s?这篇从算术 vs 内存的根本不对称讲起,把批处理、量化、FlashAttention 等技巧串成一个统一直觉框架。
 AI教程
深入拆解Anthropic、OpenAI、Perplexity和LangChain等在生产环境中真正构建的智能体框架,11个核心组件、7个关键架构决策,以及为什么同一个模型在不同框架下表现可以差出一个数量级。
 AI教程
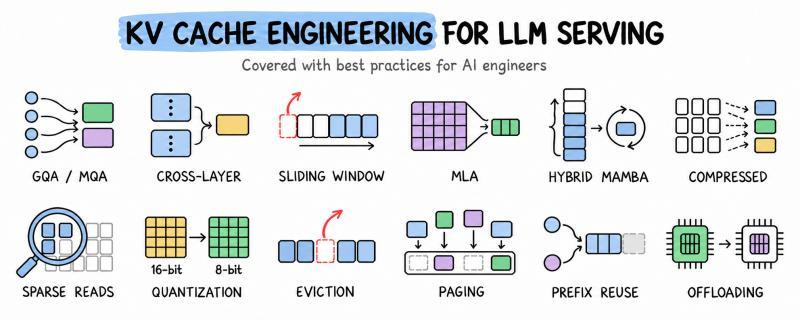
KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串起来,讲清它们各自减的是什么、怎么组合、踩坑在哪。
 AI教程
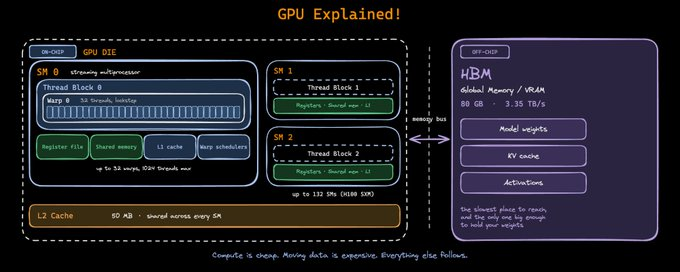
为什么顶级 GPU 标称千万亿次算力,却只能跑出几十 token/s?本文用直观比喻和可算的数字,重建你对 GPU 的系统直觉,让批处理、量化、FlashAttention 等优化从“技巧清单”变成顺理成章的结果。