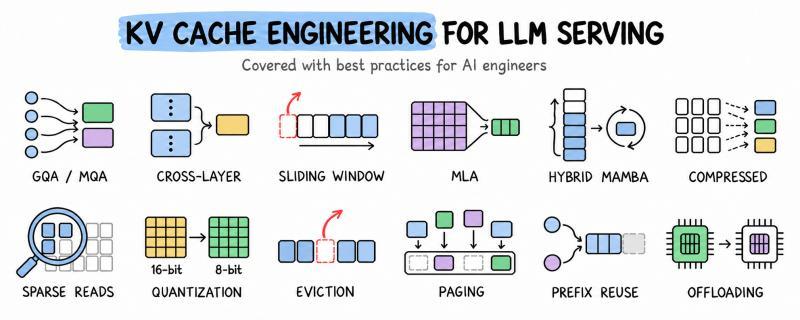
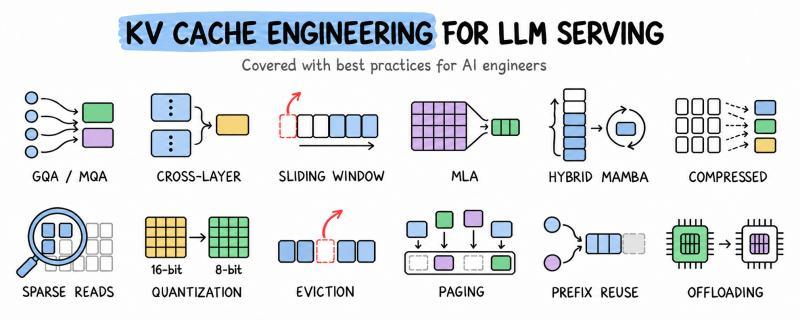
你以为显存只被模型权重吃光,其实很多集群先被 KV 缓存拖垮。很多团队一味上更大 GPU,却没搞清楚缓存到底在浪费哪一块。KV 缓存会随着每个 token 增长、为每条活跃序列单独占坑,如果不做工程减法,很快就会遇到“明明没多少并发,显存却打满”的尴尬场景。
本文把生产环境里常见的 12 种 KV 缓存技术拆开讲:哪些改模型、哪些改存储布局、哪些只改服务引擎。中间会穿插一些真实数据、简单代码片段和踩坑提醒,方便你在自己的系统里落地。
KV 缓存的基本公式
缓存到底在存什么
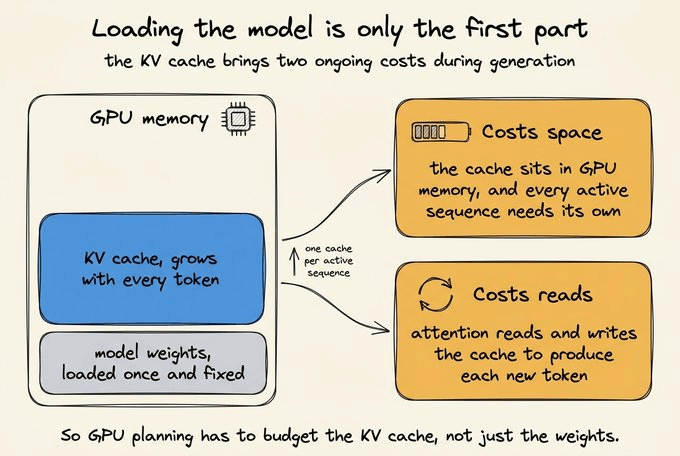
加载 LLM 只是显存规划的起点,推理时真正会“长胖”的是 KV 缓存。模型权重几乎不变,而每个注意力层会为每个保留的 token 存一份 key 和一份 value。
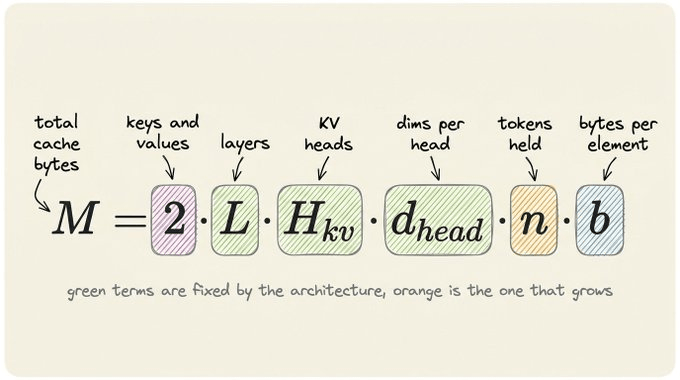
单条序列的原始缓存大小可以抽象成:
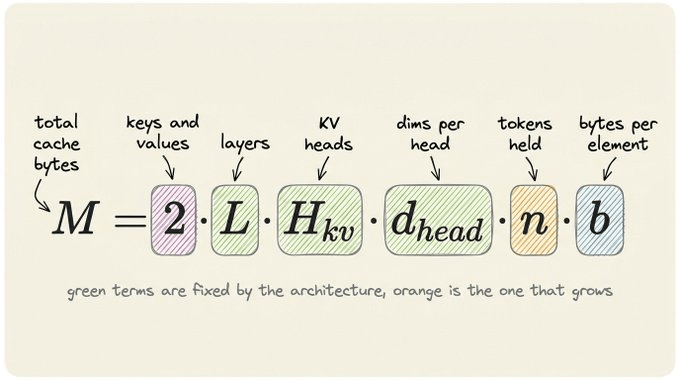
这里的 2 代表 key 和 value 各一份。BF16 每个值 2 字节,FP8 每个值 1 字节。以 Llama 3.1 70B 为例,128K 上下文单序列 BF16 KV 缓存大约 40GB,4 条满长序列就是额外 160GB,还没算权重和服务开销。
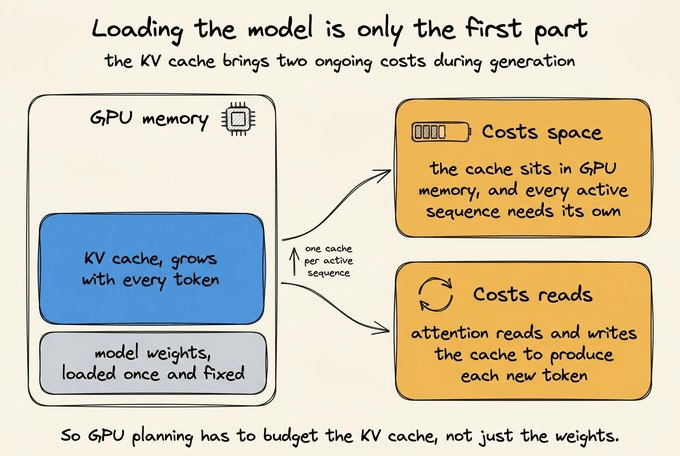
这带来两类成本:一是缓存本身占用 GPU 显存,二是每生成一个新 token,注意力核都要反复把这些缓存从显存读出来。很多人只盯着 FLOPs 优化,却忽略了“内存带宽”这条隐形红线。
据一些云厂商内部数据,长上下文场景下,KV 缓存读写可以占到单次解码时间的 40% 以上,远超很多人直觉。
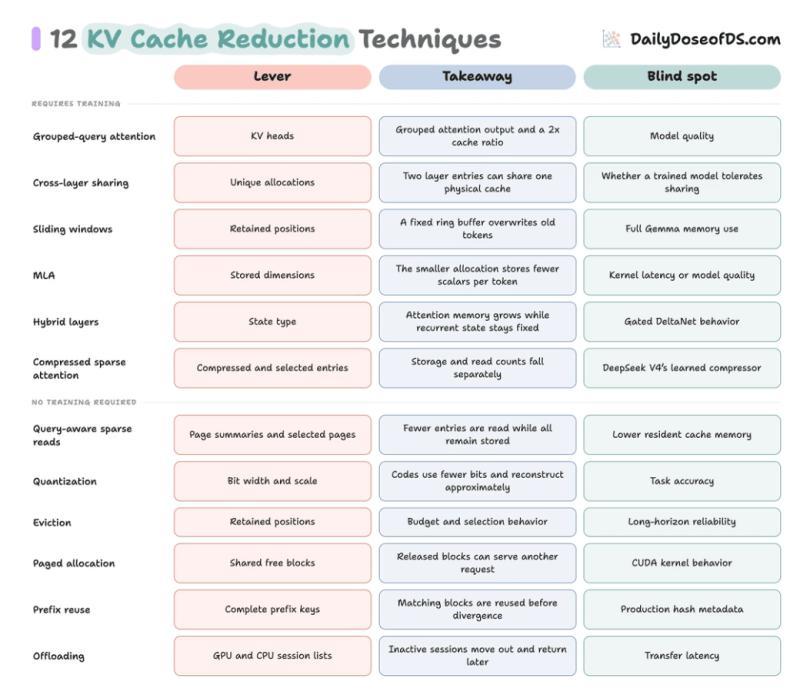
用“公式拆解法”给技术分类
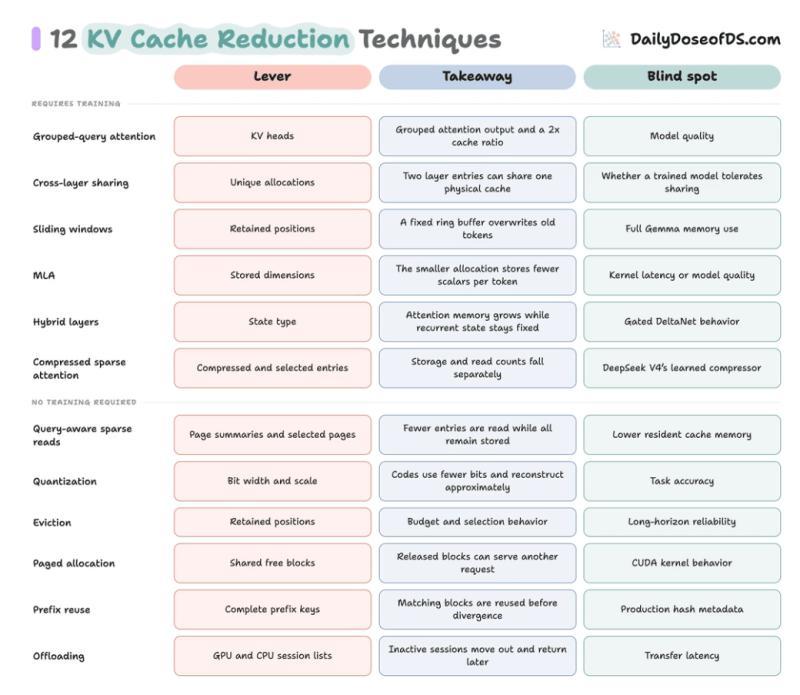
这条公式其实给了我们一个很实用的分类视角:
- GQA / MQA:减少 KV 头数
- 跨层注意力:减少“唯一缓存层”的数量
- 滑动窗口 / 淘汰:减少保留的 token 数
- MLA:缩窄存储表示的维度
- 量化:减少每个值的字节数
- 混合递归层:用固定状态替代增长缓存
- 分页 / 前缀复用:减少分配浪费和重复块
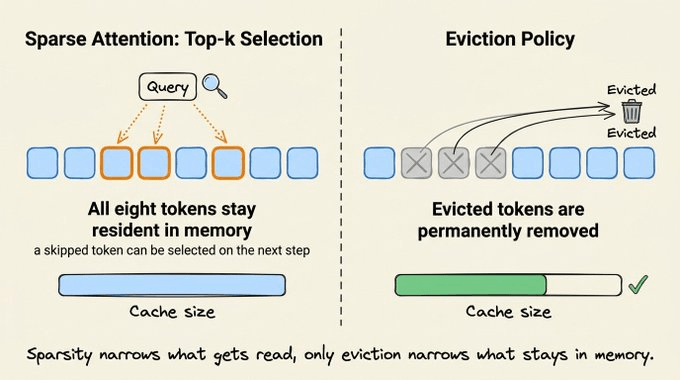
还有一类是“只省算力不省显存”的:稀疏注意力。它可以少读一些 token,降低注意力计算量,但如果不删缓存条目,显存占用不会变小。当 GPU 已经打满时,这个差别非常关键——更快的核函数救不了“显存不够”的问题。
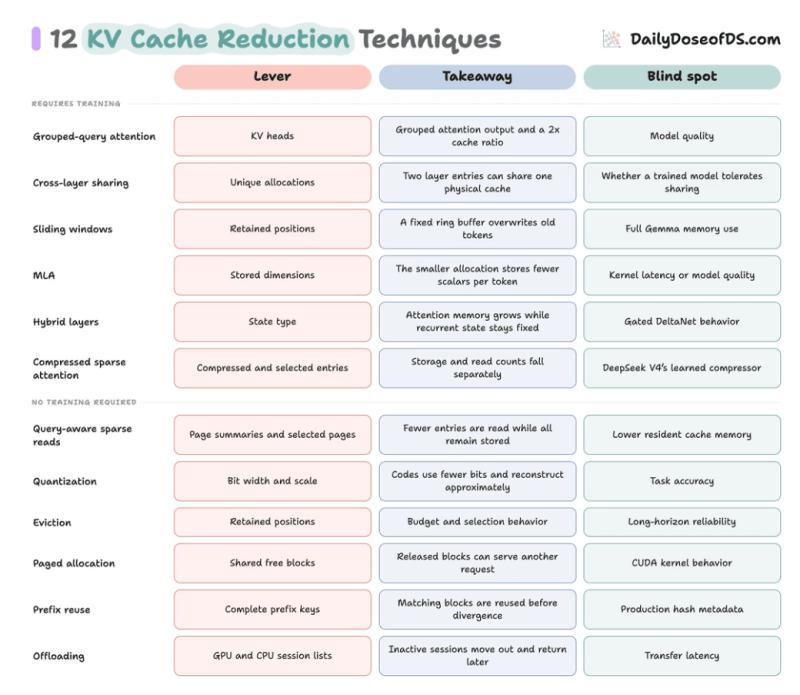
接下来会沿着这个“公式拆解法”,一项一项过这 12 种技术。
从架构下手:头数、层数和表示方式
1. GQA / MQA:把 KV 头数做减法
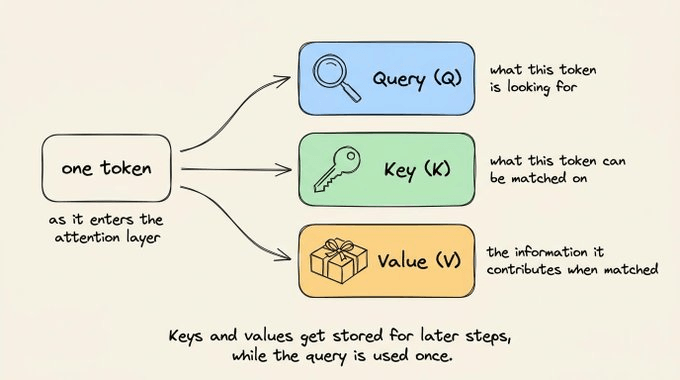
很多人只把“多头注意力”理解成并行算力,其实对 KV 缓存来说,头数就是直接的显存乘数。每个 Transformer 层里,每个 token 会被投影成三种表示:
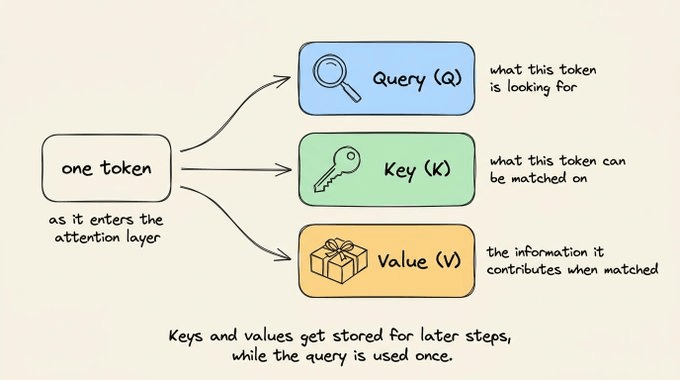
- Query:当前 token 想“查什么”
- Key:每个历史 token 能被“匹配到什么”
- Value:匹配后要返回什么信息
生成时,当前 token 的 query 会和所有缓存的 key 做相似度,得到注意力权重,再加权求和 value。缓存里只保留 key 和 value,不保留 query。
注意力会把这些表示切成多个 head:
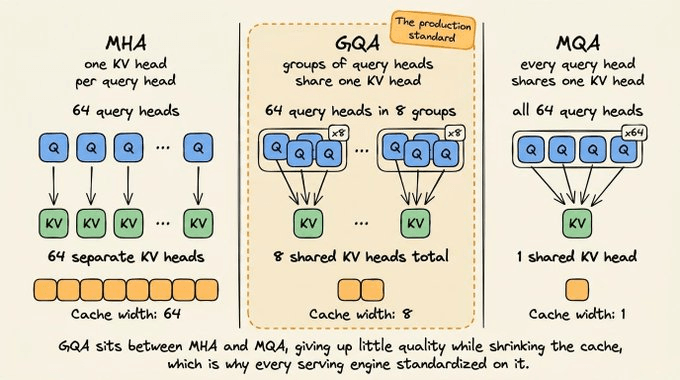
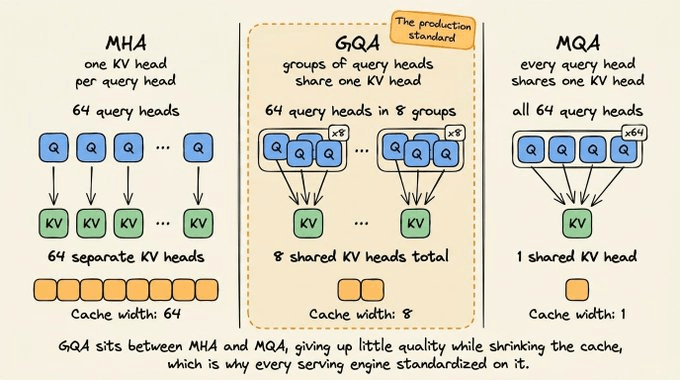
- 标准 MHA:8 个 query 头 → 8 个 key 头 + 8 个 value 头,每层各自维护一整套 KV 缓存
- MQA:保留 8 个 query 头,但只用 1 对 KV,所有 query 共享
- GQA:介于两者之间,比如 8 个 query 头 + 2 个 KV 头,每 4 个 query 共享一对 KV
用一个小脚本感受下缓存规模差异:
query_heads = 8
tokens = 6
head_size = 8
for name, kv_heads in [("MHA", 8), ("GQA", 2), ("MQA", 1)]: queries_per_kv_head = query_heads // kv_heads mapping = [head // queries_per_kv_head for head in range(query_heads)] cached_scalars = 2 * kv_heads * tokens * head_size
print(name, "mapping:", mapping)
print(name, "cached scalars:", cached_scalars)
""" MHA mapping: [0, 1, 2, 3, 4, 5, 6, 7] MHA cached scalars: 768 GQA mapping: [0, 0, 0, 0, 1, 1, 1, 1] GQA cached scalars: 192 MQA mapping: [0, 0, 0, 0, 0, 0, 0, 0] MQA cached scalars: 96 """
映射数组说明每个 query 头对应哪个 KV 头。MHA 完全一一对应,GQA 4 个 query 头共享一个 KV 头,MQA 所有 query 头共享同一个 KV 头。缓存计数里已经把 key 和 value 都算进去了。
Llama 3.1 70B 采用 64 个 query 头 + 8 个 KV 头,128K 上下文时 KV 缓存约 40GB。如果粗暴用 64 个 KV 头,缓存会膨胀到 320GB,这在生产上几乎不可用。
GQA 论文里提到,用原始预训练算力的约 5% 做恢复训练,就能让 GQA 模型在质量上接近 MHA,同时速度接近 MQA,这类“头数减法”非常适合在模型设计阶段就考虑进去。
2. 跨层注意力:层与层之间也共享 KV
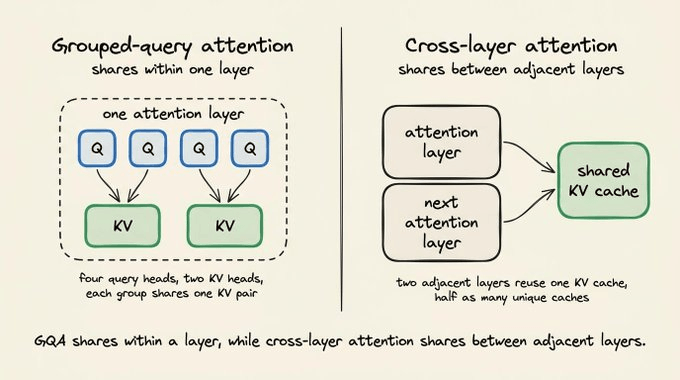
GQA 在“单层内部”共享 KV,跨层注意力(Cross-Layer Attention, CLA)则把共享关系拉到了“相邻层之间”。
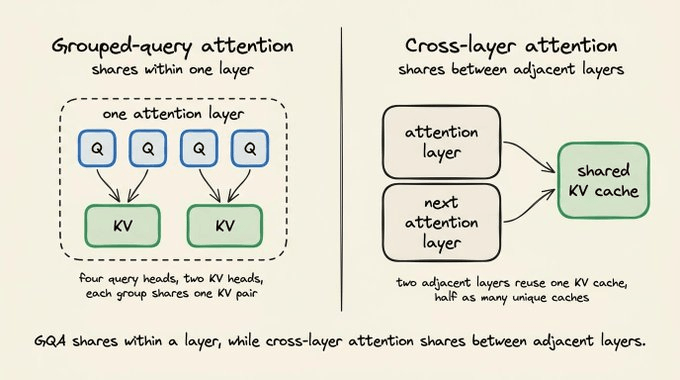
共享因子为 2 时,两层共用一份 KV 缓存,模型里“唯一缓存层”的数量直接减半。论文在 1B 和 3B 模型上实验,报告 KV 再减半的同时,准确率接近 MQA 基线。
用一个极简例子看下内存效果:
tokens = 32
kv_heads = 2
head_size = 8
one_layer_cache = 2 * tokens * kv_heads * head_size shared_cache = {"stored_scalars": one_layer_cache} layer_caches = [shared_cache, shared_cache]
separate_total = 2 * one_layer_cache shared_total = shared_cache["stored_scalars"]
print("layers point to same cache:", layer_caches[0] is layer_caches[1]) print("two separate layer caches:", separate_total, "scalars") print("one shared layer cache:", shared_total, "scalars")
""" layers point to same cache: True two separate layer caches: 2048 scalars one shared layer cache: 1024 scalars """
两层如果各自存一份缓存,总共 2048 个标量;指向同一个对象时,物理上只存 1024 个。CLA 可以和 GQA 叠加:GQA 先减少每层 KV 头数,CLA 再减少“有自己缓存”的层数。
风险在于:标准检查点里,每层都有独立的 KV 投影权重,强行把缓存重定向到别层会直接改模型计算路径。CLA 必须在训练阶段就设计好,推理引擎也要按同样的所有权关系管理缓存,不能指望“运行时开个开关”就自动生效。
3. 滑动窗口:只让一部分层“记得住很久”
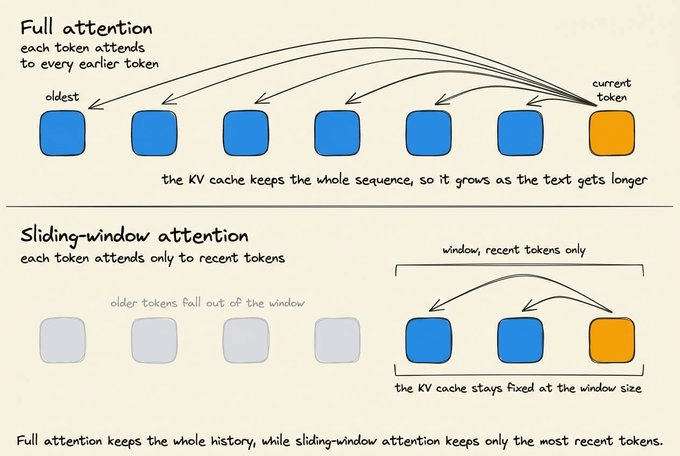
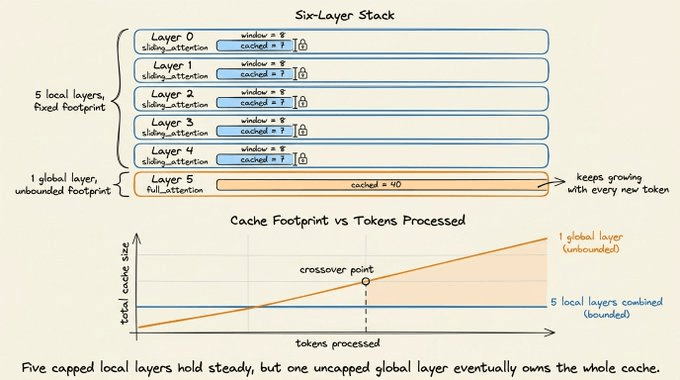
有些团队一看长上下文,就默认所有层都要全局注意力,其实这很浪费。滑动窗口注意力的思路是:只让部分层关注最近的一小段上下文,其余远程依赖交给少数“全局层”。
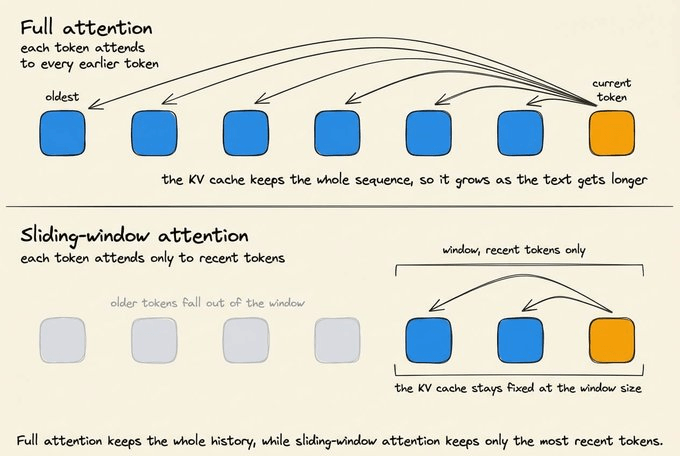
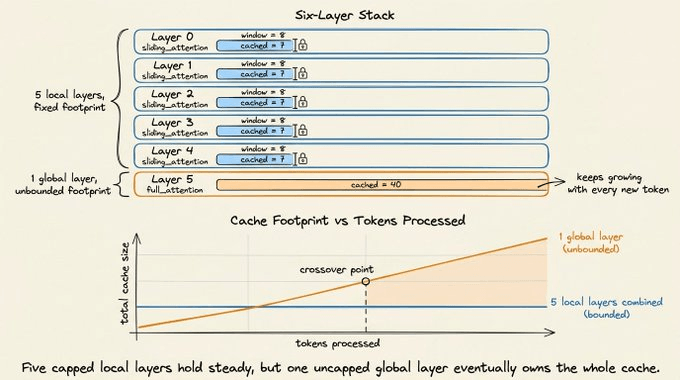
局部层只保留最近 W 个 token 的 KV,新 token 到来时,最旧的被淘汰,缓存大小固定。全局层仍然能看到整个历史,缓存随序列增长。
Gemma 3 就采用了“5 个局部层 + 1 个全局层”的循环结构,局部窗口 1024,全局层支持到 128K 上下文:
一个小脚本展示窗口如何滑动:
window_size = 4
retained_positions = []
for position in range(10): retained_positions.append(position) if len(retained_positions) > window_size: retained_positions.pop(0)
print(f"after token {position}: {retained_positions}")
print("maximum retained positions:", window_size)
""" after token 0: [0] after token 1: [0, 1] after token 2: [0, 1, 2] after token 3: [0, 1, 2, 3] after token 4: [1, 2, 3, 4] after token 5: [2, 3, 4, 5] after token 6: [3, 4, 5, 6] after token 7: [4, 5, 6, 7] after token 8: [5, 6, 7, 8] after token 9: [6, 7, 8, 9] maximum retained positions: 4 """
生产里通常会用环形缓冲区覆盖旧槽位,而不是移动数组。窗口没被填满前,滑动窗口和全注意力保留的 token 数是一样的,一旦超过窗口长度,局部层的缓存就“封顶”了。
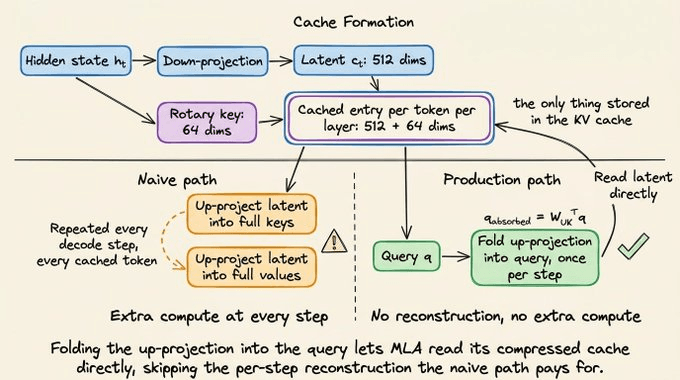
4. MLA:把 KV 变成“潜在表示”再存
多头潜在注意力(MLA)的思路有点像“先压缩再存盘”。它不为每个头直接缓存完整的 key 和 value,而是把隐藏状态压缩成更小的潜在向量,真正存的是这个 latent 表示。
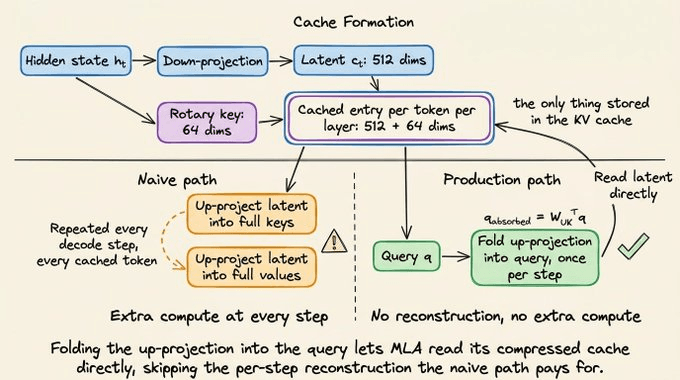
解码时,模型用学习到的投影把 latent 还原成注意力需要的信息。部分投影可以吸收到 query 和输出路径里,这样在显存里就不必重建完整 KV 张量。
DeepSeek-V2 引入 MLA 后,据公开数据,相比 DeepSeek 67B,KV 缓存减少约 93.3%,最大生成吞吐提升 5.76 倍。
用一个玩具例子看下“每 token 存多少标量”的差异:
kv_heads = 4
head_size = 8
standard_keys = kv_heads * head_size # 32
standard_values = kv_heads * head_size # 32
standard_total = standard_keys + standard_values
mla_latent = 8
mla_rotary_key = 4
mla_total = mla_latent + mla_rotary_key
print("standard cache:", standard_keys, "key +", standard_values, "value") print("MLA cache:", mla_latent, "latent +", mla_rotary_key, "rotary key") print("stored scalars per token:", standard_total, "->", mla_total) print(f"example reduction: {standard_total / mla_total:.2f}x")
""" standard cache: 32 key + 32 value MLA cache: 8 latent + 4 rotary key stored scalars per token: 64 -> 12 example reduction: 5.33x """
这里标准注意力每 token 存 64 个标量,示例 MLA 只存 12 个,缩减比例非常夸张。当然,真实模型的 latent 维度和位置编码维度会不一样。
需要强调的是,MLA 不是一个“推理时随手打开”的选项,它改变了注意力的数学形式,必须在训练阶段就设计好,推理引擎也要支持对应的缓存布局。
5. 混合递归层:用固定状态替代增长缓存
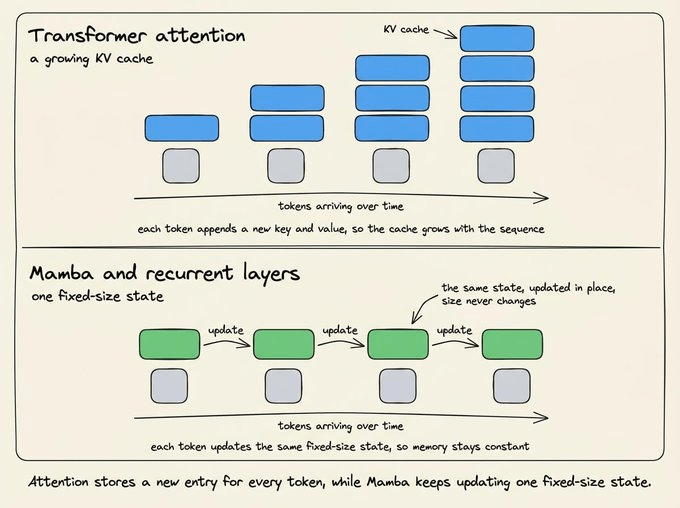
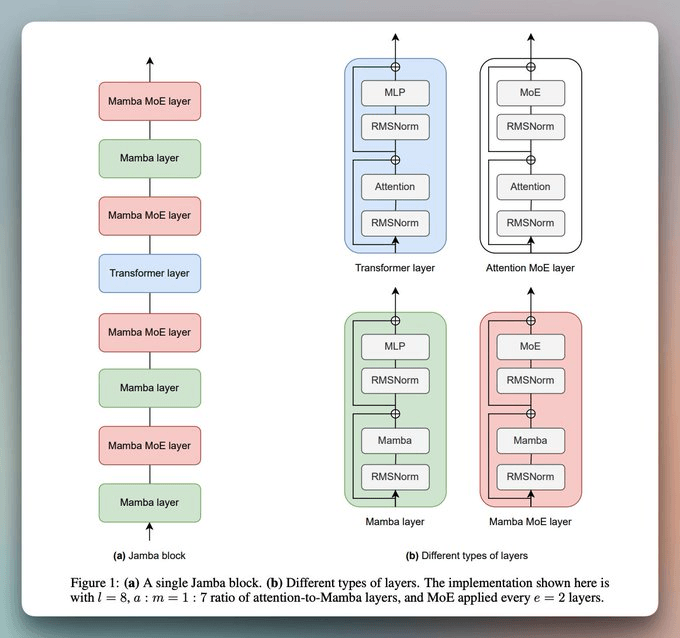
如果你看过 Mamba 或 DeltaNet,会发现它们几乎不需要随上下文线性增长的缓存。递归线性注意力类层只维护一个固定大小的状态,随着序列推进不断更新,而不是为每个历史 token 存一条 KV。
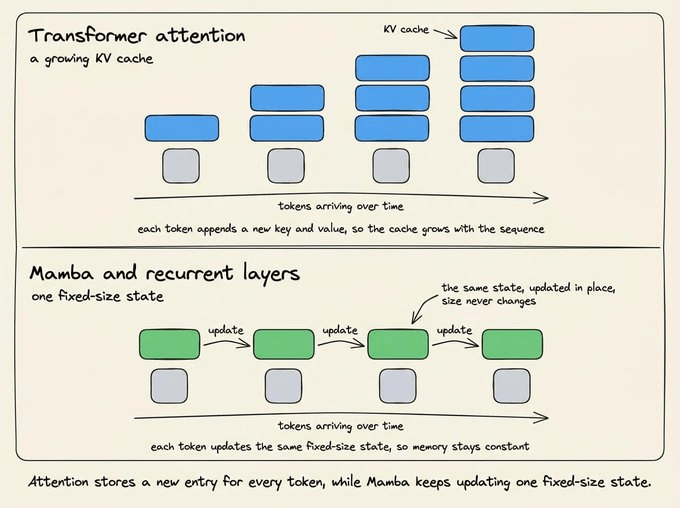
纯递归模型在内存上很省,但在精确检索远程信息上往往不如全注意力。近期的主流做法是混合:用少量全注意力层负责“精确长程记忆”,其余层用递归结构。
比如 Qwen3-Next:48 层被分成 12 个重复块,每块里有 3 个 Gated DeltaNet 层 + 1 个全注意力层,只有 12 层会产生随上下文增长的 KV 缓存。官方卡片里提到,这些注意力层有 16 个 query 头、2 个 KV 头、头维度 256。
下面这个例子只对比内存增长:
width = 64
bytes_per_value = 4
attention_values_per_token = 2 * width # key + value
recurrent_state_values = width * width
for tokens in [128, 4096]: attention_kb = tokens * attention_values_per_token * bytes_per_value // 1024 recurrent_kb = recurrent_state_values * bytes_per_value // 1024
print(f"{tokens} tokens")
print("  attention KV:", attention_kb, "KB")
print("  recurrent state:", recurrent_kb, "KB")
""" 128 tokens attention KV: 64 KB recurrent state: 16 KB 4096 tokens attention KV: 2048 KB recurrent state: 16 KB """
注意力缓存随 token 数线性增长,递归状态大小不变。示例没实现 Mamba 或 Gated DeltaNet 的更新规则,只是展示“增长 vs 固定”的对比。
Qwen3-Next 的 12 个全注意力层,在 128K 上下文下需要约 3GB BF16 KV 缓存,如果 48 层全是注意力,增长部分会到 12GB。Jamba 的设计类似:1 个注意力层 + 7 个 Mamba 层交替,256K 上下文时 KV 缓存约 4GB,而 Mixtral 则在 32GB 量级。
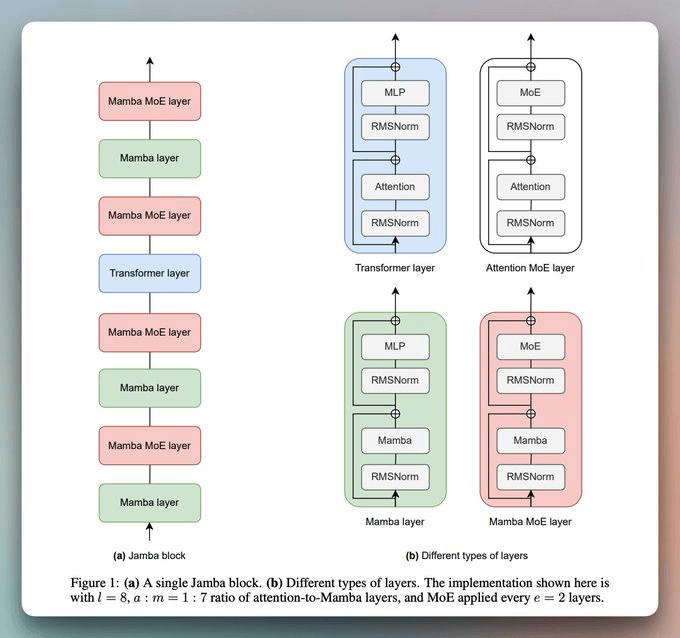
这种混合布局同样是训练时决定的,推理引擎不能在运行时随意把注意力层替换成递归层,否则模型就变成另一个模型了。
只改“读写方式”:稀疏读取与量化
6. 压缩稀疏注意力:既少存又少读
全注意力有两件贵的事:
- 为每个 token 存一条 KV
- 每步解码都把所有 KV 读一遍
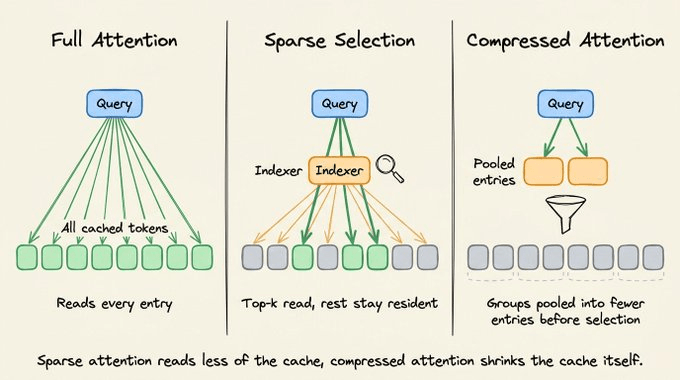
普通稀疏注意力只优化第二件事——少读一些条目,但缓存还是全量存着。压缩稀疏注意力则两头都动手:
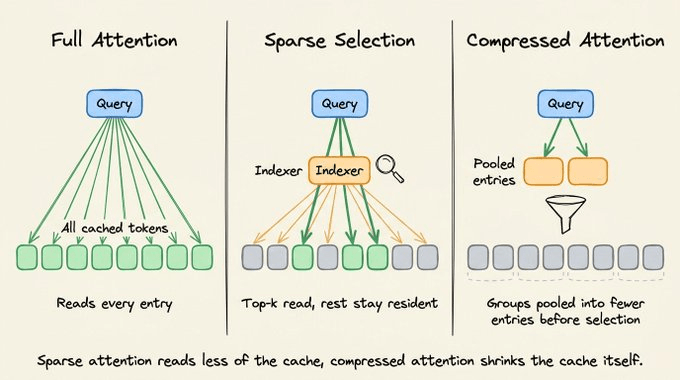
- 先把相邻的多个 token 合并成一个“压缩条目”,存储的是短序列
- 再用一个选择器,从这些压缩条目里挑出最相关的少数参与注意力
DeepSeek V4 系列采用了这类设计。压缩因子为 m 时,每 m 个 token 合成 1 个存储条目,n 个 token 只会产生约 n/m 个压缩条目,再从中选 k 个参与注意力,同时配一个小滑动窗口保留最近 token 的细节。
据公开数据,在百万 token 上下文下,DeepSeek-V4-Pro 的 KV 缓存约为全注意力的 10%,单 token 推理 FLOPs 约为 27%;V4-Flash 更激进,KV 约 7%,FLOPs 约 10%。
用一个极简例子把“存多少”和“读多少”拆开看:
full_token_entries = 32
tokens_per_group = 4
selected_entries = 2
compressed_entries = full_token_entries // tokens_per_group
print("full token entries:", full_token_entries) print("compressed entries stored:", compressed_entries) print("compressed entries read:", selected_entries) print("storage reduction:", f"{full_token_entries / compressed_entries:.0f}x")
""" full token entries: 32 compressed entries stored: 8 compressed entries read: 2 storage reduction: 4x """
32 个 token 合成 8 个压缩条目,存储减少 4 倍;每步只读其中 2 个,注意力计算也大幅下降。真实实现会再叠加局部窗口,保证最近上下文的细节不丢。
需要提醒的是,这类技术同样是“模型级”的,服务引擎没法靠改缓存参数,把一个全注意力模型硬生生变成压缩稀疏注意力模型。
7. 查询感知稀疏读取:Quest 式“只读有希望的页”
有时候你没法改模型架构,但又确实想少读点 KV。Quest 提供了一个很工程化的折中:不删缓存,只是更聪明地决定“这一 token 该读哪些页”。
核心做法:
- 把缓存切成很多“页”,每页是一小段连续 token 的 KV
- 为每页维护一个摘要,比如 key 的最小值和最大值
- 每个新 query 先和这些摘要算一个“上界分数”,只把得分最高的少数几页真正加载进 GPU 做注意力
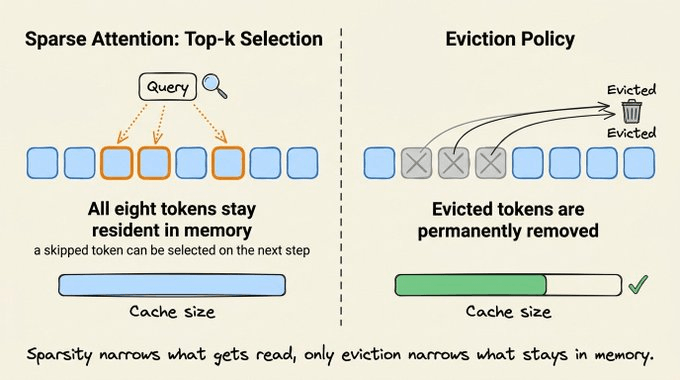
Quest 论文报告,自注意力延迟可降到原来的约 1/7,整套推理系统加速约 2.23 倍。
一个二维玩具例子:
import numpy as np
pages = np.array([ [[1, 0], [2, 1]], [[5, 1], [4, 2]], [[0, 6], [1, 5]], [[-2, -1], [-1, 0]], ]) query = np.array([1.0, 0.5])
page_min = pages.min(axis=1) page_max = pages.max(axis=1) page_scores = np.maximum(query * page_min, query * page_max).sum(axis=1) selected_pages = np.argsort(page_scores)[-2:]
for page, score in enumerate(page_scores): print(f"page {page} score: {score:.1f}")
print("selected pages:", np.sort(selected_pages).tolist()) print("KV entries read:", len(selected_pages) * 2, "of", pages.size // 2) print("KV entries still stored:", pages.size // 2)
""" page 0 score: 2.5 page 1 score: 6.0 page 2 score: 4.0 page 3 score: -1.0 selected pages: [1, 2] KV entries read: 4 of 8 KV entries still stored: 8 """
这里一共有 8 个 key,按页算摘要后,query 更偏好数值大的 key,于是页 1 和 2 得分最高,只读这 4 个 key。注意最后一行:读的是 4 条,但 8 条都还在缓存里。
我自己在做长上下文检索实验时,类似的“页级预筛选”确实能明显减轻显存带宽压力,不过具体收益和 key 分布、页大小关系很大,这一点我也不太确定是不是所有模型都一样。
8. 量化:用更少的位存同样的 KV
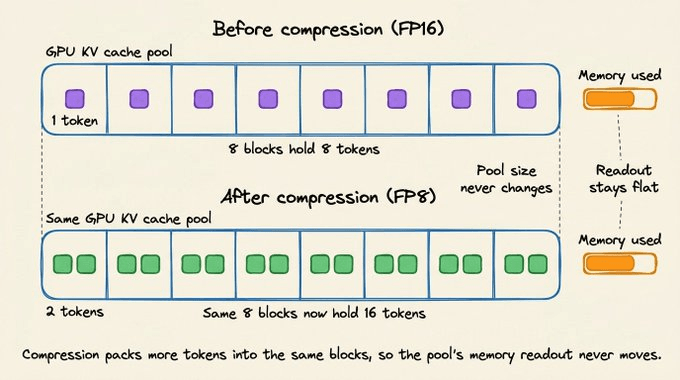
Quest 只减少“读多少”,量化则是减少“每个数字占多少位”。KV 通常用浮点数存,BF16 是 16 位,FP8 是 8 位,如果能把缓存从 BF16 换成 FP8,原始数据量大约减半;更激进的 4 位格式甚至能压到 25%。
量化的基本套路是:
- 找到一组缩放因子,把原始浮点值映射到较小的整数集合
- 存储这些小整数 + 缩放元数据
- 解码时再乘回缩放,得到近似值
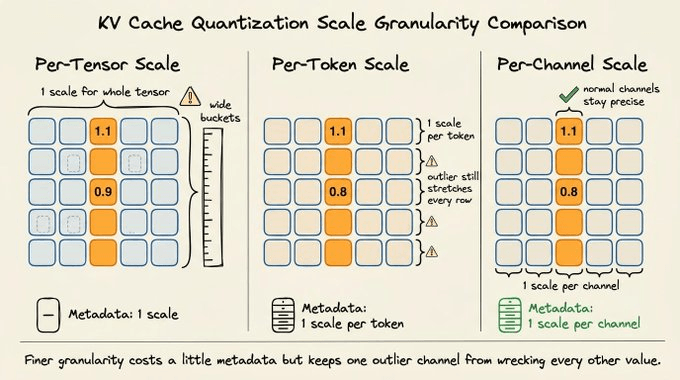
缩放怎么分组很关键。KIVI 的做法是:
- key:按通道分组(跨 token 的同一特征)
- value:按 token 分组
论文报告,用 2 位缓存时,峰值 KV 内存可降约 2.6 倍,批大小提升约 4 倍。
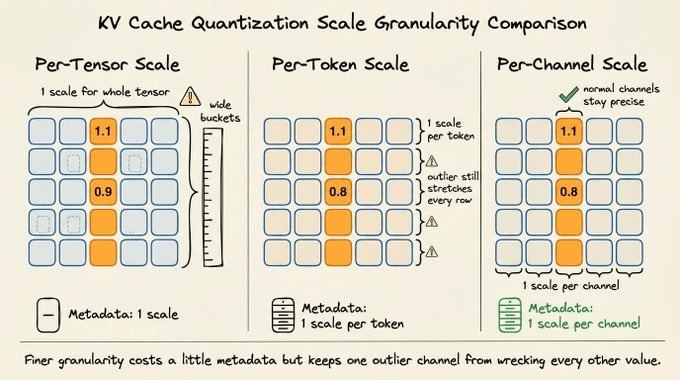
一个 4 位玩具例子:
import numpy as np
values = np.array([-1.0, -0.55, -0.10, 0.25, 0.60, 1.0]) bits = 4 largest_code = 2 ** (bits - 1) - 1 scale = np.max(np.abs(values)) / largest_code
codes = np.rint(values / scale) codes = np.clip(codes, -largest_code, largest_code).astype(np.int8) restored = codes * scale
print("original values:", values.tolist()) print("4-bit codes:", codes.tolist()) print("restored values:", np.round(restored, 3).tolist()) print("raw payload:", len(values) * 16, "bits ->", len(values) * 4, "bits")
""" original values: [-1.0, -0.55, -0.1, 0.25, 0.6, 1.0] 4-bit codes: [-7, -4, -1, 2, 4, 7] restored values: [-1.0, -0.571, -0.143, 0.286, 0.571, 1.0] raw payload: 96 bits -> 24 bits """
可以看到,还原值和原值接近但不完全一样,这就是量化误差。真实缓存还要额外存缩放因子等元数据。
vLLM 已经支持直接用 FP8 存 KV:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct
vllm serve "$MODEL_ID" --kv-cache-dtype fp8
新版本里还可以对部分层跳过量化,比如滑动窗口层对 FP8 更敏感时:
MODEL_ID=google/gemma-3-4b-it
vllm serve "$MODEL_ID" \
  --kv-cache-dtype fp8 \
  --kv-cache-dtype-skip-layers sliding_window
我有一次在内部环境里给一个长上下文模型开 FP8 KV,发现整体吞吐提升接近 1.7 倍,但在极端长文档问答上会出现少量召回错误,后来就只对部分层量化,效果会更稳一点。
直接删位置:淘汰与预算控制
9. 淘汰:给 KV 一个“位置预算”
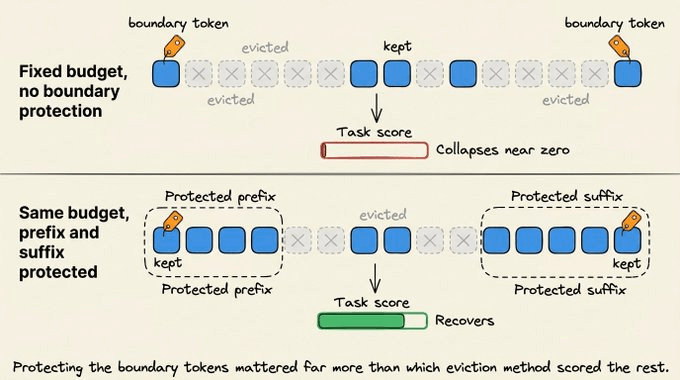
量化虽然省了字节,但所有 token 位置还在,长上下文下显存依然可能爆。淘汰(eviction)的核心是:给缓存一个固定的位置预算,超出的就丢掉。
难点是:哪些位置可以扔?
- 最近的 token 通常很重要,承载当前对话
- 很早的 token 里可能藏着系统指令、事实知识、工具调用结果,后面还会用到
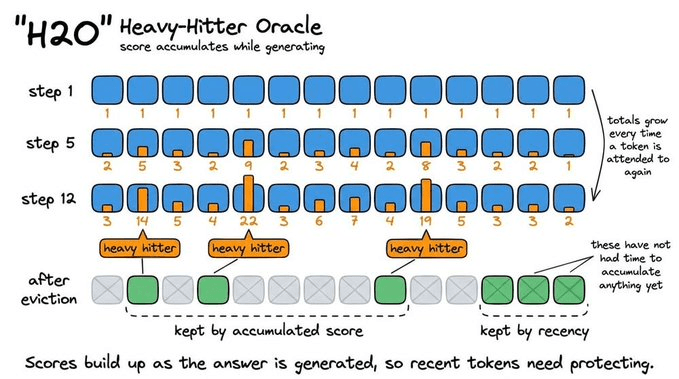
H2O 的做法是保留两类 token:
- 最近的一段(比如最后 N 个)
- 历史上“重击者”(heavy hitters):在之前注意力里累计权重很高的 token
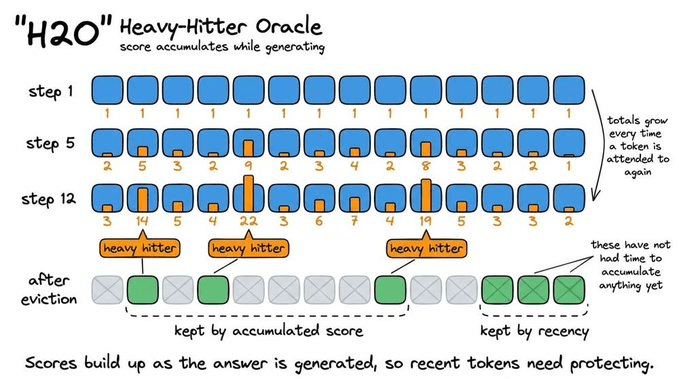
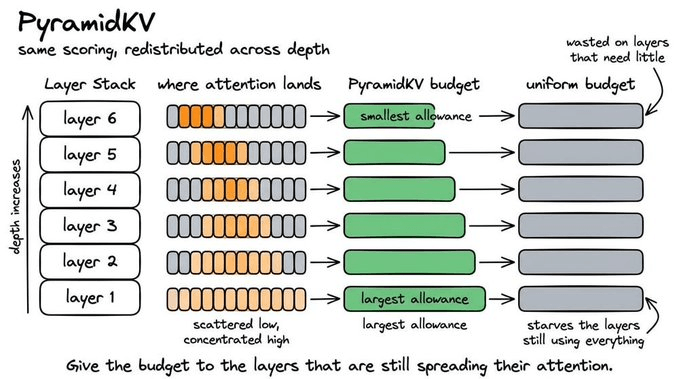
SnapKV 则更多关注输入末端的注意力模式,提前选出“关键提示位置”;PyramidKV 会给低层更多预算、高层更少预算:
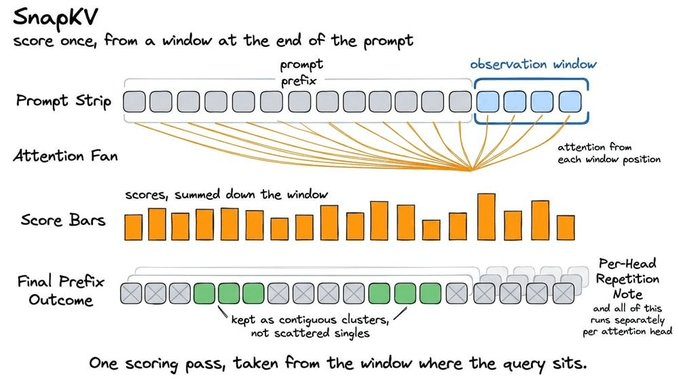
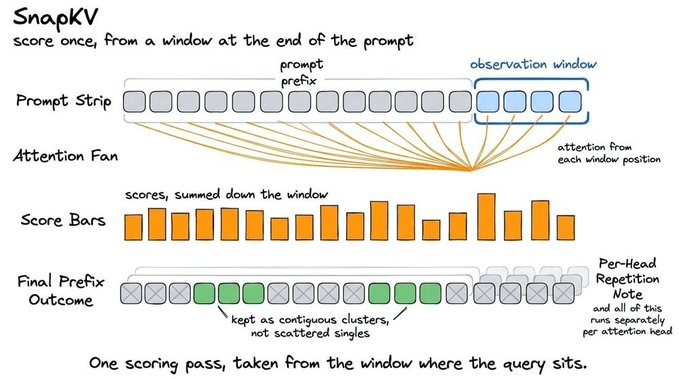
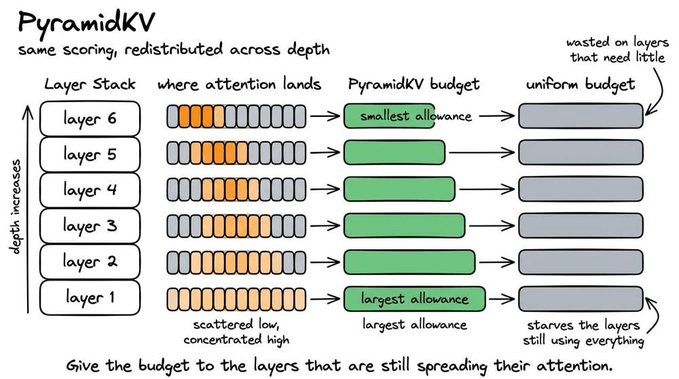
据公开实验,SnapKV 在 16K 输入上内存效率提升约 8.2 倍,生成速度提升约 3.6 倍;PyramidKV 在 LongBench 上只保留约 12% 的缓存,性能仍接近全缓存。
一个 H2O 风格的玩具例子:
scores = [9.0, 0.2, 4.0, 0.1, 0.3, 6.0, 0.2, 0.4, 0.1, 0.2] budget = 6 recent_count = 2
positions = list(range(len(scores))) recent = positions[-recent_count:] older = positions[:-recent_count]
heavy_hitter_count = budget - recent_count heavy_hitters = sorted( older, key=lambda position: scores[position], reverse=True, )[:heavy_hitter_count]
retained = sorted(heavy_hitters + recent)
print("heavy hitters:", sorted(heavy_hitters)) print("recent positions:", recent) print("retained positions:", retained) print("cache entries:", len(retained), "of", len(scores))
""" heavy hitters: [0, 2, 5, 7] recent positions: [8, 9] retained positions: [0, 2, 5, 7, 8, 9] cache entries: 6 of 10 """
位置 8、9 因为“最新”被保留,剩余 4 个名额给分数最高的 0、2、5、7,1、3、4、6 被淘汰。真实 H2O 会在生成过程中持续更新这些分数。
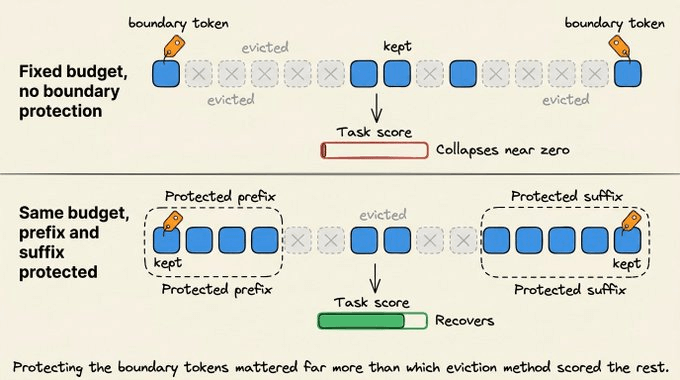
风险也很现实:工具调用结果、系统指令、用户早期的偏好描述,可能在后面几轮突然变得关键。评估时不能只看单轮问答,要用完整代理轨迹和延迟引用场景来压测,否则很容易在“看起来没问题”的基准下埋雷。
服务引擎视角:分页、前缀复用与卸载
10. 分页:把显存切成小块再分配
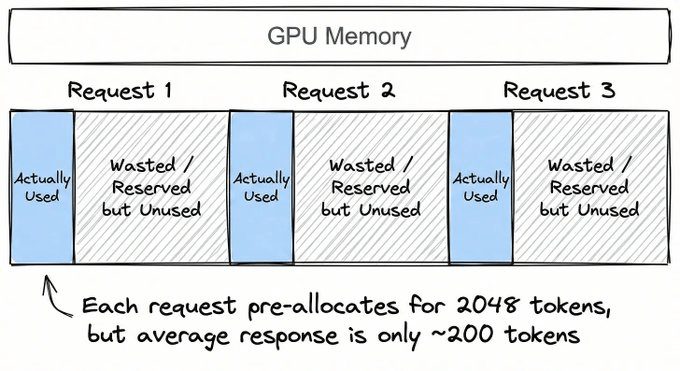
前面的技术大多关注“单条序列的缓存长什么样”,分页(PagedAttention)则解决另一个工程问题:在多请求并发时,怎么把 GPU 缓存池切得更细、更好用。
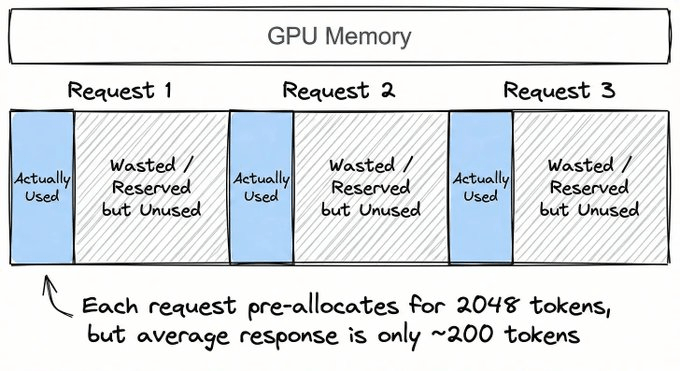
简单分配器的做法是:
- 每个请求预留一大块连续显存
- 通常按最大长度预留,短请求浪费空间
- 请求结束后,空洞会导致碎片化
PagedAttention 的做法是:
- 把 GPU KV 缓存切成很多等大小的块
- 每块存固定数量 token 的 KV
- 每个请求可以拿任意若干块,不要求连续
请求结束后,块立刻回到共享池,其他请求可以复用。论文报告几乎零缓存浪费,整体吞吐能提升 2–4 倍。
一个极简分配示例:
free_blocks = [0, 1, 2, 3, 4, 5]
request_a = free_blocks[:3] free_blocks = free_blocks[3:]
request_b = free_blocks[:2] free_blocks = free_blocks[2:]
free_blocks.extend(request_a) free_after_a = free_blocks.copy() request_c = free_blocks[:2] free_blocks = free_blocks[2:]
print("request A blocks:", request_a) print("request B blocks:", request_b) print("free after A finishes:", free_after_a) print("request C blocks:", request_c)
""" request A blocks: [0, 1, 2] request B blocks: [3, 4] free after A finishes: [5, 0, 1, 2] request C blocks: [5, 0] """
C 请求拿到的是块 5 和 0,物理上不连续,但逻辑顺序由块表记录。vLLM 会在内部维护“块 → 请求”的映射,注意力核可以按逻辑顺序访问这些非连续块。
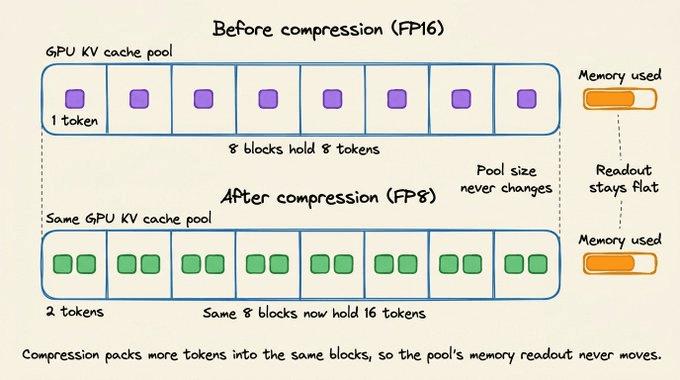
有个容易被忽略的点:如果你的引擎预先为 KV 池分配了固定大小,比如 8GB,那么即便你把 KV 换成 FP8,nvidia-smi 上看到的显存占用也不会变小,只是同样 8GB 里能塞进更多 token 而已。
11. 前缀复用:多请求共享同一段开头
分页解决的是“请求结束后怎么复用块”,前缀复用(prefix caching)则让多个活跃请求在“相同开头”上共享 KV。
典型场景:
- 统一的系统提示
- 一大段工具定义 / API schema
- 模板化的 few-shot 示例
如果没有前缀缓存,每个请求都会重复计算并存储这段 KV,既浪费显存,也浪费预填充时间。
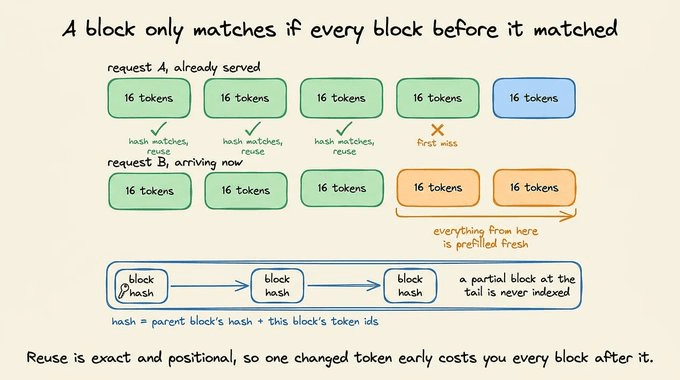
自动前缀缓存的做法是:
- 每个完成的前缀块生成一个查找键
- 后续请求如果有相同前缀,就直接指向已有 KV 块
- 从分歧点开始再新算后续 token
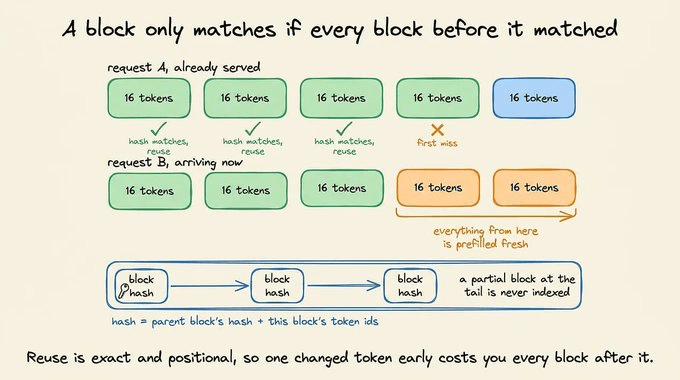
vLLM 在构造查找键时,会把“当前块 + 之前所有块”的 token 序列,以及适配器 ID 等信息都编码进去,避免误匹配。
一个 4-token 块的玩具例子:
def prefix_keys(tokens, block_size): block_ends = range(block_size, len(tokens) + 1, block_size) return [tuple(tokens[:end]) for end in block_ends]
first = [10, 11, 12, 13, 20, 21, 22, 23, 30, 31, 32, 33] second = [10, 11, 12, 13, 20, 21, 22, 23, 40, 41, 42, 43]
cache = set() first_keys = prefix_keys(first, block_size=4) first_hits = sum(key in cache for key in first_keys) cache.update(first_keys)
second_keys = prefix_keys(second, block_size=4) second_hits = sum(key in cache for key in second_keys)
print("first request reused:", first_hits, "of", len(first_keys), "blocks") print("second request reused:", second_hits, "of", len(second_keys), "blocks") print("second request computes:", len(second_keys) - second_hits, "new block")
""" first request reused: 0 of 3 blocks second request reused: 2 of 3 blocks second request computes: 1 new block """
第二个请求的前 8 个 token 和第一个完全一致,所以复用了 2 个块,只为最后 4 个 token 计算了 1 个新块。
有用户反馈,在统一了系统提示模板、固定工具 JSON 字段顺序之后,前缀缓存命中率从个位数飙到 60% 以上,预填充延迟直接砍半。
需要注意的是,前缀复用依赖“精确分词前缀”。系统提示里的时间戳、随机空格、工具模式里 JSON 键顺序的变化,都会让本该命中的前缀变成“看起来很像但其实不一样”。
12. GPU 缓存卸载:把“冷 KV”搬到 CPU
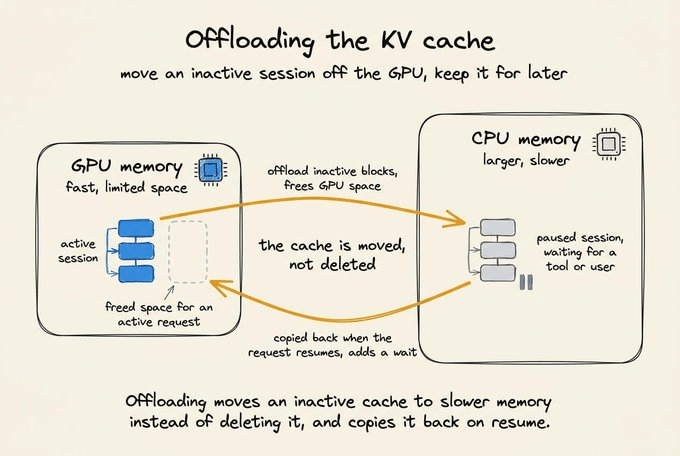
前缀复用解决的是“重复前缀别算两遍”,卸载(offloading)解决的是另一个现实问题:有些 KV 暂时用不到,但你又不想删掉它。
典型场景:
- 调度器把某些长会话挂起,优先服务短请求
- 为了前缀复用,保留了一大堆系统提示 KV
卸载的做法是:
- 把暂时不用的 KV 块从 GPU 拷到更大的内存层(通常是 CPU 内存)
- 真正需要恢复时,再从 CPU 拷回 GPU
整体 GPU+CPU 占用不变,只是把“冷数据”挪到便宜的地方。代价是恢复时的传输延迟。
一个极简示例:
gpu_cache = ["cache-a", "cache-b"] cpu_cache = []
C 到来,需要 GPU 空间,把 A 卸载到 CPU
cpu_cache.append(gpu_cache.pop(0)) gpu_cache.append("cache-c")
print("GPU after cache C arrives:", gpu_cache) print("CPU after cache C arrives:", cpu_cache)
A 再次需要,拉回 GPU,把 B 卸载
cpu_cache.remove("cache-a") cpu_cache.append(gpu_cache.pop(0)) gpu_cache.append("cache-a")
print("GPU after cache A returns:", gpu_cache) print("CPU after cache A returns:", cpu_cache)
""" GPU after cache C arrives: ['cache-b', 'cache-c'] CPU after cache C arrives: ['cache-a'] GPU after cache A returns: ['cache-c', 'cache-a'] CPU after cache A returns: ['cache-b'] """
真实引擎会用块 ID 而不是字符串,并维护“会话 → 块列表”的映射。需要强调一点:OpenAI 兼容 API 的一次请求结束后,服务端不会自动帮你“记住” KV,后续请求想复用,得靠引擎内部的会话管理或你自己做外部存储。
vLLM 里可以直接开一个 16GB 的 CPU 卸载缓冲区:
MODEL_ID=Qwen/Qwen2.5-7B-Instruct

vllm serve "$MODEL_ID" \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
有团队在多轮对话机器人上试过,开启卸载后,同一张卡能同时挂起更多长会话,但如果 CPU 内存和带宽不足,恢复时的抖动会比较明显,需要压测后再上线。
怎么组合这些技术
从“想减哪一项”倒推方案
回到一开始那条缓存公式,不同技术减的是不同的项:
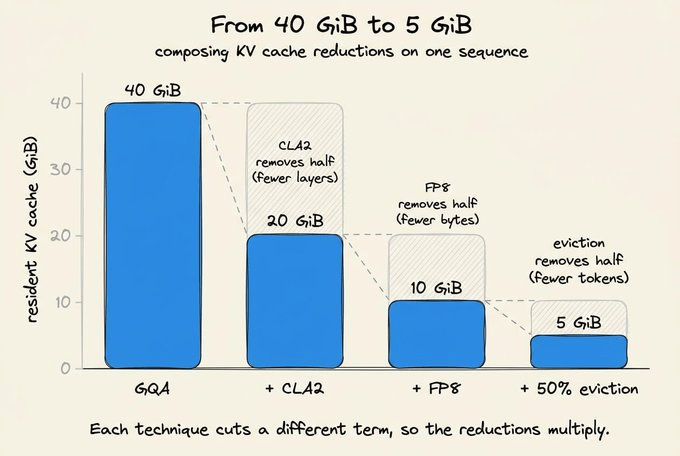
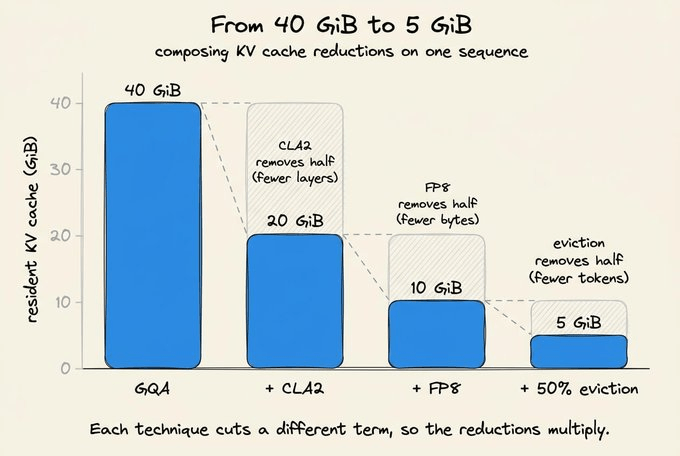
以 Llama 3.1 70B 的 40GB GQA 缓存为例,可以这样做“乘法减法”:
- 用 CLA2(两层共享一份 KV)把唯一层数减半 → 约 20GB
- 把 KV 存储从 BF16 换成 FP8 → 约 10GB
- 再加一个 50% token 预算的淘汰策略 → 约 5GB
听上去很美,但这里面藏着不少工程和质量风险:
- CLA / MLA / 混合递归层:都需要在训练阶段设计,不能指望推理时魔改
- FP8 / 低比特量化:会引入量化误差,部分任务上会掉点
- 淘汰:直接丢上下文,长对话和工具调用场景风险更大
- 稀疏读取 / Quest:主要省的是带宽和延迟,不一定省显存
有用户反馈,在没做任何评估的情况下直接开激进淘汰,短期看吞吐翻倍,结果一周后被客服投诉“机器人老是忘事”,最后不得不回滚。
不同场景下的实用决策
可以用一个简单的“决策清单”来选技术:
- 选模型阶段:
- 看 KV 头数、本地 vs 全局层比例、是否有 MLA / 混合递归层
- 这些决定了“天然的缓存基线”,比事后优化更关键
- 已有模型要提效:
- 先试 FP8 KV + 规范系统提示模板,保证不丢 token
- 再考虑前缀复用,把重复前缀的浪费收回来
- 淘汰策略只在特定工作负载上压测通过后再开
- 显存占用没变但吞吐变好了:
- 检查 KV 池容量和块数,固定池可能掩盖了量化带来的节省
- 真正省的是“每块能装多少 token”,而不是“池本身多大”
- 延迟瓶颈明显:
- 用 profiler 分离“注意力计算时间”和“KV 读取时间”
- 如果后者占比高,可以考虑 Quest 式稀疏读取
- 大量“挂起会话”占着 GPU:
- 优先考虑卸载 + 更聪明的调度
- 冷会话搬到 CPU,给活跃会话留显存,往往比继续压缩 KV 更划算
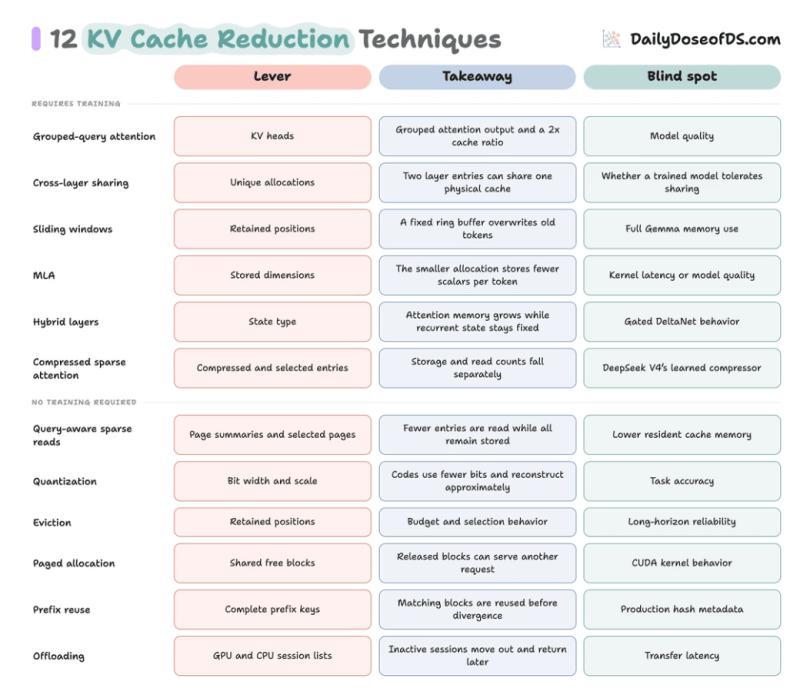
如果你能先说清楚“我现在最想减的是:头数 / 层数 / token 数 / 位数 / 重复块 / 带宽哪一项”,KV 缓存的优化路线会清晰很多。
这一套判断方法在不同项目里反复验证过,挺值得收藏下来,等你下次在 nvidia-smi 前发愁的时候翻出来对照一下。如果你正准备上线一个长上下文或多轮对话系统,这些决策往往比问身边人“要不要上更大卡”更有用。
常见问题
Q:怎么判断该先做量化还是先做淘汰?
A:如果你的主要问题是“显存不够,但任务对细节很敏感”,优先考虑量化而不是淘汰。量化在不删 token 的前提下压缩每个值的位宽,对大多数问答和代码生成任务来说,轻量的 FP8 或 8bit KV 对质量影响有限,而淘汰会直接丢掉上下文,长对话和工具调用场景风险更大。实操上,可以先在预生产环境对关键业务指标做 AB 测试:先开 FP8 KV,观察召回率、错误率变化;如果质量稳定,再评估是否需要在极端长上下文下叠加温和的淘汰策略。
Q:前缀复用命中率一直很低,可能是什么原因?
A:命中率低通常不是引擎问题,而是“前缀不够稳定”。前缀缓存依赖精确的分词序列,系统提示里如果包含时间戳、随机 ID、动态文案,或者工具 JSON 字段顺序经常变化,就会导致看起来相似的请求在 token 级别完全不同。建议先做两件事:一是把系统提示和工具定义模板化、版本化,避免无意义的随机变化;二是用日志抽样几百条请求,对比它们的 token 序列前缀是否真的一致。命中率提升后,再考虑调大前缀缓存池,否则容易白白占用显存。
Q:开启 FP8 KV 缓存会不会让模型“变笨”?
A:FP8 会引入量化误差,但影响程度和模型结构、任务类型、实现细节都有关。经验上,纯文本问答、聊天类任务对 KV 精度相对不那么敏感,而代码生成、长文档精细检索更容易暴露问题。判断时可以按任务拆分评估:选一批代表性用例,分别在 BF16 和 FP8 KV 下跑对比,关注长上下文引用、工具调用参数准确性等细节。如果发现个别层特别敏感,可以像 vLLM 那样只对部分层量化,比如跳过滑动窗口层或最靠近输出的几层,以换取更稳的质量。
Q:什么时候应该考虑用卸载,而不是继续压缩 KV?
A:当你的 GPU 显存主要被“挂起会话”和前缀缓存占满,而活跃请求本身并不长时,卸载往往比继续压缩更划算。压缩 KV(量化、淘汰)会影响所有请求的精度或复杂度,而卸载只影响那些暂时不在解码的会话。可以先用监控看两件事:一是活跃解码请求的平均上下文长度,二是 GPU KV 池里有多少块长时间未被访问。如果后者占比很高,就适合把这些冷块搬到 CPU。上线前要压测恢复延迟和 CPU 带宽,避免在高并发恢复时出现明显抖动。
Q:如何评估淘汰策略不会“悄悄”伤害业务?
A:单纯看困惑度或单轮问答准确率不够,需要构造贴近真实的多轮轨迹和延迟引用场景。可以从生产日志里抽取一批完整对话,包括工具调用、系统指令变更、长文档问答等,然后在“全缓存”和“带淘汰”的配置下重放,比较几个指标:工具参数错误率、对早期事实的引用准确率、用户主观评分变化等。同时要关注极端长对话和复杂工具链路,因为淘汰往往在这些场景里才真正触发。评估通过后,再逐步扩大覆盖范围,并保留回滚开关,以防线上出现难以预料的长尾问题。


