 AI教程
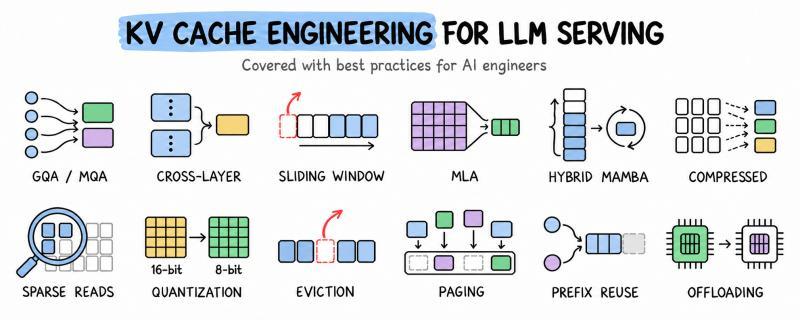
LLM 服务里的 KV 缓存:12 种工程减法
KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串在一起,讲清它们各自减的是什么、怎么组合、以及在真实生产环境里的坑和取舍。
按标签聚合查看文章内容。
AI教程KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串在一起,讲清它们各自减的是什么、怎么组合、以及在真实生产环境里的坑和取舍。
 AI资讯
谷歌推出TurboQuant技术,通过压缩KV缓存,有效解决大语言模型推理中的内存瓶颈问题,显著降低内存使用且不损失准确率,提升处理长文本和复杂任务的效率。