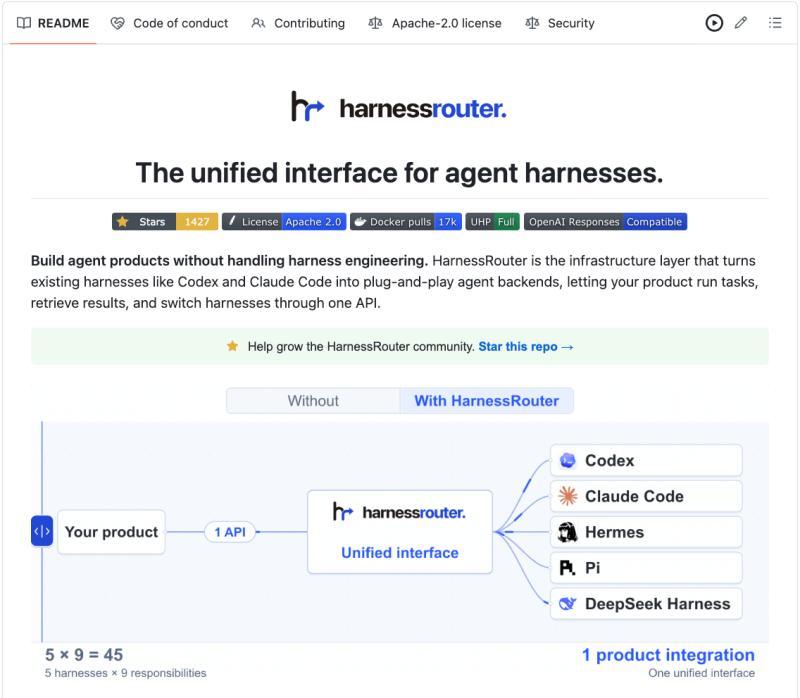
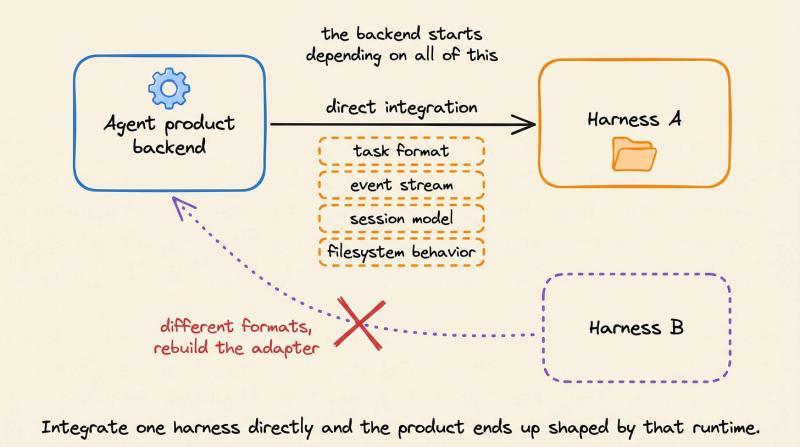
 99% 的团队在接入第一个代理执行框架时,都以为只是“多调一个 API”。真正踩过坑才发现,一旦深度集成,你的产品后端就被它的任务格式、事件流、会话模型和文件系统行为牢牢绑死。想换一个运行时,不是改个配置,而是半个系统要跟着重写。要想摆脱这种技术锁定,就得从一开始就把“执行框架路由”当成一等公民来设计。
为什么要在同一个产品里支持多个执行框架
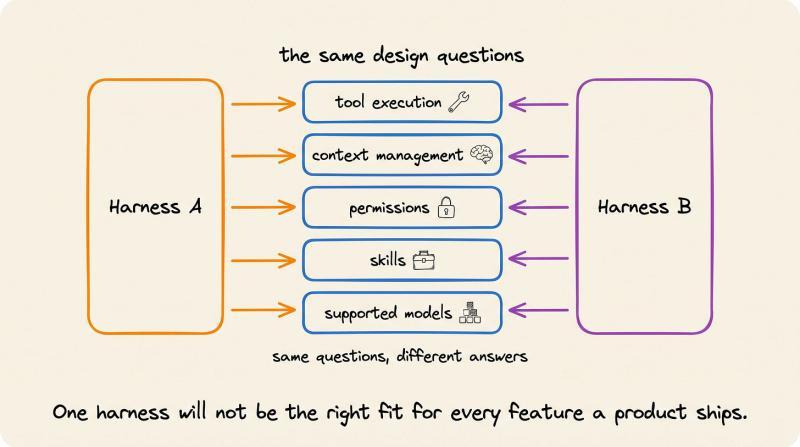
不同执行框架,做的是同一件事却走完全不同的路
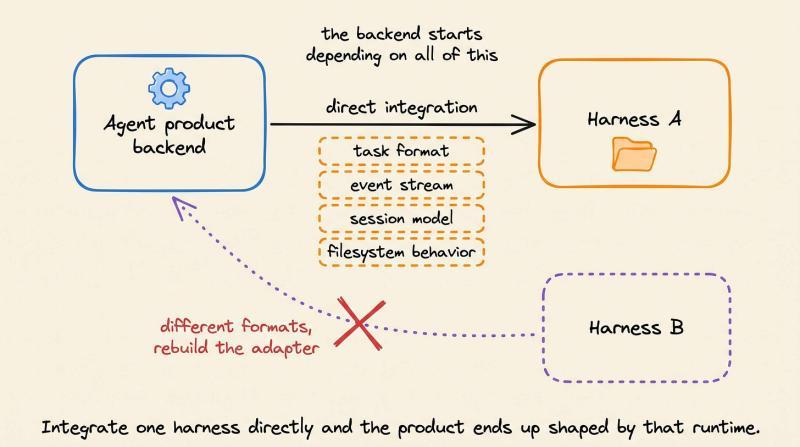 很多人只看到“模型不一样”,却忽略了执行框架在工具执行、上下文管理、权限模型、技能体系和文件操作上的巨大差异。一个框架可能偏向代码编辑和命令行操作,另一个则更擅长长文档分析和多轮推理。单一执行框架往往无法覆盖产品里所有功能场景,比如代码助手、数据分析、文档问答,对工具和模型的要求完全不同。有用户反馈,在同一产品中,代码相关任务用 Codex 成功率更高,而长文档解释用 Claude Code 更稳定。要让产品真正“按任务选最合适的运行时”,就必须把这些差异抽象在统一接口之下。
多云、多模型、配额与故障:现实环境逼你多备几套后端
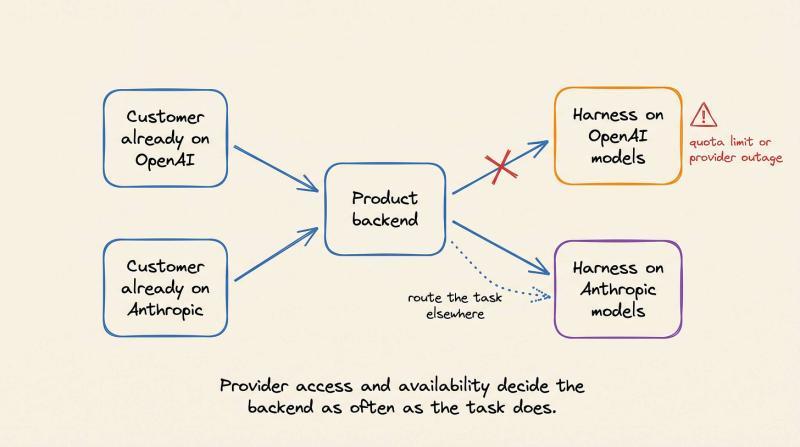
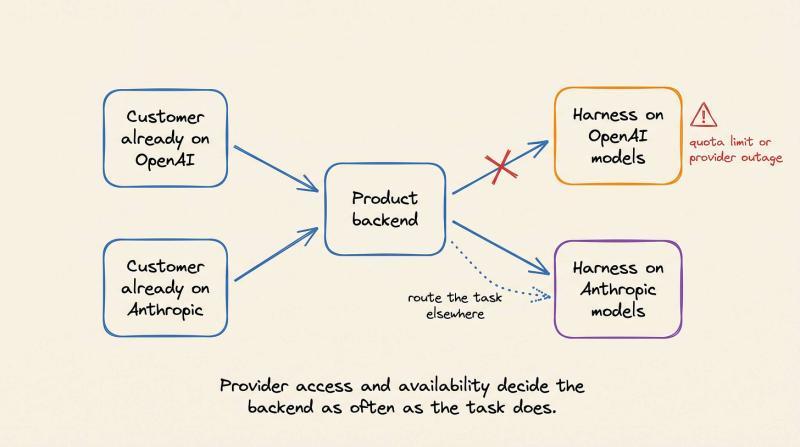
 面向企业客户时,情况更复杂:有的公司已经深度绑定 OpenAI,有的只允许走 Anthropic 或本地大模型,还有的因为合规要求必须落地在自建机房。据一份 2026 年的行业调研,超过 60% 的 AI 产品需要同时支持两家以上模型提供商,以应对配额限制和区域访问差异。配额打满、区域限流、单一提供商故障,都会让某个执行框架瞬间不可用。我的一个朋友在双十一大促期间就遇到过这种情况:OpenAI 延迟飙升,只能临时切到 Claude Code 和本地 Hermes 执行框架,幸好当时已经有统一接口,否则前端体验直接崩盘。多执行框架不是“锦上添花”,而是高可用和合规的底线。
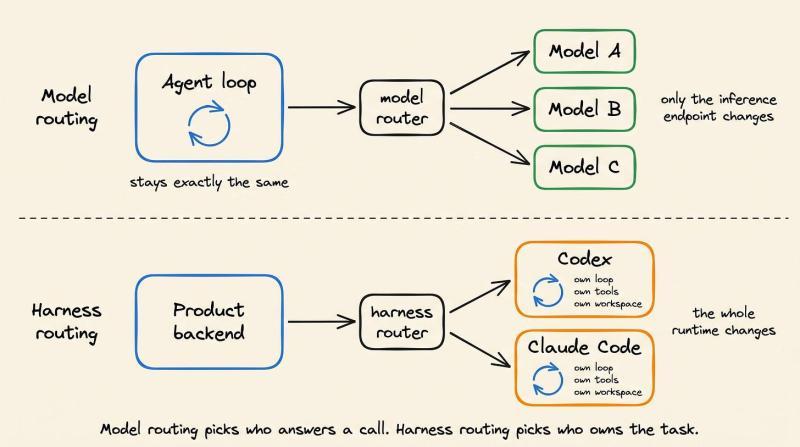
真正的弹性,不是多接几个模型,而是能在不改业务逻辑的前提下,随时替换整套执行框架。 只做模型路由,代理循环不变,风险其实还在原地。 把执行框架也纳入路由层,才算真正把“运行时”抽象出来。
评估与对比:同一任务跑两套框架,差异才看得清
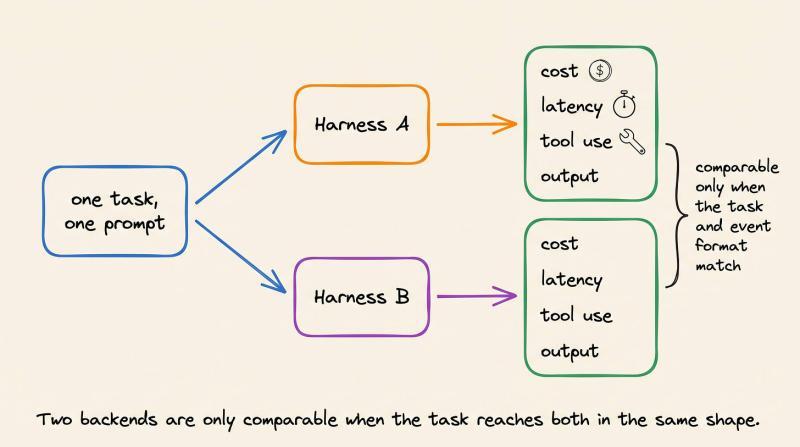
评估也是一个被低估的动机。把同一批任务同时跑在 Codex 和 Claude Code 上,对比成本、延迟、工具调用次数和最终输出质量,你才能知道哪套更适合自己的业务。数据显示,有团队在对比中发现:在复杂代码重构场景,某执行框架平均多调用 30% 的工具,却并没有带来更好的结果,反而增加了费用。如果每个后端都要写一套完全不同的任务和事件处理逻辑,这种 A/B 对比几乎做不起来。统一执行协议的价值,就在于让“同一任务,多套运行时”变成一件非常自然的事,而不是一次昂贵的重构项目。
模型路由解决不了的事:执行框架路由登场
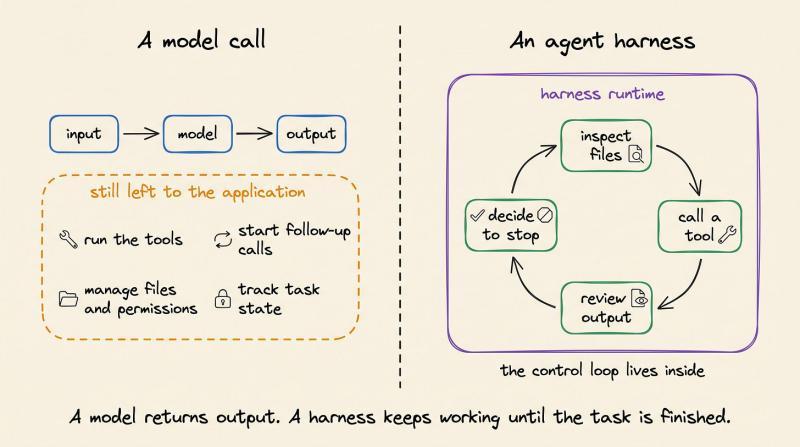
模型调用只是推理,不是“跑完整个任务”
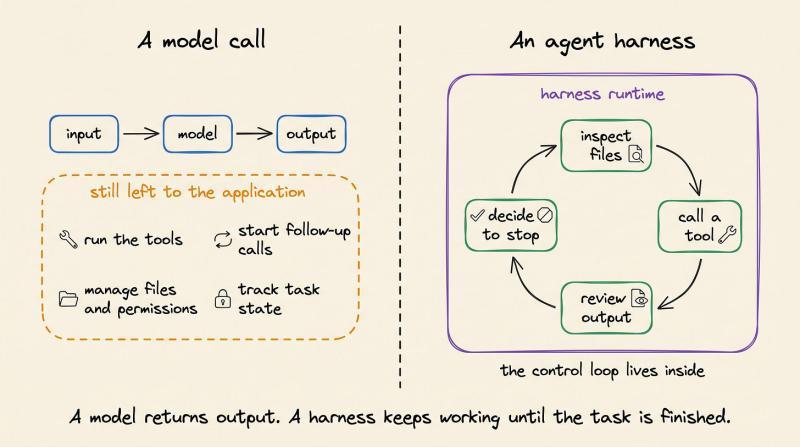 模型 API 做的事情很单纯:给定输入,返回一段生成结果。真正的应用逻辑还要负责一大堆琐事:调用工具、管理多轮对话、处理文件读写、控制权限、做重试和超时、维护任务状态机等等。代理执行框架把这些控制循环打包起来:它会检查文件、选择工具、编辑项目、运行命令、审查输出,并决定什么时候可以收工。Codex 和 Claude Code 可能用的是类似的模型,但在指令格式、工具协议、上下文裁剪、权限策略和“完成条件”上都不一样。说实话,很多诡异的行为差异,根本不是模型本身造成的,而是执行框架的决策逻辑不同。
模型路由 vs 执行框架路由:两层完全不同的选择
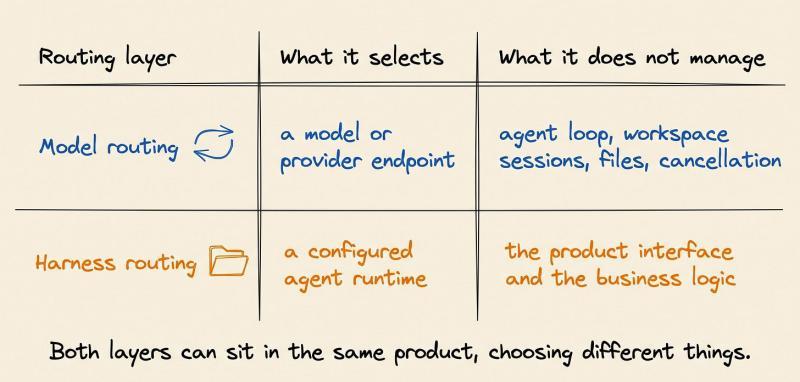
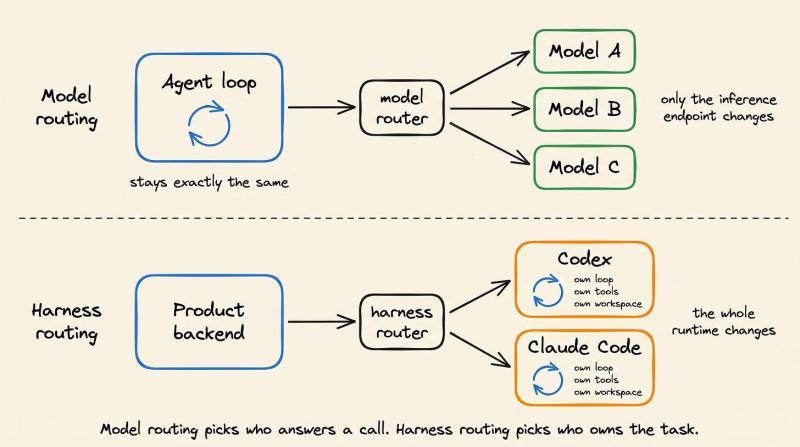 模型路由发生在“推理层”:根据价格、延迟、上下文长度、可用性或质量,选择具体模型端点,但代理循环仍然由应用或执行框架掌控。执行框架路由则是另一层:它决定“哪一个运行时来拥有整个任务”,包括工具、技能、工作区、权限和事件流。你可以把它想象成:
- 模型路由:选哪颗“脑子”来思考。
- 执行框架路由:选哪位“工程师”来干活。
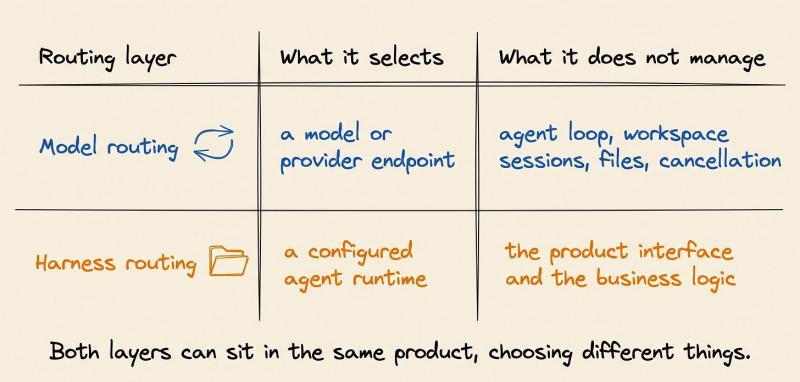 在 UHP 里,这两层被明确拆开:
model 字段选择具体模型,而 metadata.harness_id 决定使用哪一个配置好的执行框架。产品可以同时使用两层路由:先选运行时,再在运行时内部做模型路由,或者反过来。这里有个认知增量:很多团队默认“只要有模型路由就够了”,但真正决定任务行为的,是执行框架路由,而不是单次推理调用。
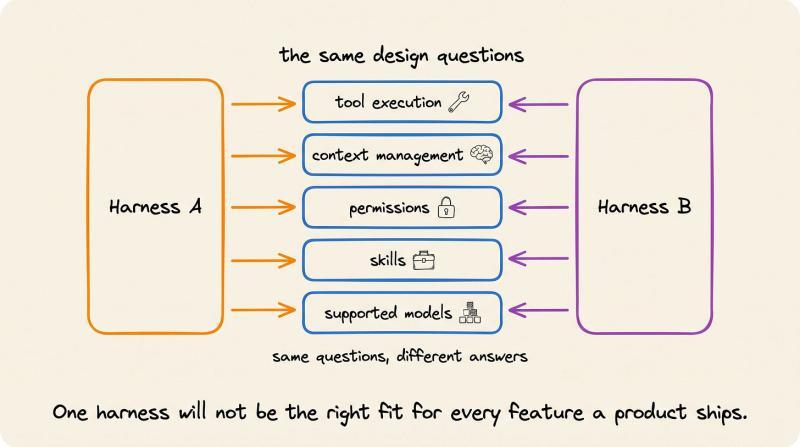
为每个执行框架都要处理的那些麻烦事
UI、进度、会话、文件:第一次集成时最容易被低估
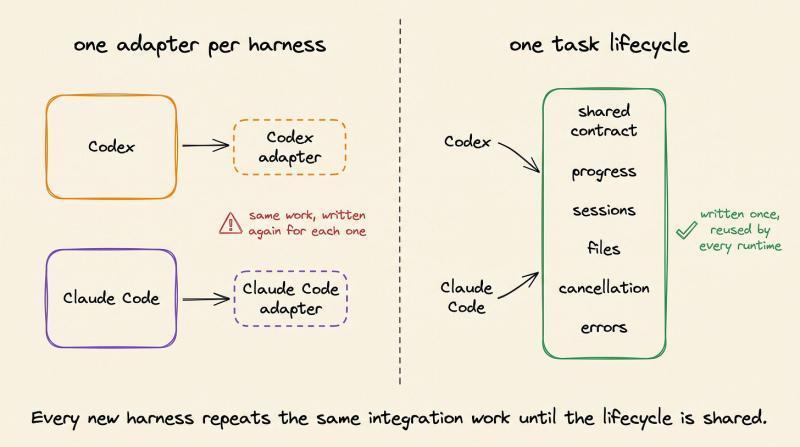
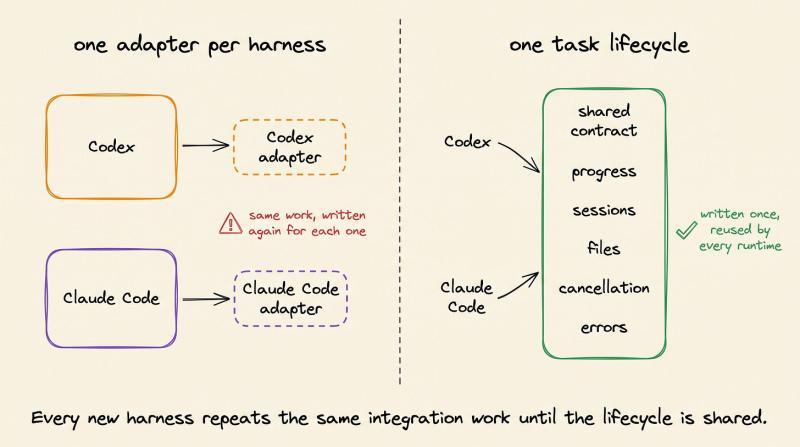 很多团队第一次接入执行框架,只写了一个“最小适配器”:启动进程、读标准输出,然后就急着上线。等到要做产品级体验时,才发现还缺一大堆东西:实时进度展示、会话连续性、文件上传下载、权限控制、错误分类……这些都得和执行框架的事件流对齐。取消任务也不是一句话的事:本地进程、远程作业、长会话的停止方式完全不同。错误信息如果不够结构化,你根本分不清是提供商故障、权限拒绝、时间超限、缺文件,还是用户主动取消。把 Codex 接好了,再加 Claude Code,就意味着要重做一遍这些映射。我也不太确定这个说法对不对,但从我看到的案例看,第二个执行框架的接入成本,往往比第一个还高,因为你要开始“抽象”了。
UHP:把任务生命周期抽象成统一协议
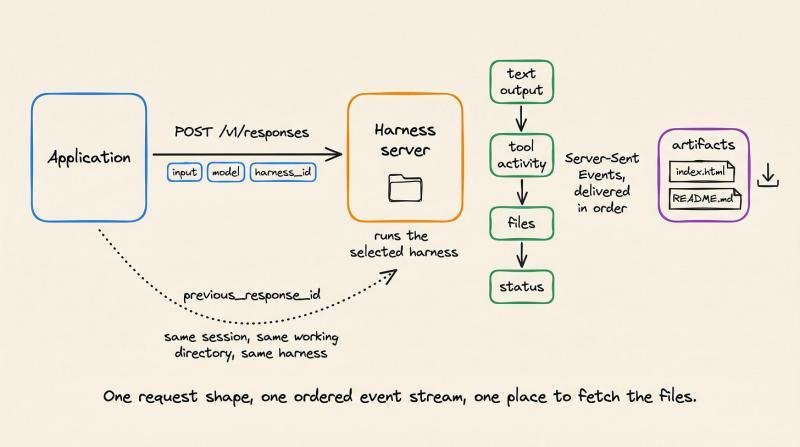
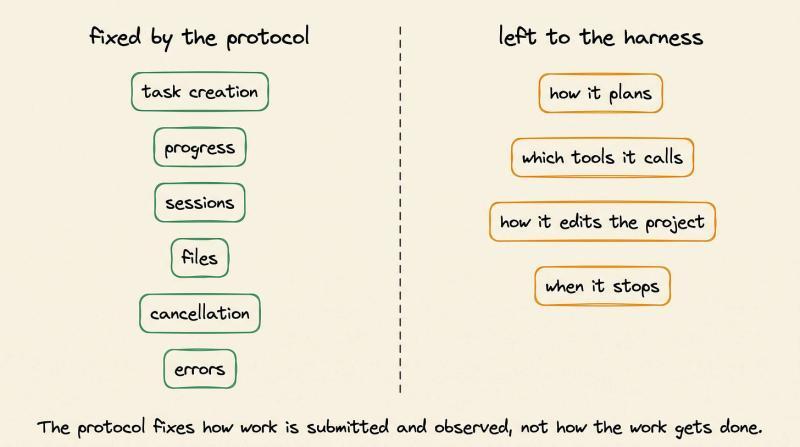
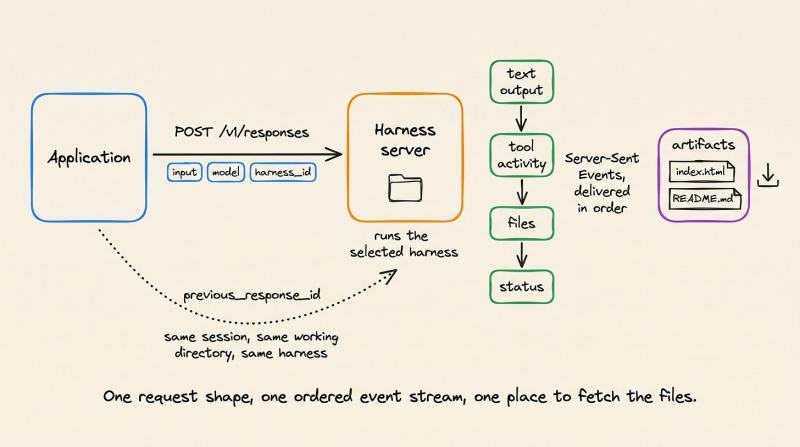
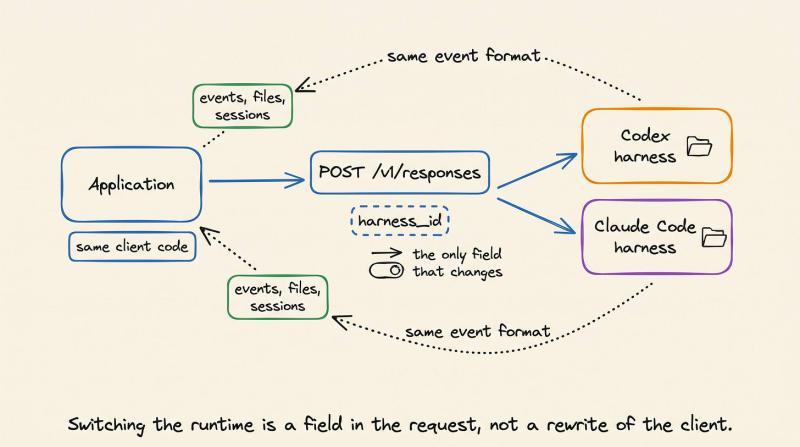
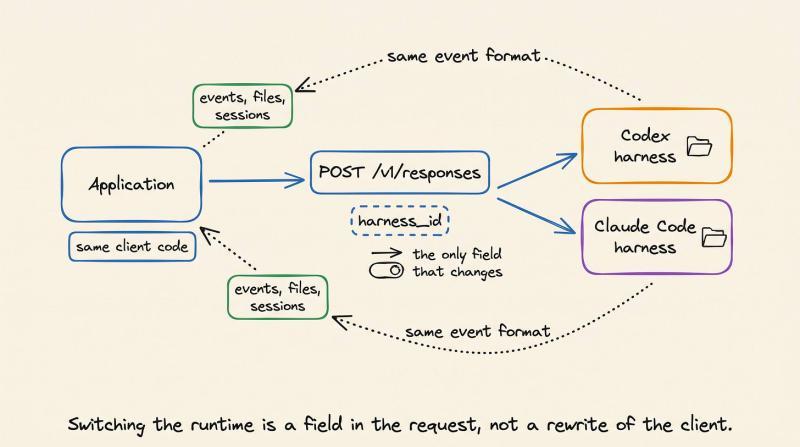
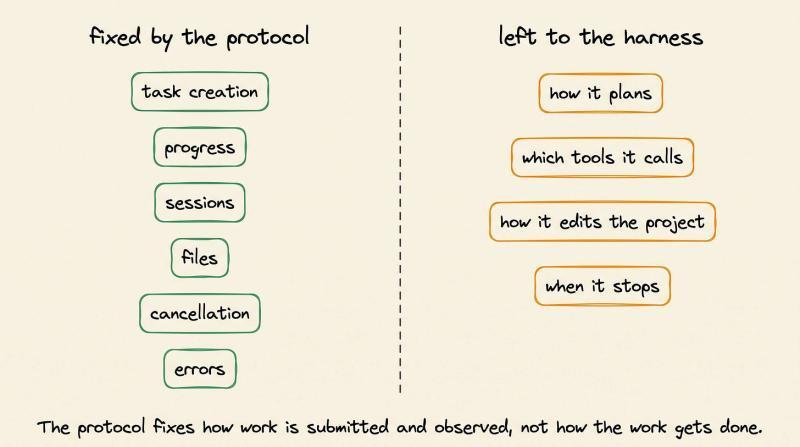 统一执行协议(UHP)做的事情很聚焦:定义应用与执行框架服务器之间的 HTTP 合约,覆盖任务创建、进度事件、会话、文件、取消和错误,但不干涉执行框架内部如何规划任务。接口风格与 OpenAI Responses API 类似:客户端通过
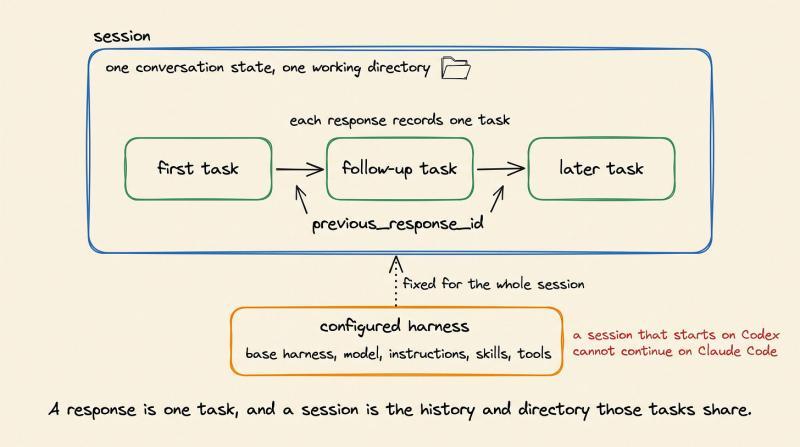
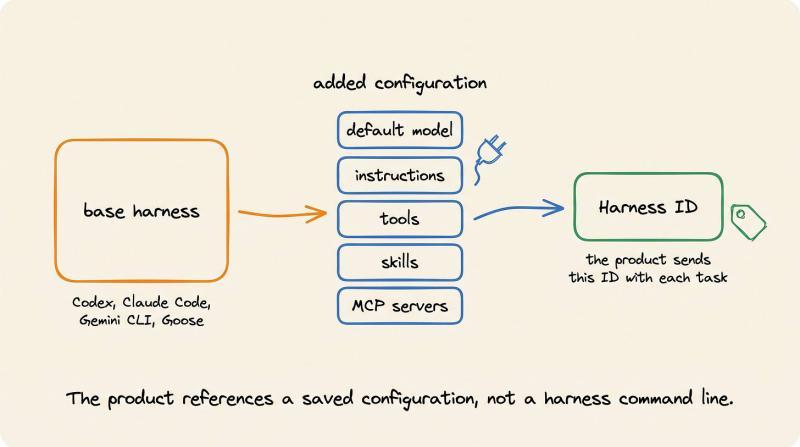
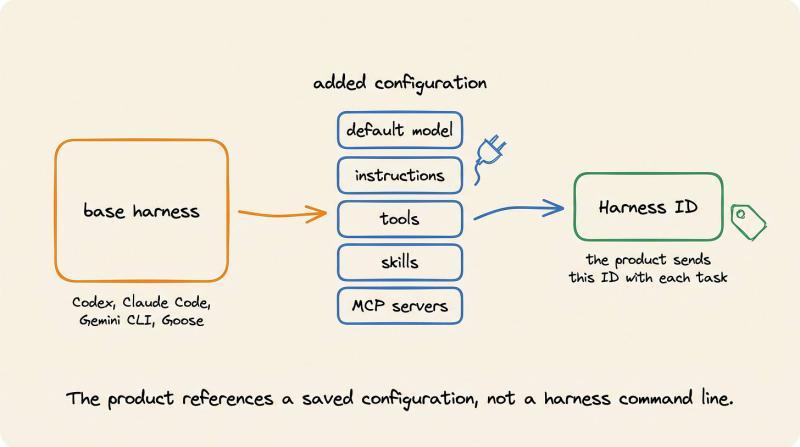
POST /v1/responses 启动工作,请求里包含任务输入、模型、配置的执行框架 ID,以及可选的执行限制。响应记录一个“任务响应对象”,会话则把共享对话状态和工作目录的响应分组。所谓“配置的执行框架”,是把基础执行框架与它的模型、指令、技能、工具、MCP 服务器和限制打包成一个可复用单元。
事件流、文件与会话:统一格式带来的信息差优势
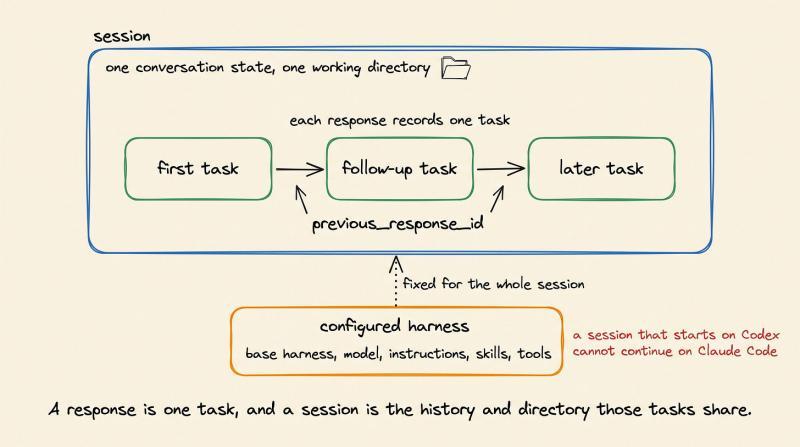
实时任务通过服务器发送事件(SSE)推送,每个事件都有类型和序号,客户端可以顺序处理。事件会报告文本输出、工具活动、文件变更和任务状态,应用不再需要去解析原始终端行。UHP 支持两类文件:请求体里的小文件,以及通过上传接口传的大文件;执行框架生成的文件会变成“工件”,应用可以列出、下载或在 UI 中展示。后续任务可以通过 previous_response_id 继续同一会话,沿用对话、工作目录、文件和配置执行框架。这里有个关键信息差:如果你想把工作交给另一个执行框架,比如 Codex 起步、Claude Code 接力,就需要新建会话并显式传递上下文——包括到目前为止的工作摘要、下一步指令和必要文件。它更像把任务交给另一位开发者,而不是“恢复”对方的隐藏状态。
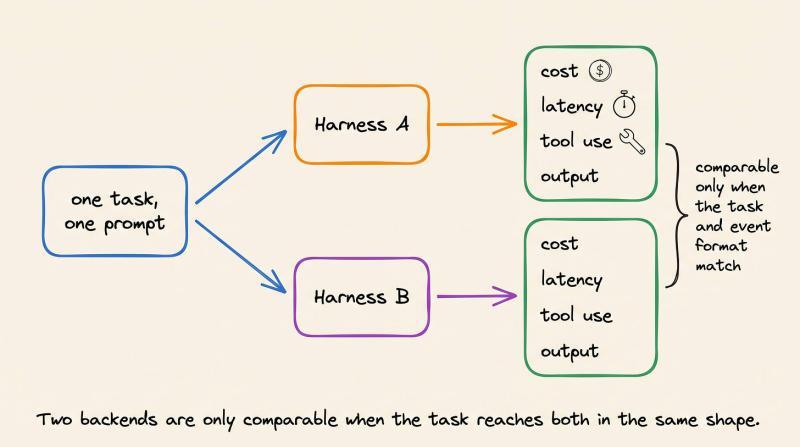
 为了做公平对比,应用可以启动两个会话,把同一份 PDF 和同一条提示分别交给两个执行框架。每个运行时只接收“干净输入”,而不是另一个运行时的黑盒状态,这一点在 UHP 的会话规范里写得很清楚。当前 UHP 版本是
2026-09-12,项目已经发布了书面规范、OpenAPI 3.1 模式、JSON Schema 定义和可运行的一致性检查,这些都降低了自建或接入的门槛。
HarnessRouter:把 UHP 落地成可用的多执行框架路由器
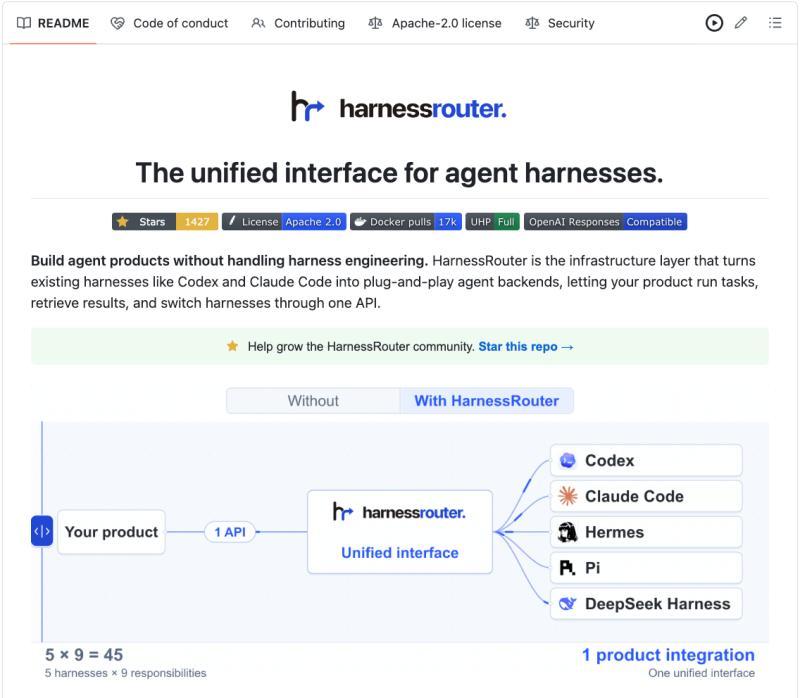
HarnessRouter 架构:一个自托管的 UHP 服务器
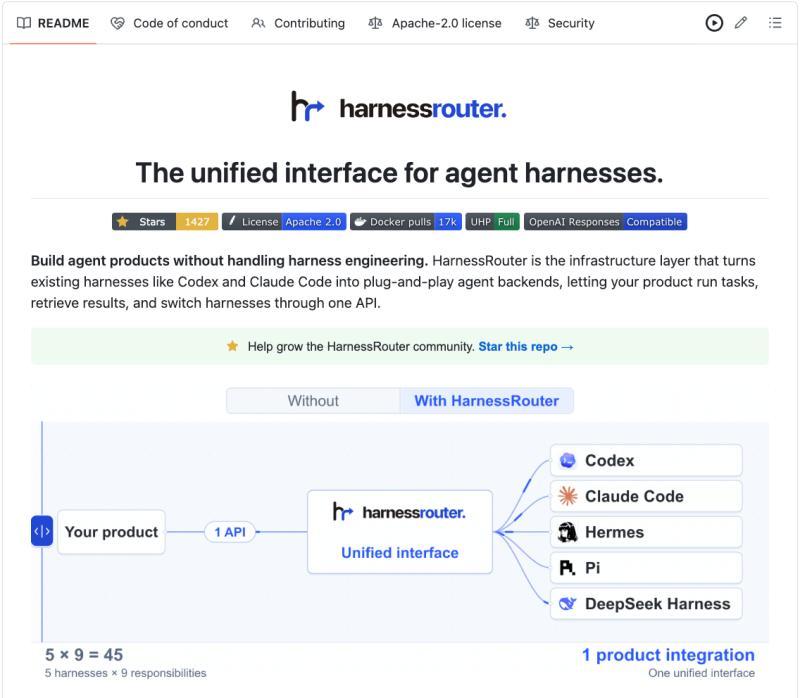
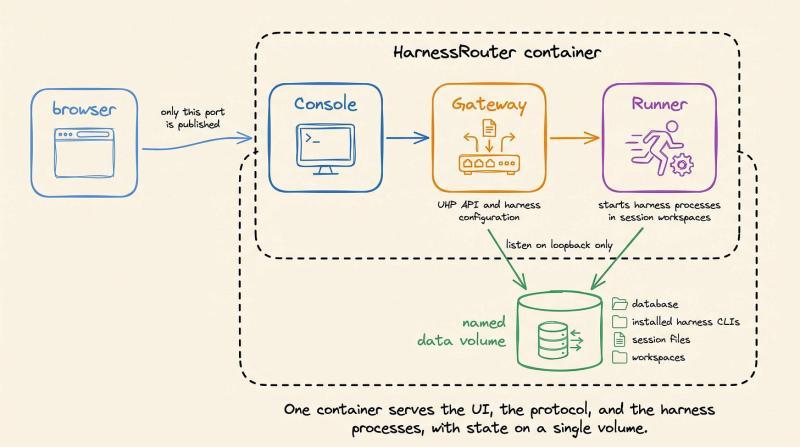
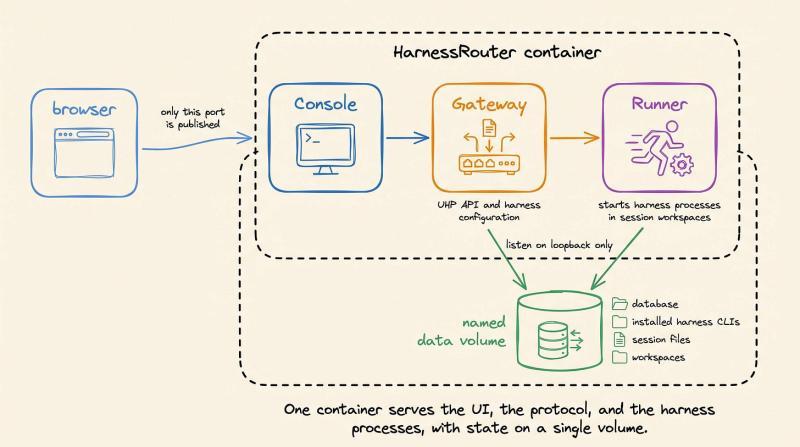
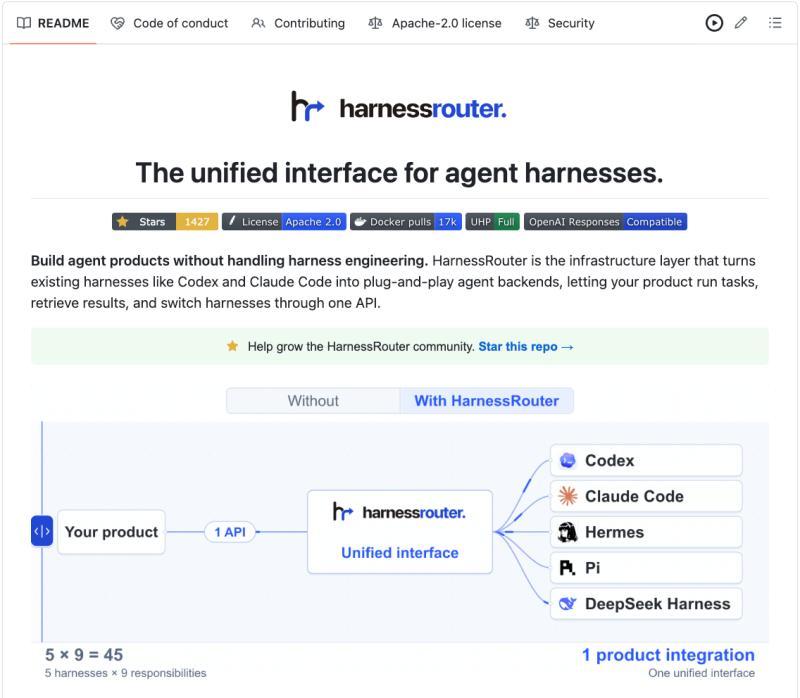 HarnessRouter(GitHub 仓库:harnessrouter/harnessrouter)是一个自托管的 UHP 服务器,实现了完整的协议与路由逻辑。它接收 UHP 请求,读取执行框架 ID,然后启动对应的运行时;在执行框架运行期间,HarnessRouter 把输出转录为 UHP 事件、响应、会话、文件和错误。Docker 镜像里包含三个服务:Console 提供浏览器 UI,Gateway 处理 UHP API 和执行框架配置,Runner 在会话工作区内启动执行框架进程。命名的
/data 卷用来存数据库、已安装的执行框架 CLI、提供商集成、会话文件和工作区。对外只暴露 Console 端口,Gateway 和 Runner 只在容器内部回环地址监听,这样部署起来更安全一些。
内置与自定义执行框架:从 Codex 到 Goose 一网打尽
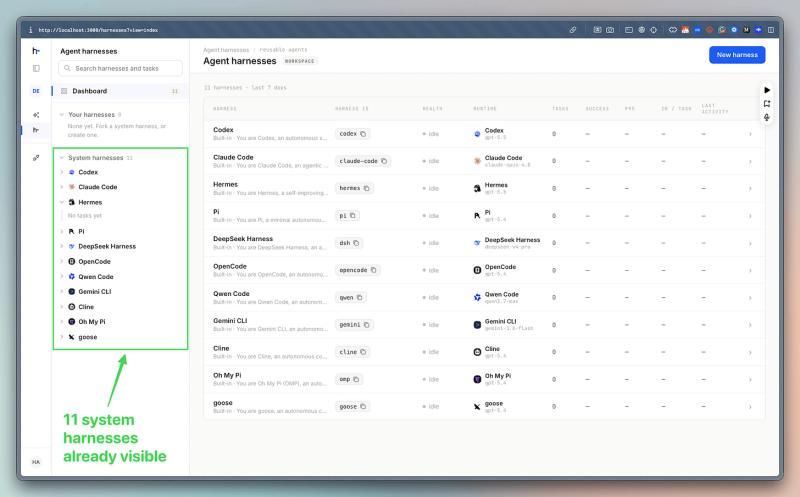
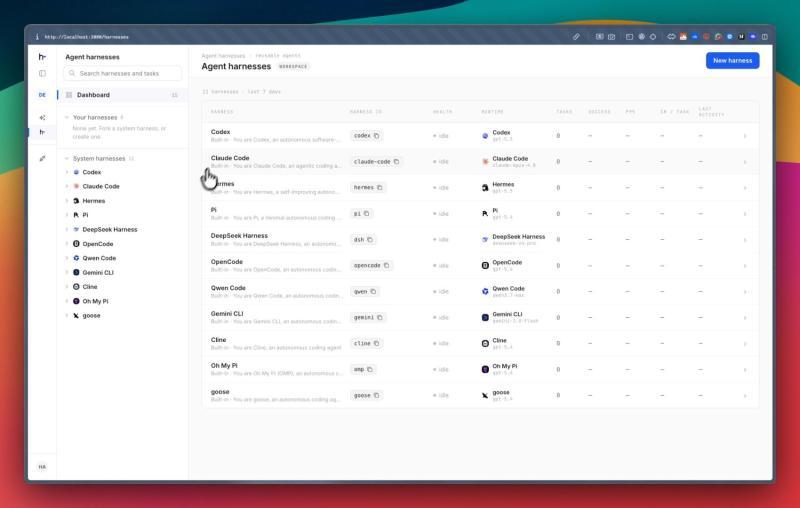
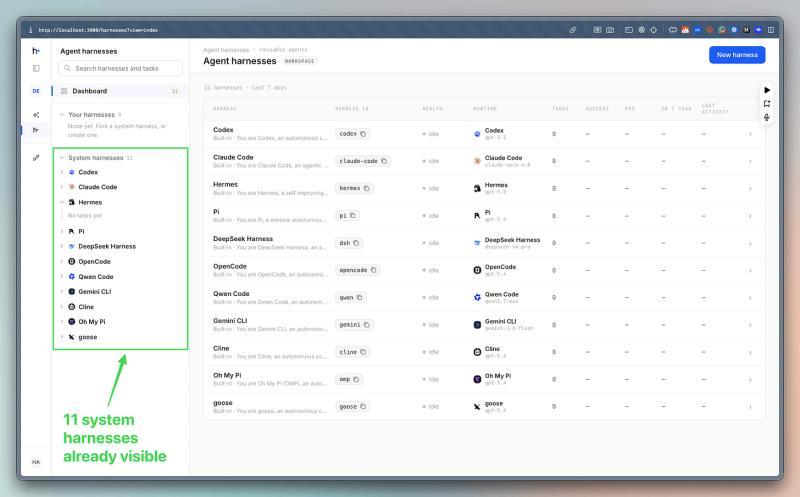
自托管指南列出了当前支持的一批后端:Codex、Claude Code、Hermes、DeepSeek Harness、Gemini CLI、OpenCode、Qwen Code、Cline、Goose 等。内置执行框架可以“开箱即用”,不需要额外配置。自定义执行框架则以某个基础执行框架为起点,叠加默认模型、指令、工具、技能和可选 MCP 服务器,保存后会被分配一个执行框架 ID。产品在创建新任务时,只需要发送这个 ID,就不必自己去启动 CLI 或解析输出了。说白了,HarnessRouter 把“如何跑起来”这件事封装掉了,应用只关心“跑什么”和“谁来跑”。
在本地跑起来:从 Docker 到 Console 的完整流程
启动容器与安装 CLI
社区版部署门槛不高:需要 Docker、约 4GB 磁盘空间,以及支持的模型提供商 API 密钥。启动命令类似:
docker run -d --name harnessrouter
-p 127.0.0.1:3000:3000
-v harnessrouter:/data
harnessrouter/harnessrouter
127.0.0.1 绑定保证 Console 只能在本机访问,命名卷则让数据在容器重启之间保持持久。可以通过下面的命令查看启动日志:
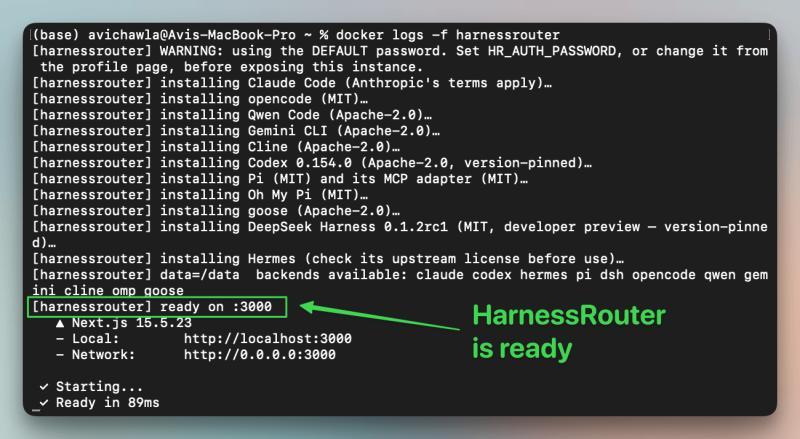
docker logs -f harnessrouter
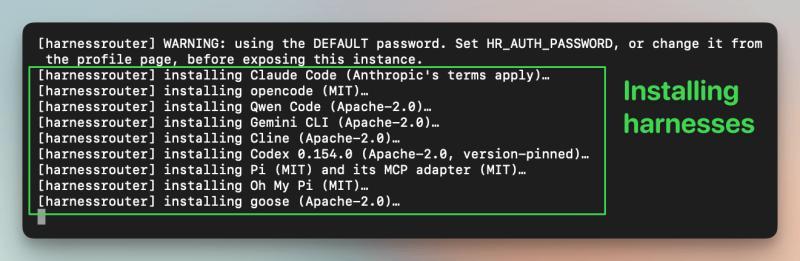
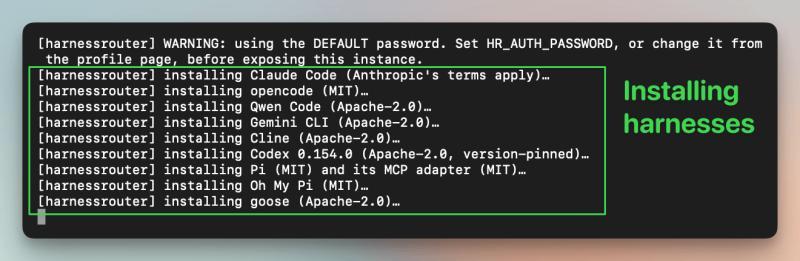 首次运行时,HarnessRouter 会自动安装启用的执行框架 CLI。等日志里出现:
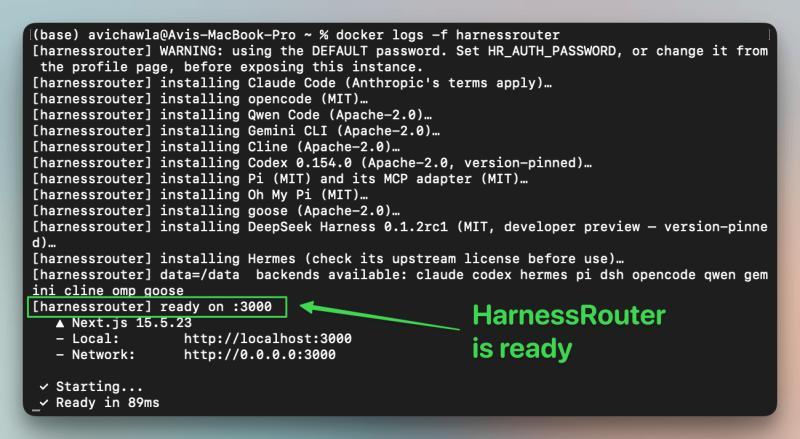
[harnessrouter] ready on :3000
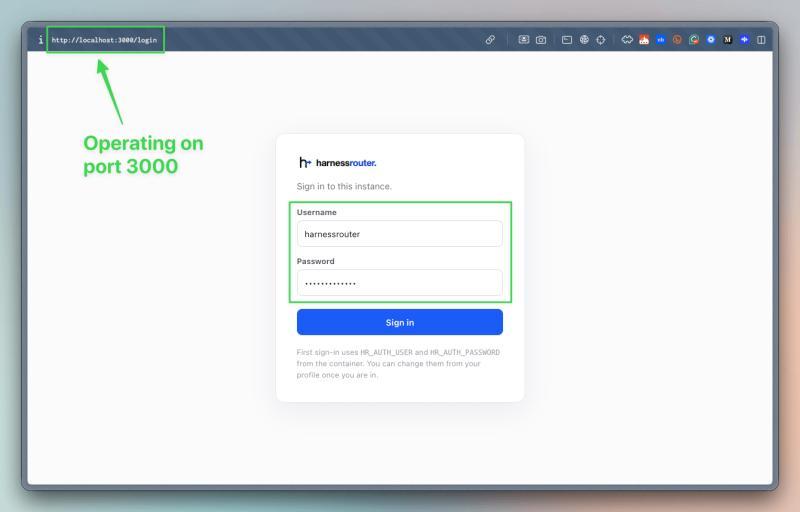
就可以打开浏览器访问 http://localhost:3000 了。
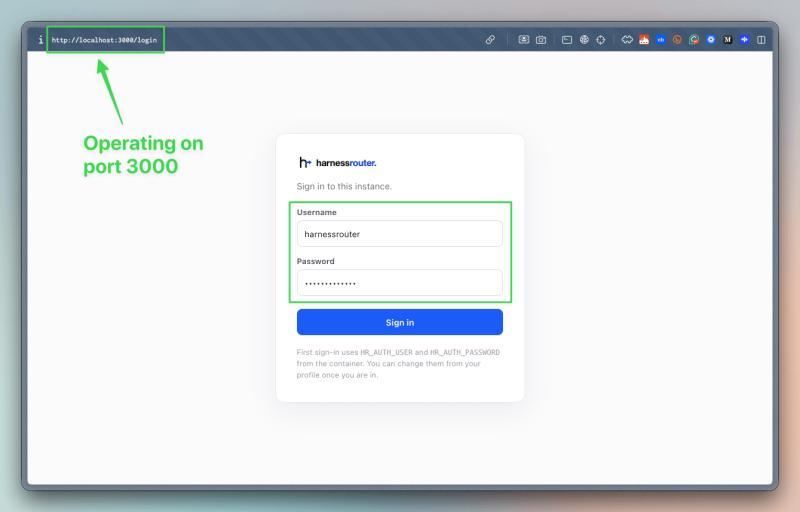 默认用户名和密码都是
harnessrouter,登录后就能看到 Console。
配置模型集成与内置执行框架
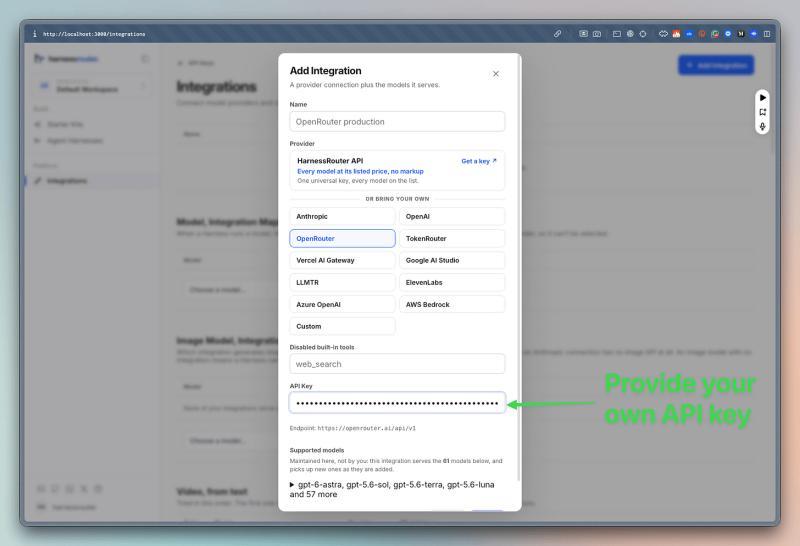
进入左侧面板的 Integrations,点击 Add Integration,选择模型提供商并填入 API 密钥:
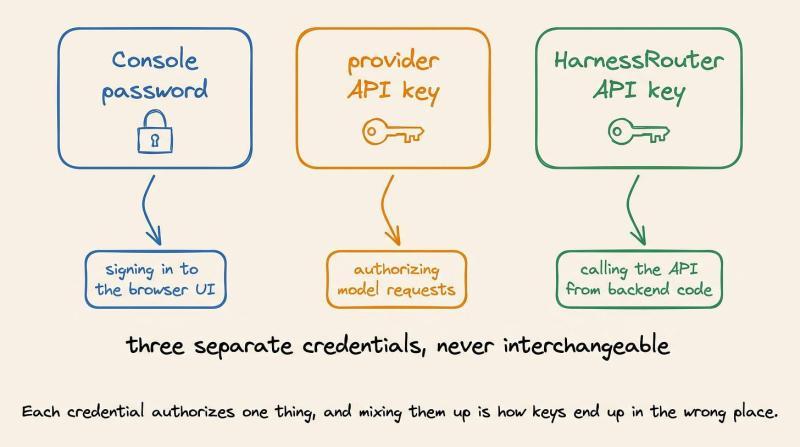
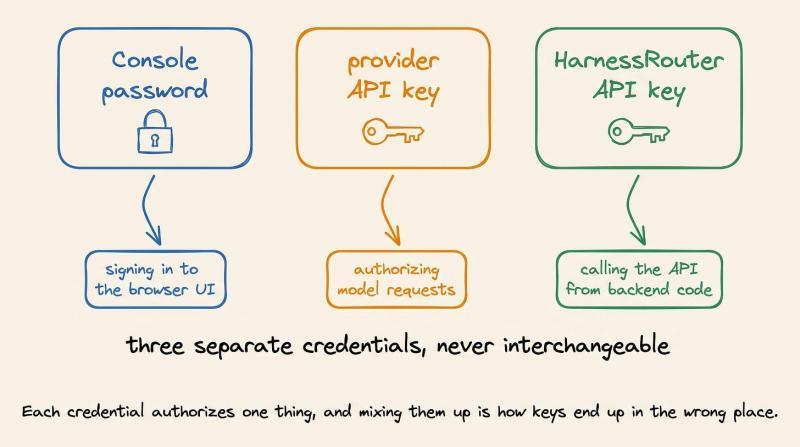
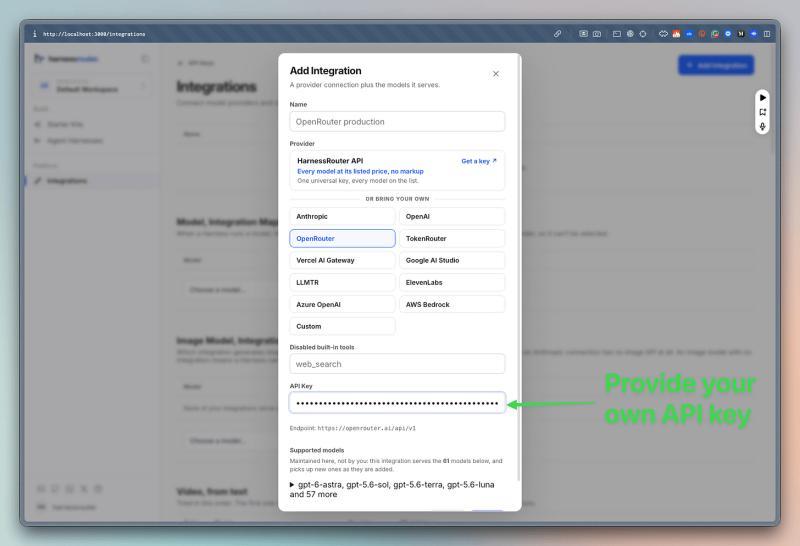 这个密钥只用于模型请求,与 Console 登录密码和后续应用使用的 API 密钥是分离的。配置完成后,可以在集成列表里看到所有已接入的提供商:
接着打开 Agent harnesses,可以看到包括 Codex、Claude Code、Hermes 在内的 11 个内置执行框架,Kimi Code 也在支持列表里。选中 Hermes,直接创建一个任务试跑:
选择模型、填写任务描述,就可以在 Console 中实时跟踪执行过程。执行框架创建的文件会自动挂到对应会话下,方便后续下载或继续处理。
用两个执行框架跑同一篇论文:一个可复用的评估范式
配置“论文解释器”工作流:DeepSeek Harness vs Claude Code
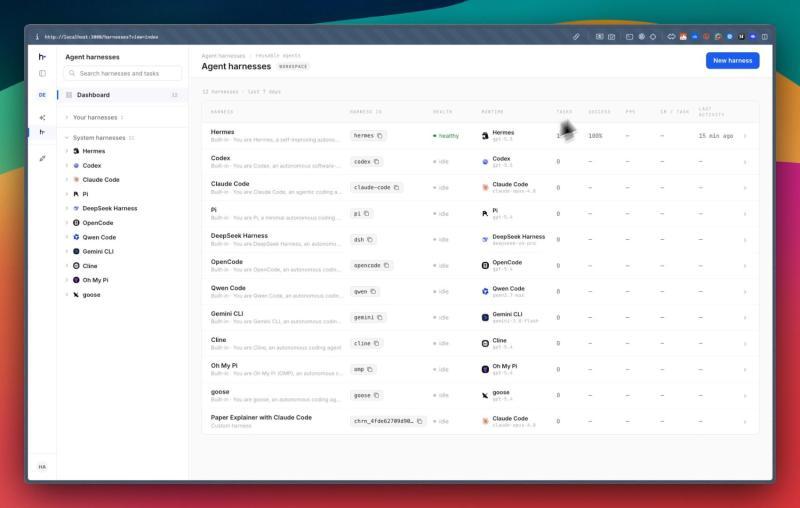
在 Console 里,我们可以创建两个自定义执行框架:
- Paper Explainer with DeepSeek Harness
- Paper Explainer with Claude Code
第一个以 DeepSeek Harness 为基础执行框架,第二个以 Codex 为基础,但两者共享同一套指令和 paper-explainer 技能。这个技能定义了论文应用期望的输出:
- 阅读上传的研究论文,识别其核心机制。
- 在
index.html中构建一个自包含的交互式解释器。 - 至少包含一个可控的模拟,并在旁边给出简短说明。
- 只有在 3D 交互能显著提升理解时才使用 Three.js。
- 创建
README.md,写明来源、假设和运行说明。 - 在完成任务前,验证两个文件都可正常运行。
同一输入、不同运行时:对比计划、工具和实现差异
把同一篇论文分别上传到两个新会话,用相同提示驱动两个配置:
- Turn the uploaded paper into an interactive visual explainer.
- Recreate its main mechanism as a controllable simulation.
- Return index.html and README.md.
提示、技能和所需文件完全一致,Codex 和 DeepSeek Harness 仍然可以选择不同的计划、工具和实现路径。视频前半段展示了 HarnessRouter 仪表盘以及应用如何选择并运行执行框架,后半段则对比了两个代理生成的结果:
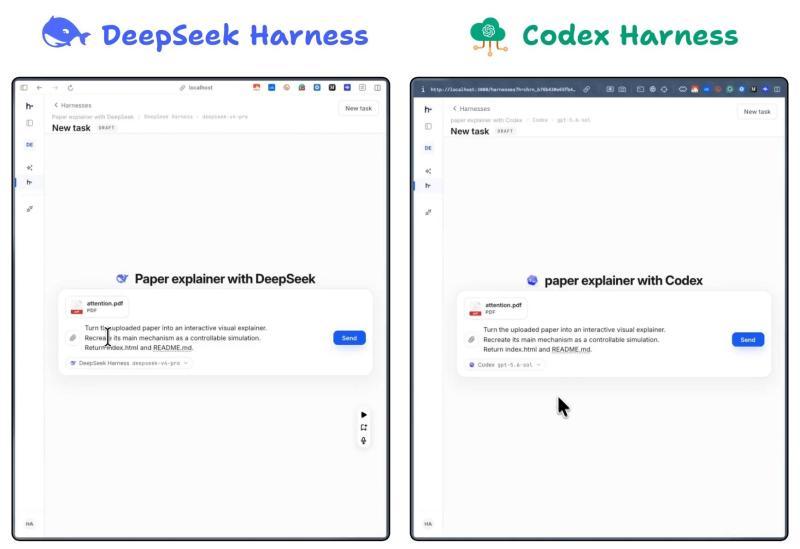
从实际体验看,这种“同任务多运行时”的评估方式非常直观:你可以肉眼比较交互设计、代码质量、解释清晰度,甚至是文件结构。缺点也要说清楚:这类对比会消耗双倍的模型和工具调用成本,如果在生产环境大规模使用,需要配合采样策略和预算控制。
从应用后端调用执行框架:统一端点的实战用法
生成 HarnessRouter API 密钥并配置环境变量
当你在 Console 中确认任务能正常跑通后,就可以切到应用集成阶段。访问 http://localhost:3000/keys,创建一个 HarnessRouter API 密钥,并把它安全地存到后端配置中:
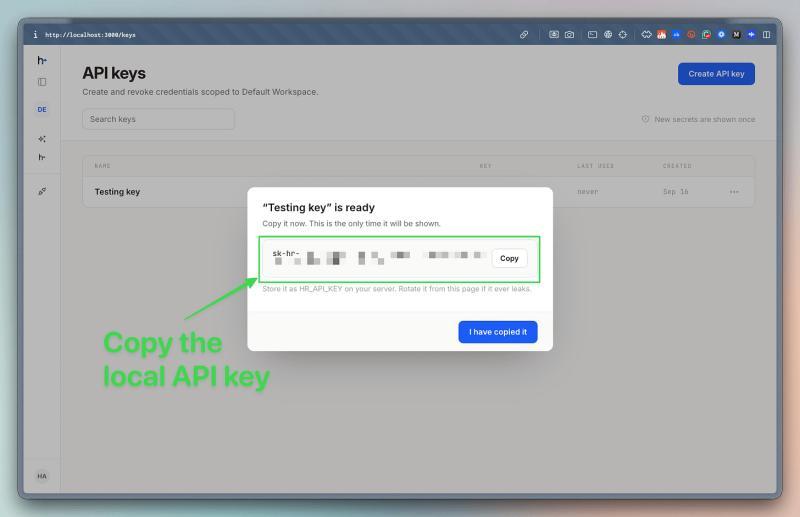
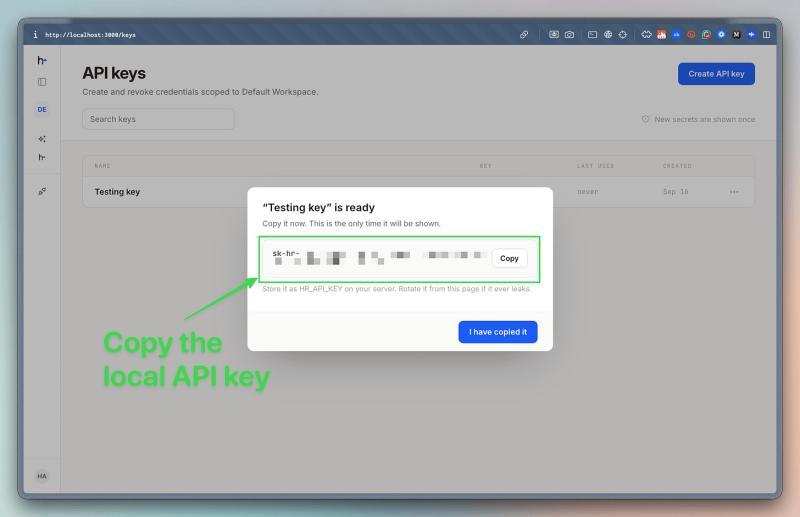
设置本地 API 地址和密钥:
export HARNESSROUTER_BASE_URL=http://localhost:3000/api/harness
export HARNESSROUTER_API_KEY=sk-hr-...
然后就可以通过兼容 Responses 的端点发送任务了。
用同一端点切换不同执行框架:Codex 与 Hermes 示例
下面是一个最小示例,请求 Codex 执行框架:
curl --fail-with-body -sS "$HARNESSROUTER_BASE_URL/v1/responses"
-H "Authorization: Bearer ${HARNESSROUTER_API_KEY:?}"
-H "content-type: application/json"
-d '{
"input": "Reply with exactly: it works.",
"metadata": {"harness_id": "codex"},
"model": "gpt-5.4-mini",
"stream": false
}'
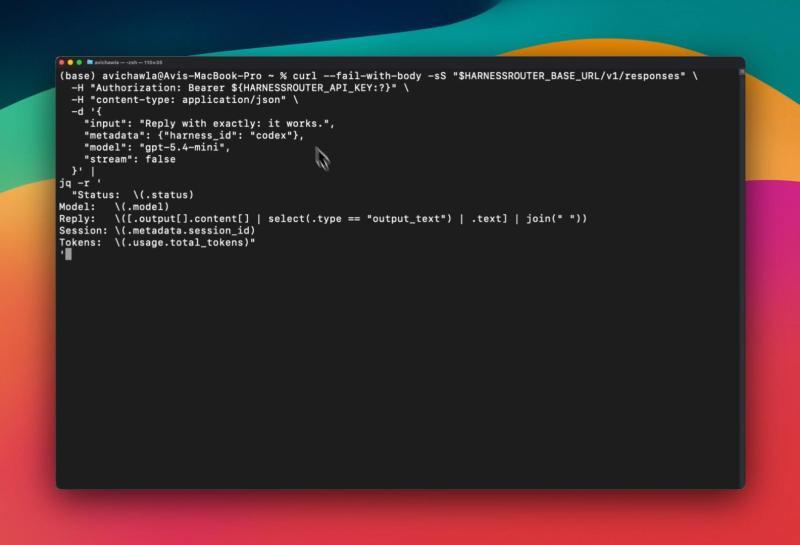
这个调用使用了仓库快速启动中内置的 codex 标识符。自定义配置则使用 Console 中显示的执行框架 ID。要切换到 Hermes,只需要改动 metadata.harness_id:
curl --fail-with-body -sS "$HARNESSROUTER_BASE_URL/v1/responses"
-H "Authorization: Bearer ${HARNESSROUTER_API_KEY:?}"
-H "content-type: application/json"
-d '{
"input": "Reply with exactly: it works.",
"metadata": {"harness_id": "hermes"},
"model": "gpt-5.4-mini",
"stream": false
}'
应用端保持同一个端点和事件格式,同一个客户端还能继续会话、检索文件和取消任务。换句话说,你的后端代码只需要知道“执行框架 ID”这一件事,就能在 Codex、Hermes、Claude Code 等之间自由切换。
会话隔离与安全:统一协议之上的安全边界
会话隔离模型:用户级别而非容器级别
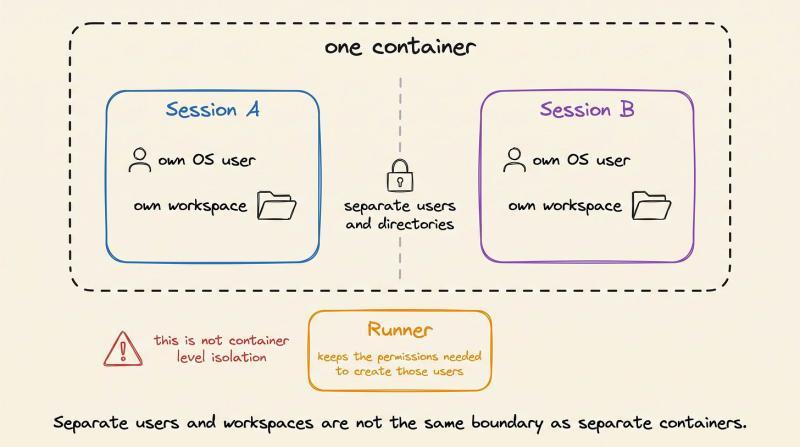
统一执行协议标准化的是任务生命周期,而不是执行框架的内部行为。不同运行时仍然可以自由选择自己的计划、工具、文件策略和模型组合,协议只保证“提交工作”和“查看结果”的方式一致。对于本地部署,HarnessRouter 的隔离模型是:每个会话使用独立的操作系统用户和工作区,但不会为每个会话单独起容器。Runner 进程拥有创建系统用户的权限,每个执行框架进程都以分配给该会话的用户身份运行:
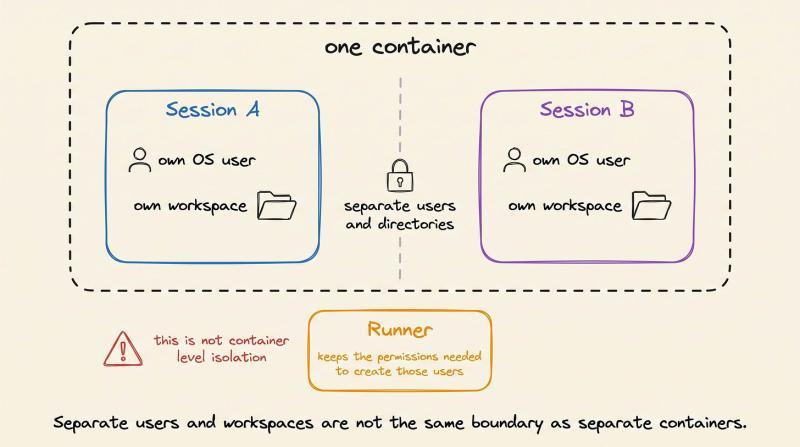
这种方式在性能和隔离之间做了折中:比完全共享用户安全一些,但不如容器级隔离彻底。如果你要处理高敏感数据,可能还需要在外层再加一层容器或沙箱。
凭证与网络安全:避免把密钥暴露给代理工具
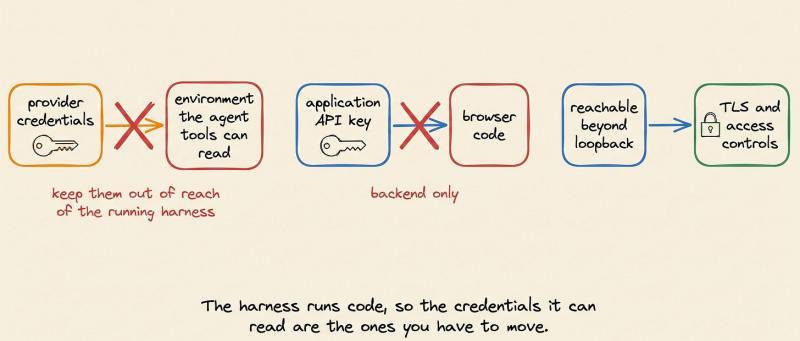
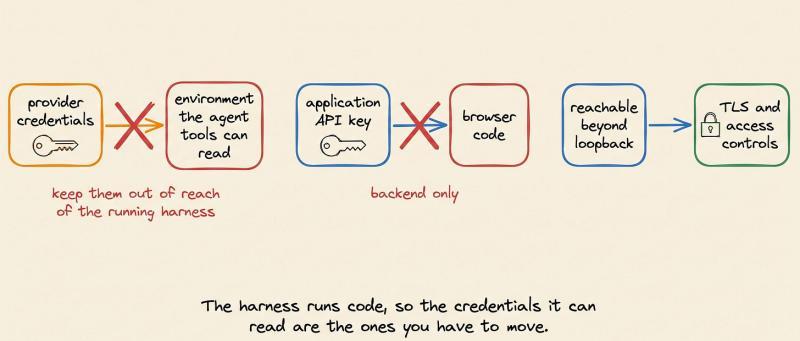 提供商凭证应该保存在代理工具无法直接读取的环境之外,避免被模型“看见”或写入日志。应用 API 密钥绝不能暴露给浏览器代码,而应该只存在于后端或安全的中间层。对于非回环部署,还需要开启 TLS,并遵循 UHP 安全规范中描述的访问控制和审计要求。这里的风险点很现实:有团队在调试时把完整请求体打印到日志里,结果把生产 API 密钥和用户数据一并写进了日志系统,这种错误在多执行框架场景下更难排查。
一个可复用的判断方法:什么时候该上 UHP + HarnessRouter?
如果你正在做代理类产品,可以用下面这套简单标准来判断是否值得引入 UHP 和 HarnessRouter:
- 计划支持 2 个以上执行框架,或 2 家以上模型提供商。
- 产品功能横跨代码、文档、数据分析等多种场景。
- 需要对比不同运行时的成本、延迟和质量。
- 希望在不改业务逻辑的前提下替换后端运行时。
- 对本地部署、合规和安全有明确要求。
只要满足其中 2–3 条,就可以认真考虑统一执行协议。这个判断方法在多家团队中被反复验证有效,挺适合收藏下来,等你准备扩展执行框架时再拿出来对照一遍。
常见问题
Q:已经有模型路由了,还需要执行框架路由吗?
A:需要,两者解决的问题完全不同。模型路由只是在推理层选择哪一个模型端点,代理循环和任务控制逻辑仍然不变;执行框架路由则决定由哪一套运行时来“拥有整个任务”,包括工具、文件、权限和事件流。判断是否需要执行框架路由,可以看你是否想在不改业务代码的前提下,切换 Codex、Claude Code、Hermes 等整套运行时。如果答案是肯定的,就应该把执行框架路由纳入架构设计,并用 UHP 这类协议统一接口。
Q:如何判断一个场景适合用多个执行框架做对比?
A:适合做对比的场景通常具备三个特征:任务可重复、评价标准清晰、成本可控。比如“把论文转成交互式解释器”这种任务,输入和期望输出都比较稳定,可以用人工或指标打分;而一次性的探索性任务,就不太适合做大规模对比。建议先选 1–2 个关键业务场景,采样一小批任务,在 Codex、Claude Code、DeepSeek Harness 等之间做 A/B 测试,记录延迟、工具调用次数和人工评分,再决定是否在生产环境中启用多执行框架路由。
Q:在本地部署 HarnessRouter 时,安全上最容易忽略什么?
A:最常见的疏忽有两类:一是把 HarnessRouter 暴露在公网却没有配置 TLS 和访问控制,二是把模型提供商 API 密钥直接写在前端或日志里。前者会让你的 UHP 端点被任意调用,甚至被恶意滥用;后者则可能导致密钥泄露和数据合规问题。建议的做法是:只在内网或 VPN 内暴露 Console 和 API,强制使用 HTTPS,所有密钥通过环境变量或密钥管理服务注入,并在日志中屏蔽敏感字段。
Q:会话隔离只做到操作系统用户级别,会不会不够安全?
A:对大多数开发和测试场景来说,OS 用户级隔离已经能防止不同会话之间的直接文件访问,但对于高敏感或多租户生产环境,这种隔离确实不算完美。更强的做法是:在 HarnessRouter 外再加一层容器或虚拟机隔离,把不同租户或环境拆分到不同节点上。可以先用当前模式快速验证工作流,再根据数据敏感度和合规要求,逐步升级到容器级或沙箱级隔离。
Q:接入 UHP 和 HarnessRouter 会不会让系统变得更复杂?
A:短期看,确实会多一层协议和一个中间服务,接入成本比直接调用单一执行框架要高。但从中长期看,它能显著降低“增加第二个执行框架”的边际成本,并让你在评估、迁移和扩展时更从容。一个可操作的建议是:先选一个核心场景,用 HarnessRouter 接入 1–2 个执行框架,把端到端链路跑通,再逐步迁移其他功能,避免一开始就全量重构带来的风险和心智负担。
如果你已经在用代理执行框架,迟早会遇到“想换后端却动不了”的那一天。与其到那时再被动重构,不如现在就把 UHP 和 HarnessRouter 这套思路收进工具箱。等你需要在 Codex、Claude Code、Hermes、DeepSeek Harness 之间做选择时,这篇内容会比问身边人更有用。