 AI资讯
第26期:什么是“本地推理”——无需依赖云端,在本地设备上运行AI的技术
当我们使用ChatGPT或Gemini等生成型AI时,通常是通过互联网与远端的数据中心通信。我们发送问题,数据中心内的AI生成回答后再返回给我们。 然而,在处理公司机密或个人信息时,往往不希望将数据传输到外部。此时,“本地推理”技术便成为关注焦点。 即使没有网络连接,AI也能在本地设备运行 “推理”指的是将新数据输入已训练好的AI模型,进行计算以得出回答或预测的过程。 云端AI服务通常在服务提供
按标签聚合查看文章内容。
AI资讯当我们使用ChatGPT或Gemini等生成型AI时,通常是通过互联网与远端的数据中心通信。我们发送问题,数据中心内的AI生成回答后再返回给我们。 然而,在处理公司机密或个人信息时,往往不希望将数据传输到外部。此时,“本地推理”技术便成为关注焦点。 即使没有网络连接,AI也能在本地设备运行 “推理”指的是将新数据输入已训练好的AI模型,进行计算以得出回答或预测的过程。 云端AI服务通常在服务提供
 AI教程
一份面向 2026 年的 DeepSeek 实战指南:如何在托管 API、本地 Ollama 以及自建推理集群之间做选择,并避免老教程中的常见坑。
 AI教程
想在自己机器或服务器上跑 DeepSeek,而不是依赖云端 API?本文用实战视角讲清:什么时候该用 vLLM,如何选 DeepSeek 模型,如何安装与启动服务,如何处理推理输出、工具调用、性能与安全,以及常见坑位排查。适合有一定开发基础、希望自建 OpenAI 风格接口的技术同学。
 AI资讯
本文梳理了近期AI多智能体系统的安全事件、技术进展及社区讨论,重点关注OpenAI的安全披露、多智能体间消息传递机制及相关基础设施发展。
 AI资讯
本期内容涵盖GPT-6.1 Sol与Sonnet 5.5性能表现、决策模型进展、本地推理工具、AI研究成果及行业政策动态。
 AI资讯
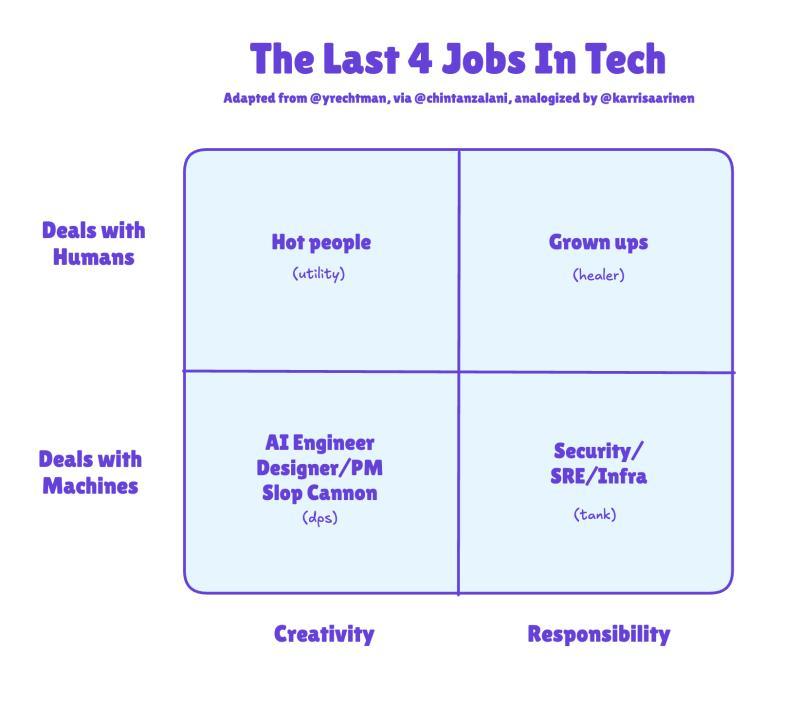
在人工智能变革下,科技行业的组织架构和职位角色正在发生深刻变化。本文探讨了后AI时代白领科技岗位的新模型,并回顾了近期AI领域的重要技术进展。
 AI资讯
在2026年IFA展会上,多款搭载192GB内存和AMD Ryzen AI Max+ PRO 495处理器,能够本地运行3000亿参数级大型语言模型(LLM)的迷你PC相继亮相。日本GMKtec公司于9月5日(德国时间)发布了其旗舰迷你PC产品——EVO-X5 Pro。 EVO-X5 Pro结合了AMD最新的Ryzen AI Max+ PRO 495处理器与最高192GB统一内存,支持无需依赖云
 AI教程
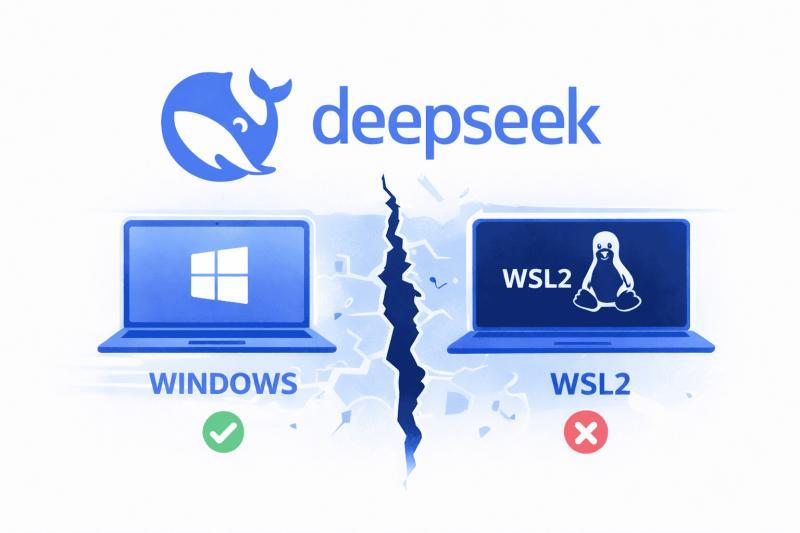
在 Windows 本地运行 DeepSeek 完全可行,但不同方案体验差异巨大。本文用通俗视角梳理 WSL2 与原生 Windows 的取舍、CPU / GPU 路线、Ollama 与 llama.cpp 的简易玩法、NVIDIA 与 AMD 在 Windows 上的真实支持现状,以及常见故障排查与本地隐私安全要点。
 AI资讯
2026年,开源大型语言模型(LLM)依旧层出不穷,各种高速化技术也不断涌现,AI领域持续热闹非凡。本文将介绍两项技术:利用MTP技术加速的Gemma 4,以及在日本苹果Mac M4 Max 128GB上运行的DeepSeek V4 Flash(现称DwarfStar 4)。 Gemma 4借助MTP实现推理加速 今年春季,LLM领域在高速化和模型轻量化方面取得了显著进展。其中,Google发布
 AI资讯
AMD推出开源框架OpenClaw及两款硬件参考设计,支持开发者在本地PC上运行大型语言模型和多智能体工作流,提升隐私保护并减少对云端依赖。
 AI资讯
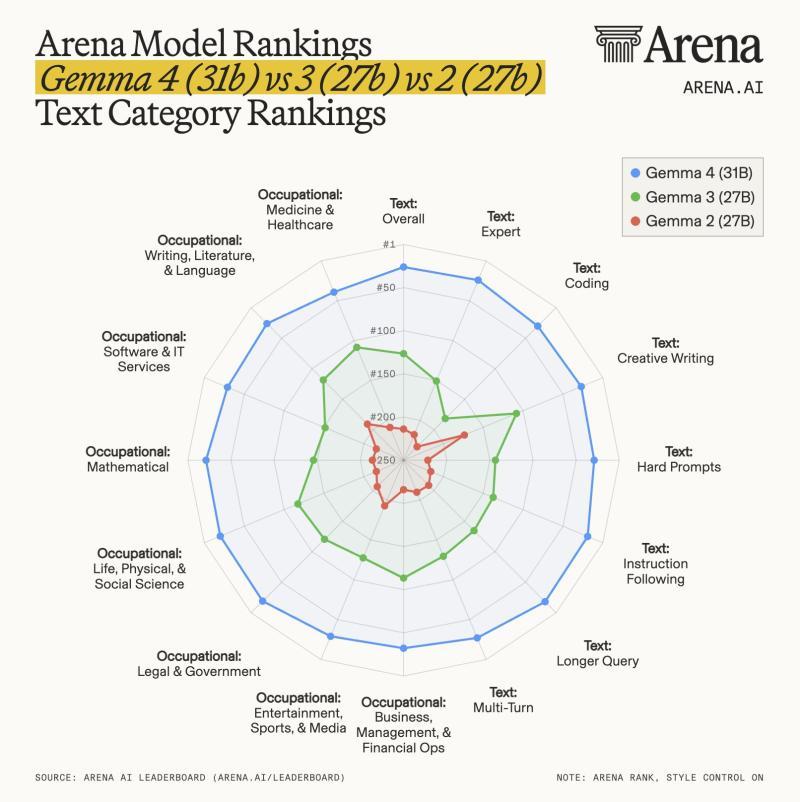
谷歌DeepMind发布了Gemma 4系列模型,带来显著性能提升和多模态支持,成为当前顶尖的开源模型之一。
 AI资讯
本文聚焦于Laguna S 2.1模型的发布及其在本地推理中的表现,探讨其技术优势和社区反响。