 AI资讯
AI助力停车违章处理!NVIDIA Agent Toolkit引领未来
在2026年COMPUTEX大会上,具备更强自主性的代理型AI成为了焦点。日本国家NVIDIA公司同时发布了专为Windows设计的SoC“RTX Spark”,以更好地支持这类代理型AI的运行。 本文将通过GTC Taipei记者说明会等渠道,分享关于AI代理及代理型AI的最新资讯。NVIDIA正通过其“NVIDIA Agent Toolkit”推动AI技术开创新未来。 让大型语言模型(LLM
按标签聚合查看文章内容。
AI资讯在2026年COMPUTEX大会上,具备更强自主性的代理型AI成为了焦点。日本国家NVIDIA公司同时发布了专为Windows设计的SoC“RTX Spark”,以更好地支持这类代理型AI的运行。 本文将通过GTC Taipei记者说明会等渠道,分享关于AI代理及代理型AI的最新资讯。NVIDIA正通过其“NVIDIA Agent Toolkit”推动AI技术开创新未来。 让大型语言模型(LLM
 AI资讯
日本SB C&S株式会社于10日宣布,正式开始代理Sparticle株式会社的本地部署型大型语言模型(LLM)平台“GBase on Spark”,该平台能够在不将机密数据发送到外部的情况下,安全地利用生成式AI。 “GBase on Spark”是一套结合了本地部署生成式AI解决方案“GBase On-premises”与包括NVIDIA AI基础设施“NVIDIA DGX Spark”
 AI资讯
在《纽约时报》对OpenAI提起的诉讼中,特朗普政府提交了一份20页的法律意见书,为ChatGPT开发商未经授权使用版权材料训练其大型语言模型(LLM)进行辩护。 该意见书指出:“美国有强烈的利益继续发展一个强大且具有竞争力的人工智能产业,该产业将成为全球人工智能使用规范和程序的标准……因此,美国必须‘保持在人工智能领域的全球领导地位’。”这段话引用了特朗普总统去年签署的一项行政命令。 驱动Cha
 AI资讯
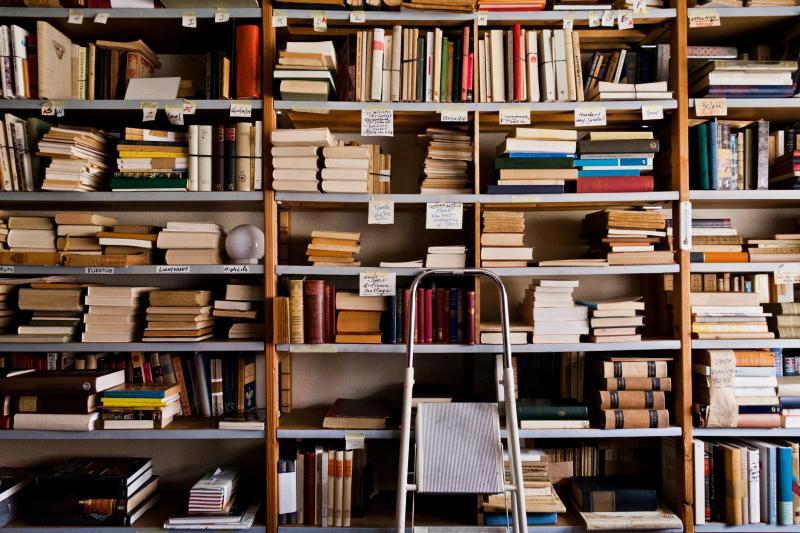
AI企业通过购买大量古籍,数字化内容用于训练大型语言模型,随后以惊人规模销毁这些书籍,引发业界关注。
 AI资讯
开源工具“Ollama”近日发布了v0.30.7版本更新,该工具支持在本地环境运行大型语言模型(LLM),兼容Windows、macOS和Linux系统,用户可从官方网站免费下载使用。 “Ollama”允许用户通过简单的命令下载并本地运行如“Gemma”、“Qwen”、“Llama”等开源大型语言模型,支持聊天和API调用,且基于MIT许可证开源开发,方便用户管理和使用本地模型。 此次更新的亮点
 AI资讯
据404 Media报道,亚马逊正在大量购买珍稀书籍,切断书脊后进行扫描,用于人工智能训练。404 Media通过在一本珍稀书籍中放置追踪器,追踪到该书最终被送往位于拉斯维加斯的亚马逊设施。 该设施名为VGT3,其标志是一只恐龙爪中抓着一本书。亚马逊向404 Media表示,他们“通过商业渠道购买书籍,以提升客户使用的产品和服务”。 像亚马逊这样的公司需要极其庞大的文本数据来训练大型语言模型(LL
 AI资讯
日本大型语言模型研究开发中心(LLMC)于8月18日发布了拥有约332亿参数的Dense型大型语言模型“LLM-jp-4”系列新模型“LLM-jp-4 33B”。该系列包含两个版本:基础模型“llm-jp-4-33b-base”以及经过后期训练的“llm-jp-4-33b-thinking”。 “llm-jp-4-33b-thinking”模型在预训练和中间训练基础上,进一步进行了监督微调(SF
 AI资讯
OpenAI近日公布了其即将发布的Astra模型的最新细节。该公司表示,Astra是首个达到其“关键网络安全门槛”的大型语言模型,准备很快面世。 OpenAI在博客中提到:“我们计划很快推出Astra,但其最先进的网络安全功能将限制部分用户访问。” 这款前沿实验室开发的模型能够在无人指导的情况下,发现并利用计算机系统中的未知安全漏洞。这一点与今年早些时候Anthropic对其Mythos模型提出的
 AI资讯
在实现通用人工智能(AGI)的道路上,现有的大型语言模型还远远不够。像ChatGPT和Claude这样的模型虽然在文本处理方面表现出色,但它们在理解事物如何在空间和时间中运动方面能力不足——而这正是实现具备泛化能力的智能所必需的关键技能。令人意外的是,这一缺口或许可以通过游戏数据来填补。 这正是总部位于纽约、获得贝索斯支持的初创公司General Intuition的核心理念。该公司估值达23亿美
 AI资讯
随着强大的大型语言模型(LLMs)变得触手可及,网络上恶意行为者散布垃圾信息变得比以往任何时候都容易。如果你在过去几年里花过大约10分钟上网,你就会发现垃圾信息和机器人内容的问题比以往更加严重。 Reddit表示,他们开发了基于大型语言模型的工具来减少垃圾信息,而这些垃圾信息本身很大一部分也是由大型语言模型生成的。这种做法有些讽刺,但在人工智能时代,平台别无选择,只能以火攻火。据该平台称,Redd
 AI资讯
今年六月,Meta正式进军企业级AI市场,推出了一款面向企业的AI代理,旨在协助客户服务、支持及日常运营。然而,Meta首席执行官马克·扎克伯格在周三的第二季度财报电话会议上表示,公司的企业AI野心远不止于此。 扎克伯格指出:“我们看到向企业销售的巨大机会,包括API、业务代理,甚至可能直接销售计算资源,以及为大型客户打造的其他服务。”这些举措有望为Meta开辟除广告和订阅之外的新收入来源,广告目
 AI资讯
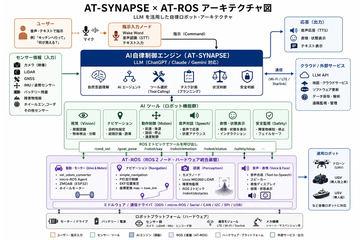
AT-SYNAPSE是一款基于大型语言模型(LLM)的机器人自主控制系统,支持多种LLM接入,实现自然语言指令理解与自主决策。