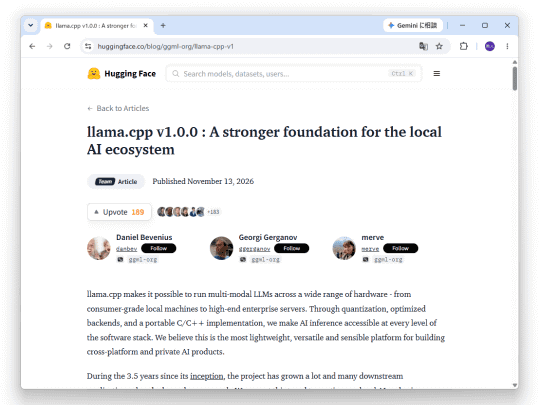
2023年11月13日,大规模语言模型(LLM)推理引擎“llama.cpp”正式发布了v1.0.0版本。与此同时,面向机器学习的张量库“ggml”也同步发布了v1.0.0版本。
“llama.cpp”是一个基于C/C++实现的开源LLM推理引擎。通过量化技术和优化后的后端支持,它能够在从普通个人电脑到高端服务器的多种硬件平台上运行多模态的大规模语言模型。目前,该项目已支持超过150种架构变体,成为本地AI应用的重要基础,广泛被众多应用程序采用。
未来版本将通过主版本号明确API不兼容变更
自2023年3月项目启动以来,经过约三年半的发展,越来越多开发者依赖该库的接口。此次v1.0.0版本的发布,体现了项目对开发者的责任感。
今后,“llama.cpp”和“ggml”将通过主版本号更新来标识API/ABI不兼容的重大变更,其他版本更新将遵循语义化版本控制规则:
- 主版本号:公开C API(./include)发生破坏性变更
- 次版本号:向后兼容的功能新增、后端更新、模型支持及API扩展
- 修订号:不涉及API变更的错误修复
针对Windows平台,除了GitHub提供的预编译二进制文件外,还支持通过“conda-forge”和“WinGet”等渠道安装。但根据官方发布策略,“WinGet”渠道提供的是夜间构建版本,非正式版本。
v1.0.0主要更新内容
- 删除了已废弃的公开API,可能导致旧代码无法直接编译
- 支持FP8格式的KV缓存
- 新增MoE模型专家缓存至主机内存的功能
- 支持文本模型“Kimi-K3.1-Pro”、“Ripple”、“xing4_0”,语音合成模型“drama-3”,图像识别模型“MageVL-Cowork”、“Kimi-K3.1”
- 加强“llama-server”的安全性,防范SSRF、CORS和DNS重绑定攻击
- 新增兼容OpenAI的语音合成端点“/v1/audio/speech”
- 全新设计的Web UI,支持将聊天内容按命名分组,输入时可实时预览Markdown格式
“ggml”v1.0.0版本也移除了废弃API,支持FP8格式,并在CUDA、Metal、Vulkan、SYCL、OpenCL、WebGPU等多个后端实现了性能优化。