 AI资讯
发布最大提升2倍速度的推理引擎“Magnitude”,实现硬件自动优化
Magnitude AI发布了面向AI代理的开源大型语言模型(LLM)推理引擎“Magnitude”。该引擎采用Apache-2.0许可证,完全免费使用,无需支付任何令牌费用。 Magnitude的核心优势在于其能够根据运行设备的硬件环境,自动在本地编译和调优内核。与llama.cpp、Ollama、LM Studio等常见推理引擎采用的通用预编译内核不同,Magnitude直接针对终端芯片进行
按标签聚合查看文章内容。
AI资讯Magnitude AI发布了面向AI代理的开源大型语言模型(LLM)推理引擎“Magnitude”。该引擎采用Apache-2.0许可证,完全免费使用,无需支付任何令牌费用。 Magnitude的核心优势在于其能够根据运行设备的硬件环境,自动在本地编译和调优内核。与llama.cpp、Ollama、LM Studio等常见推理引擎采用的通用预编译内核不同,Magnitude直接针对终端芯片进行
 AI教程
本文系统介绍如何将 DeepSeek 模型通过 vLLM、TGI 与 Ollama 三种开源推理引擎部署为稳定、安全、高效的生产级 API 服务,并深入解析批处理、并发、超时、限流、安全与监控等关键实践。
 AI教程
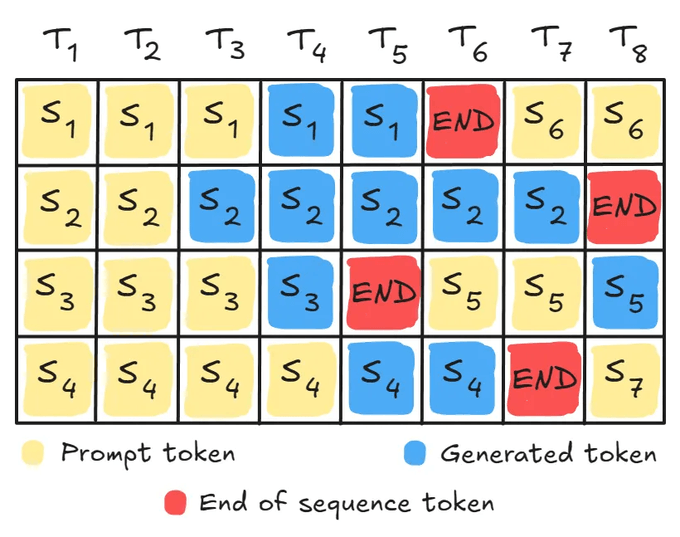
vLLM等推理引擎为什么几乎都默认启用连续批处理?核心在于把“批次”从一次性打包,改成每一步动态重建,让GPU不再为已经结束的请求白白烧显存和算力。本文从传统批处理讲起,拆解连续批处理的调度细节、KV缓存与抢占机制,以及如何用几个关键参数在延迟和吞吐量之间做取舍。