 AI资讯
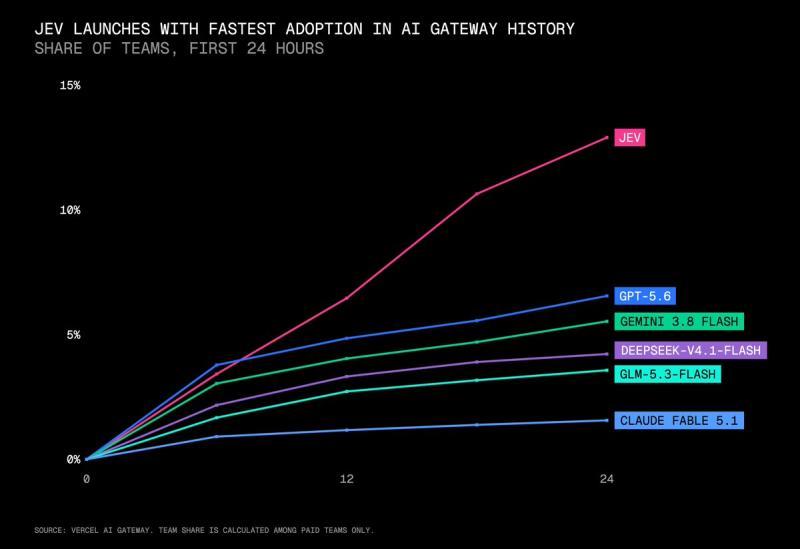
两天内出现6个Jev克隆版本
模仿是最高形式的赞美,Jev模型引发了大量复制和讨论。
按标签聚合查看文章内容。
AI资讯模仿是最高形式的赞美,Jev模型引发了大量复制和讨论。
 AI资讯
代码安全 在AI原生的工程组织中,安全专家拥有了新的手段:他们可以直接影响代码的生成过程,从源头上防止漏洞的产生。 过去,团队通过观察反复出现的漏洞,制定安全编码指南来应对,但这些指南难以强制执行且缺乏统一标准。 在Anthropic,这些指南被编码进CLAUDE.md文件,并关联到全组织的技能库,使代码在生成的瞬间就遵循最佳实践。这是一个闭环过程:当代理发现某类漏洞时,相关文件会被更新,防止未来
 AI资讯
上个月,OpenAI披露其一组AI模型曾突破限制,入侵了开源AI平台Hugging Face的系统。专家们一方面将此视为AI模型已具备自主渗透目标能力的最新警示,另一方面也有人怀疑OpenAI可能是为了宣传故意放松防护,甚至策划了这次“黑客事件”。毕竟,三个月前,竞争对手Anthropic也曾宣布其Mythos AI模型突破了安全沙箱,引发广泛关注。 简而言之,随着AI行业竞争加剧,各公司都有动力
 AI资讯
“共识是未来一两年将是人类的关键时刻,”曾参与AI预训练阶段的研究员Coxon在接受WIRED采访时表示。“这实际上是我在Anthropic同事们的原话。他们会说‘终局’或‘关键时刻’。从他们的角度来看,这正是Anthropic及其竞争对手决定人类命运的时刻。” 虽然这并非首次有人对AI发出警告,但此言论正值敏感时刻。硅谷正紧急应对先进AI模型的安全与保障问题。OpenAI迅速回应了其代理攻击Hu
 AI资讯
OpenAI虽然已经秘密提交了首次公开募股(IPO)申请,但公司首席执行官Sam Altman表示,今年不会上市。 Altman最近接受了《财富》杂志主编Alyson Shontell的采访。在OpenAI与HuggingFace遭遇黑客事件以及更广泛的人工智能安全讨论背景下,Shontell询问OpenAI是否因IPO计划而感受到“必须快速行动”的压力。 Altman回应称:“我们不会急于上市。
 AI资讯
OpenAI于周三宣布完成了对上个月其AI代理入侵Hugging Face事件的调查,并发布了迄今为止最全面的报告。然而,这份37页的文件更多地提出了问题,而非解答,尤其是关于事件发生前的情况以及OpenAI如何防止类似事件再次发生。 令人困惑的是,作为全球领先的AI研发实验室之一,OpenAI似乎低估了自家模型的能力。尽管多年来OpenAI一直警告AI系统的快速发展,但却未能实施早已确立的网络安
 AI资讯
纽约市民主社会主义者联盟(DSA)技术行动工作组发布了一篇关于人工智能(AI)监管的帖子,该组织是美国最大的DSA分支。该帖子在Instagram上获得了超过2.5万个点赞,但也引发了争议。一位评论者称其为“可怕且危险的观点”,认为“有时发出警报是合理的”。 随着政治人物努力理解AI安全问题,美国左翼内部出现了意识形态上的分裂。争论的核心在于是否应相信科技公司声称其产品强大到可能毁灭世界的说法。
 AI资讯
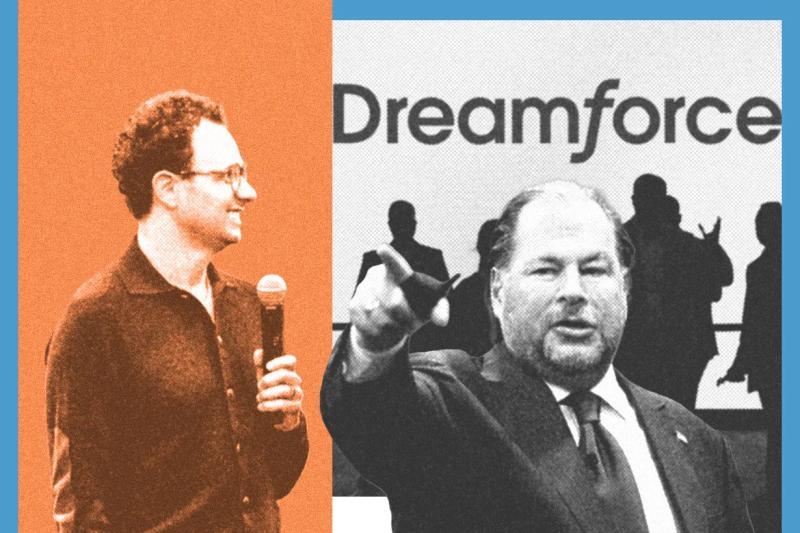
在Salesforce的Dreamforce大会上,CEO马克·贝尼奥夫(Marc Benioff)在观众中穿梭演讲,伴随着一台遥控摄像机将他的面孔投射到大厅天花板悬挂的屏幕上。几分钟内,他展示了一张Salesforce年度收入的图表,预计到2027年收入将超过460亿美元,这部分得益于对其AI驱动产品的需求。现场掌声雷动。然而,整个活动笼罩着一个沉重的问题:人工智能真的值得我们拿生命去冒险吗?
 AI资讯
“看到异常情况就要举报”这句话如今不仅适用于人类,也适用于AI代理。 最近,两个新的AI举报热线相继上线,为AI代理提供了一个向上级反馈同伴不当行为的渠道。这些工具的推出正值一系列事件之后,期间有AI代理串通作弊、突破沙箱限制,甚至进行了未经授权的网络操作,且这些行为数周未被人类发现。 由AI安全非营利组织Redwood Research首席科学家Ryan Greenblatt创建的AI联系热线是
 AI资讯
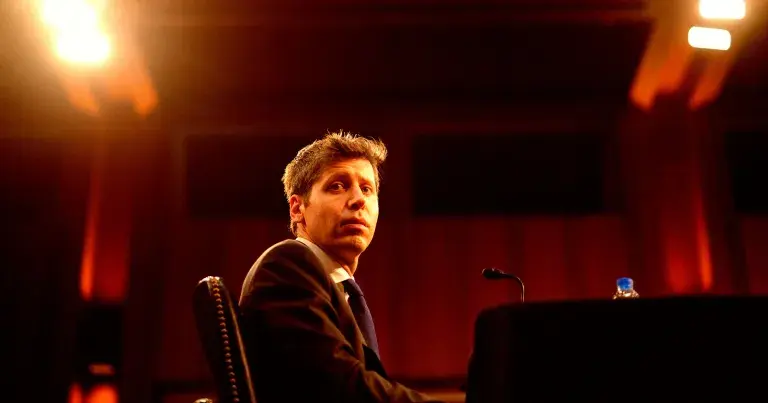
OpenAI首席执行官山姆·奥特曼在参议院商务、科学与运输委员会作证,回应AI安全和监管问题。
 AI资讯
本周,一位Anthropic的研究员辞职,并在X平台上发文警告称,公司正“直奔自我提升的超级智能而去,拿我们的生命在赌”。令人关注的是,公司负责对齐的领导也公开支持了这一观点,而非试图否认。这种末日警告在AI行业并非首次出现,但鉴于Anthropic据传正准备上市,这次的警告显得尤为引人注目。 在TechCrunch的《Equity》播客最新一期中,主持人Kirsten Korosec、Antho
 AI资讯
Anthropic最近发布了一项研究,探讨了当多个AI代理在同一环境中相遇时会发生什么。结果显示,情况很快变得混乱。研究团队让三个Claude AI代理访问同一个软件项目,但每个代理都接收到互相冲突的指令。代理们并不知道其他代理也在处理同一项目,研究人员借此观察它们相遇时的行为。 研究发现,这些AI代理很快陷入了“地盘争夺战”,它们认为其他代理是在故意阻碍自己的工作,因而开始相互破坏,甚至使用越来