 AI教程
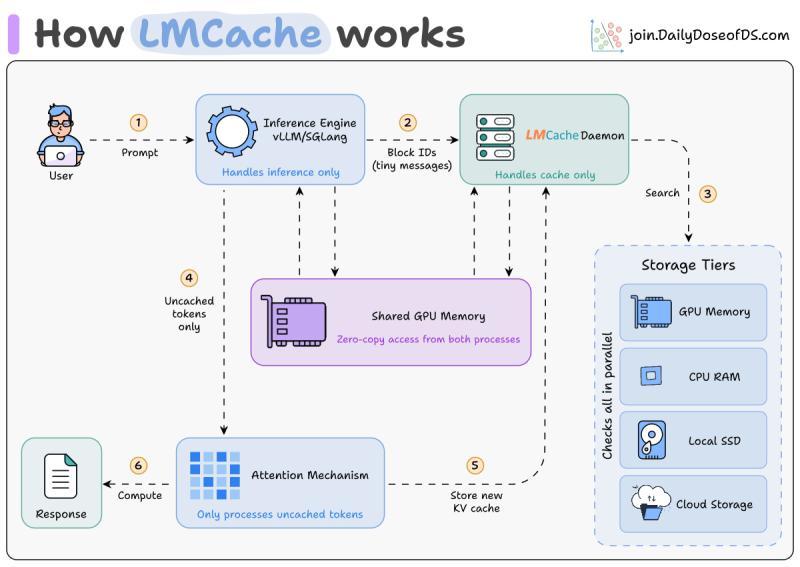
重新思考生产推理中的 KV 缓存:从前缀到 LMCache 架构
一份面向生产环境的 KV 缓存管理新思路:为什么 62% 的上下文是重复的、前缀缓存的天花板在哪里,以及 LMCache 如何用分离式架构和 CacheBlend 改写成本与性能曲线。
按标签聚合查看文章内容。
AI教程一份面向生产环境的 KV 缓存管理新思路:为什么 62% 的上下文是重复的、前缀缓存的天花板在哪里,以及 LMCache 如何用分离式架构和 CacheBlend 改写成本与性能曲线。
 AI教程
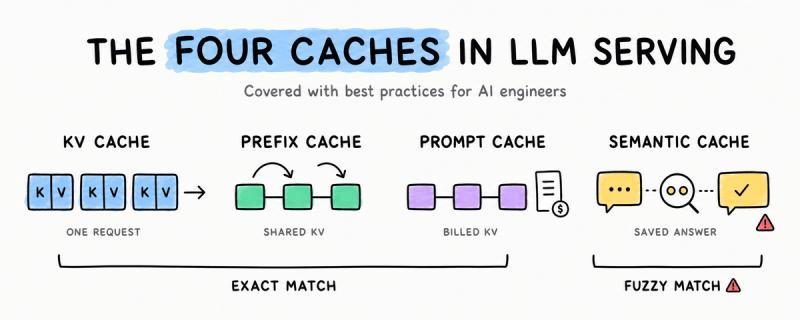
KV 缓存、前缀缓存、提示缓存、语义缓存听起来都叫缓存,但存的东西、命中规则和踩坑点完全不一样。本文用代码和案例拆开讲清楚:它们各自做什么、在哪一层省钱省时、以及在生产环境里最容易翻车的地方。
 AI教程
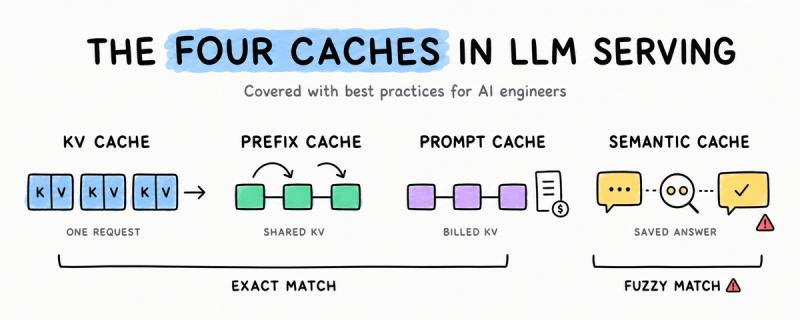
KV 缓存、前缀缓存、提示缓存、语义缓存到底差在哪?哪种能省钱,哪种可能悄悄帮你制造 bug?一文拆开底层机制和生产坑点。
 AI资讯
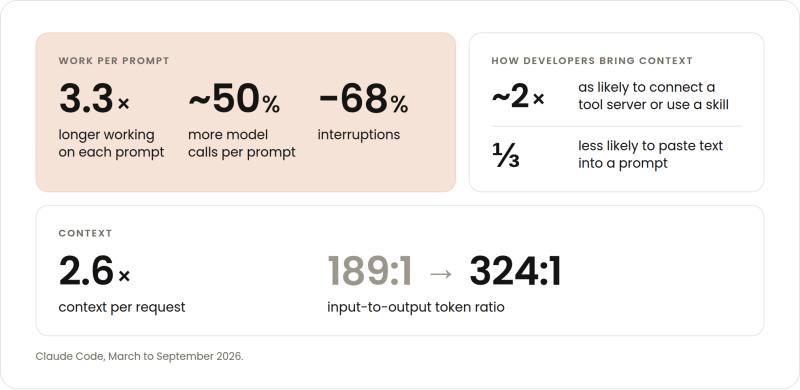
我们估计Claude Opus 5.5的运行成本比Opus 5低约40%,这是基于按token计费的典型工作负载得出的数据。对于开发者来说,节省的具体幅度尤为重要。 如果你是按token付费,成本差异在长时间运行且上下文丰富的会话中最为明显——这正是过去六个月里Claude Code会话日益增多的类型。 本文将深入探讨Opus 5.5如何在当前及未来的开发环境中,实现更高的成本效益。 Claude