SerpAPI自豪地带来本次报道:此次发布涵盖了大量内容,您可以将所有信息抓取为markdown格式以供代理使用,JSON令牌成本降低50%。
我们上次报道推理领域的重大转折是在今年4月,过去的进展多由闭源的独角兽公司推动,如Fireworks、Baseten和Modal。
如今,开源阵营迎来了回应。PyTorch大会首日,DeepSeek发布了其生产级推理框架DeepInfer,支持最长72小时的提示缓存,远超OpenAI刚宣布的12小时缓存。
DeepInfer基于vLLM进行了定制,融合了SGLang和TRRTLLM的贡献,并加入了大量优化,除去其核心的超高效KV缓存(紧凑且寿命超过8小时)、预填充/解码分离和负载均衡组件(其3FS存储系统此前已开源)。我们已翻译其官方博客,并在inf.latent.space发布了完整的研究指南、解释文档、代码地图和子系统指南。
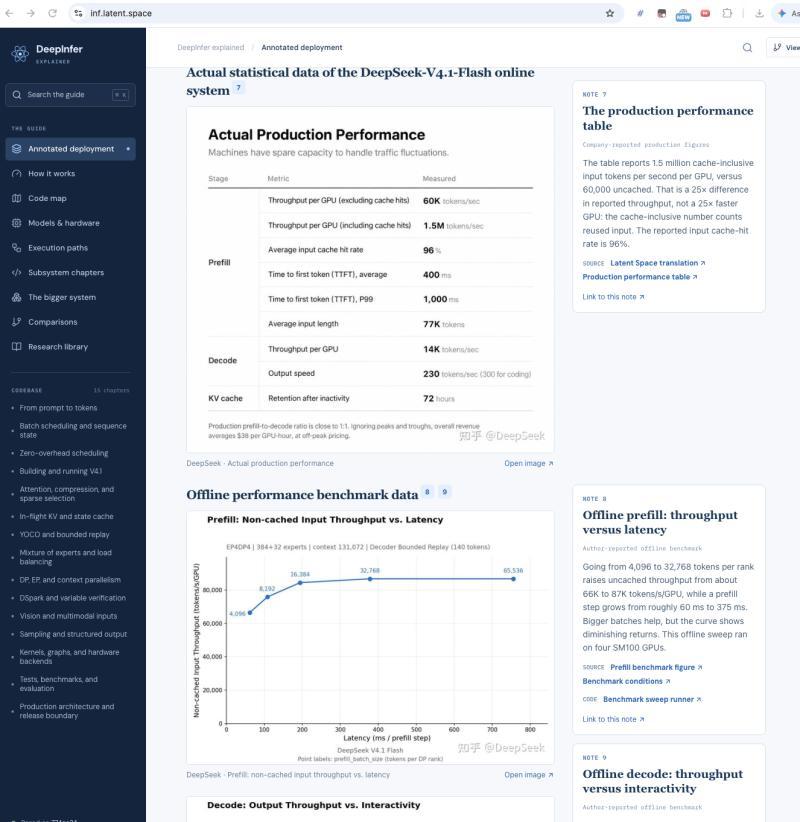
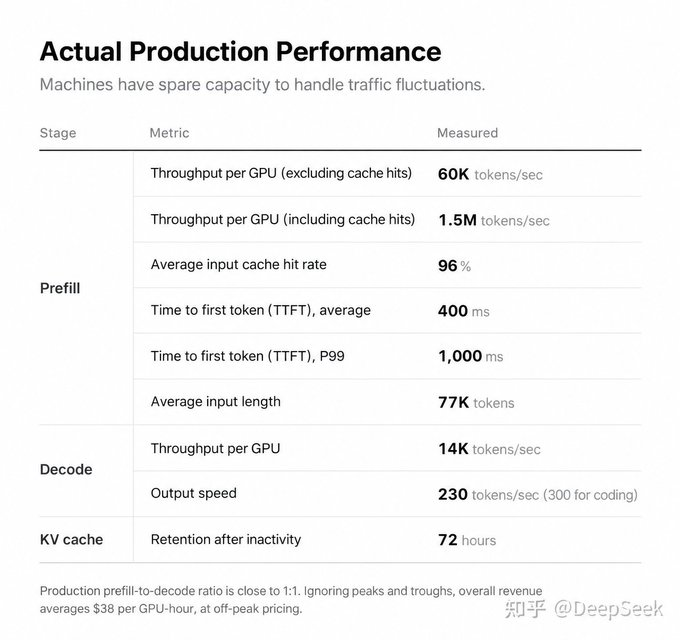
根据DeepSeek的披露,其单集群日处理155万亿令牌,按非高峰价格计算,每张SM100/A950卡每小时收入约38美元(当前输入/输出令牌价格分别为0.15美元/百万和0.60美元/百万,155万亿令牌*0.14美元混合成本/24小时约合每小时1百万美元)。结合其生产数据——每个预填充GPU每秒处理150万令牌(含缓存),输入缓存命中率达96%,每个解码GPU每秒生成1.4万令牌,集群规模约2400 GPU:
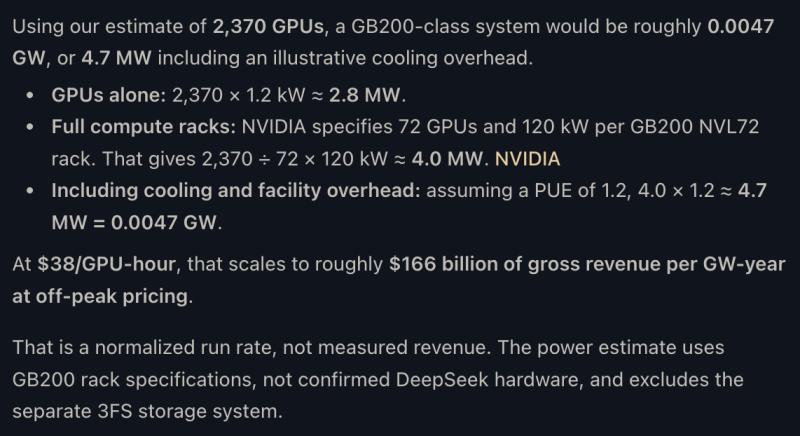
在每卡每小时成本5-8美元的情况下,推理利润率超过80%。
简单计算显示,推理利润率对应的每GW收入约1660亿美元,回本周期仅81天(DeepSeek计划10个月回本)。想象一下如果拥有更多GW计算资源,潜力巨大。
AI推特回顾
重大新闻:DeepSeek DeepInfer——生产推理引擎开源及缓存令牌经济学
事件概述
DeepSeek发布了DeepInfer推理引擎及API处理层,支持分布式推理、推测解码、SWA有界重放和结构化输出,兼容NVIDIA和华为昇腾平台。配套的deepseek-recipe组件实现了生产级令牌编码/解码和官方API兼容处理。未来更多模型推理优化也将开源。
生产数据报告显示,单集群日处理155万亿令牌,输入缓存命中率96%,平均首令牌延迟400毫秒,生成速率230令牌/秒,编码任务达300令牌/秒,非高峰时段每加速器小时收入38美元。需注意这些为DeepSeek自报数据,未经独立审计。
“完全开源”并不意味着完整生产服务可复现,关键的KV缓存管理和负载均衡组件尚未完全开源,仍依赖内部基础设施。
vLLM团队对DeepInfer进行了复现,解码吞吐量与DeepInfer相差不到6%,并发布了复现资源,表明现有开源引擎具备接近性能。
此次发布引发两大讨论:DeepSeek是否拥有独特的推理堆栈优势,以及其披露是否证明了推理的高盈利性。前者已有对比基准支持,后者则依赖工作负载、缓存计算、硬件成本及费用核算。
架构亮点
DeepInfer将视觉编码、预填充和解码分离,分别针对瓶颈扩展。推荐部署为8卡机器用于预填充,64-128卡超级节点用于解码。解码阶段采用宽专家并行分布MoE专家,保持大批量处理。调度基于计算资源而非令牌数,预填充调度估算注意力计算成本,路由不依赖缓存亲和性,解码路由平衡请求数和KV缓存长度。专家并行负载均衡通过复制热门专家减少等待。CPU调度异步覆盖加速器执行,减少空闲。
技术上,Blackwell配置未见张量并行,推测因早期互联限制。规模影响调度策略,宽专家并行需足够流量和工人,规模较小部署推荐流水线并行。
缓存层级设计
持久KV缓存存储于独立3FS集群,约100PB SSD容量,代理流量保留3天,聊天机器人流量保留7天。任何预填充工人均可访问缓存前缀,计算与存储解耦。缓存命中率高达96%,意味着155万亿令牌中绝大多数为缓存命中,实际新生成令牌远少。
缓存异步加载,采用GDR/RDMA传输以最大化PCIe带宽,滑动窗口注意力状态保留于主机内存,SWA有界重放仅重建最近128令牌的短期状态,近乎减半预填充计算量。
缓存设计权衡存储容量与重计算成本,解码阶段生成输出可转为后续可复用前缀。
推测解码与API兼容
DSpark实现自适应推测验证,提升6%吞吐量。deepseek-recipe支持多种API格式,区分真实控制令牌与用户文本,防止误解析,但非完整提示注入防护。
模型与运行时协同设计包括196B Engram参数,预填充激活约8B参数,解码16B参数,宽专家并行,极度压缩KV缓存,552B专家参数,DP64/EP64,45B常驻参数/设备,四位权重,KV缓存较基线减少400倍。
模型特定优化限制了通用性,建议针对不同模型采用专门的库和内核策略。
独立对比与社区反响
vLLM复现了DeepInfer的解码性能,差距不到6%,但未复现完整缓存和生产环境。社区反应多样,Tim Dettmers评价其推理堆栈与OpenAI相当,优于Anthropic;也有质疑部署细节和完整性。
经济效益分析
DeepSeek披露非高峰时段每加速器小时收入38美元。推理利润率估算在73.7%至96.1%之间,取决于缓存比例、硬件成本等假设。计算未包含SSD缓存、CPU、网络、闲置容量、故障、工程支持等成本。推理高利润率不代表整体公司盈利。
推测年收入可达数十亿美元,回本周期短,市场影响深远。
硬件支持与性能对比
确认支持华为昇腾,NVIDIA硬件推理效率尚无公开对比数据。性能分析显示GB200 GPU解码速度远超昇腾950DT,未来优化空间大。
预计2027年底DeepSeek将拥有超过1GW的Blackwell级计算资源。
V4.1 Flash模型表现
独立评测显示V4.1 Flash在多个开放模型排行榜中名列前茅,成本效益显著。网络安全任务中表现优于GPT-6 Sol,但效率和最佳表现存在争议。
本地部署方案如TrellisMX K2 Mix支持双RTX PRO 6000,采用多位专家和四位Engram权重,初步质量指标良好。
代理基础设施与本地执行
支持长上下文推理内核,AMD和Apple Silicon平台均有优化。OpenAI新增12小时API提示缓存,支持混合保留时间。
其他开源模型与工具发布
Meta发布30B多模态Muse Glimmer,Mistral推出Voxtral 3语音套件,Bria发布8B图像模型Fibo 2.0,Krea 3 Ultra图像编辑模型表现优异。
独立评测与安全性
HealthBench发布健康对话评测,DeepSeek成本低于竞争对手。多路由器选择显示潜在性能提升空间。安全评估建议加强端到端红队测试。
科学代理与开放研究
Anthropic公布蝎毒素结合蛋白设计实验数据,Sophont发布Holon-S1空间基因预测模型。AI辅助科研仍面临创造力和判断力挑战。
行业动态
OpenAI收购Orchestra Bio,扩展生命科学运营能力。Arda公开制造软件,获得1.6亿美元A轮融资。OpenAI和Anthropic均在寻求巨额融资,计算资源投入巨大。
AI Reddit回顾
/r/LocalLlama 和 /r/localLLM 热点
-
DeepSeek开源DeepInfer推理框架,支持DeepSeek V4.1 Flash,单集群日处理155万亿令牌,非高峰时段每卡小时收入38美元。社区关注其是否为通用推理框架及其实际性能。
-
MiniMax M3.1 Flash发布,采用MoE架构,参数规模达428B,支持稀疏注意力和视觉编码。
-
AI基准测试存在6.4%平均分数膨胀,主要因实验环境差异和优化策略。
其他子版块摘要
- Opus 5.5实现自动化完成《博德之门3》游戏,展示长时任务执行能力。
- AI辅助逆向工程实现经典游戏浏览器运行,社区质疑是否真正反编译。
- 数学家Richard Borcherds认为AI辅助数学证明暴露了人类认知局限。
- 物理学家利用Claude AI辅助验证量子引力计算,强调AI作为审计工具。
- 提醒用户警惕AI代理连接邮箱和云盘的安全风险,防范提示注入攻击。
DeepSeek DeepInfer的开源发布,展示了中国团队在大规模推理技术和经济效益上的领先探索,推动了开源生态与产业应用的深度融合。