我们估计Claude Opus 5.5的运行成本比Opus 5低约40%,这是基于按token计费的典型工作负载得出的数据。对于开发者来说,节省的具体幅度尤为重要。
如果你是按token付费,成本差异在长时间运行且上下文丰富的会话中最为明显——这正是过去六个月里Claude Code会话日益增多的类型。
本文将深入探讨Opus 5.5如何在当前及未来的开发环境中,实现更高的成本效益。
Claude Code的趋势
我们统计了2026年3月至9月期间开发者使用Claude Code的整体数据。随着模型能力的提升,开发者部署代理的方式也越来越复杂。每次会话的提示数量保持稳定,但我们发现了一些有趣的现象:
- Claude每个提示的工作时间延长了3.3倍,模型调用次数增加了40%以上,中断次数减少了68%。
- 开发者连接工具服务器或使用技能的概率约为之前的两倍,粘贴文本到提示中的概率减少了三分之一。
- 每次请求的上下文长度增长了2.6倍,输入与输出token的比例从189:1提升到324:1。
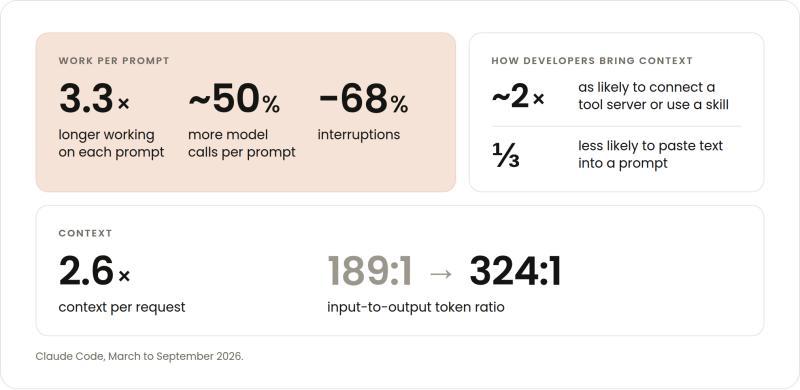
这些数据表明,开发者正让Claude更努力、更智能地处理更大、更开放式的任务。对于这类会话,上下文工程的经济效益尤为显著。
简单来说,Claude需要读取更多token。你必须确保提供的所有上下文都是必要的,并尽可能让这些上下文从缓存中读取。
Opus 5.5为何在长时间、高上下文会话中更具成本效益
使长时间、高上下文会话更具成本效益的因素主要有三:定价调整、模型行为优化以及Claude Code的改进。下面逐一说明。
缓存成本更低
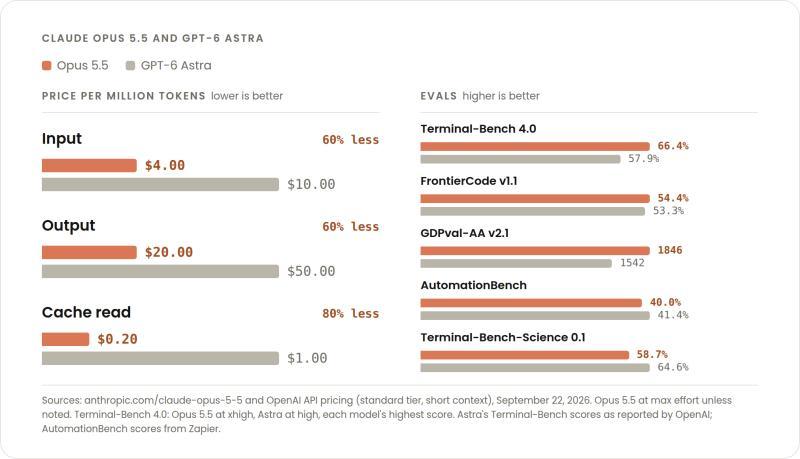
对于按token计费的用户,我们降低了输入和输出token的费用20%,并且将缓存token的读取价格降低了60%。后者尤为重要,因为缓存读取占据了代理和编码工作成本的大部分。
正如前文所述,过去六个月中每次请求的上下文长度增长了约2.6倍,这意味着节省效果正朝着正确方向发展。相同的价格调整对当前Claude Code流量的节省比六个月前更明显,因为账单中更多部分是重复读取的上下文。
截至本文发布,Opus 5.5的缓存token成本仅为竞争模型的五分之一,同时性能更优。
Claude Code更善于利用缓存
这不仅是Opus 5.5的特点,也是过去六个月我们为Claude Code新增功能的成果。鉴于编码会话的趋势,本应出现更多缓存未命中的情况,但实际情况相反——缓存未命中的输入减少了超过50%。
例如,我们减少了因刷新登录等小操作导致缓存失效的情况,也降低了在会话中途添加指令或按需加载工具等大操作破坏缓存的概率。对于Opus 5.5和Fable 5.1等新模型,用户可以在会话中调整努力程度而无需重置缓存。
我们还增强了缓存对长时间运行和委托会话的支持。使用API密钥和云服务的开发者现在可以设置一小时的缓存生命周期(订阅用户已具备此功能),且分叉的子代理会从父代理的缓存开始,避免重复计费。
同样的任务,减少交互次数
Opus 5.5完成相同任务所需的交互次数少于其他模型。Zeta Labs发现,Opus 5.5在完成任务时所需的交互和工具调用次数均少于Opus 5,成本几乎减半,且完成了更多复杂任务。
这并非适用于所有任务。正如Addy在《Opus 5.5任务成本》中所述:“对于范围明确的任务,两款模型完成所需的交互次数相近,节省的主要是价格。差异最大的是开放式任务,模型可能在错误思路上浪费多次交互。不同代码库表现不同,需自行测量。”
换言之,简单、短小、机械化的任务交互次数相同,而复杂、耗时的任务则更有可能通过Opus 5.5避免浪费token。减少一次交互比缓存token更节省成本。
此外,值得一提的是,Opus 5.5生成输出的速度比Opus 5快30%以上。虽然这不会提升缓存命中率或减少token使用,但能显著缩短长时间运行的等待时间。
保护你的缓存读取
随着代理编码的成熟,企业已从追求无限扩展转向追求高效扩展。你可以在Claude Code中运行/usage命令,查看使用中缓存读取占比,然后采取措施保护这一比例:
- 会话开始时选择模型,避免中途切换;
- 离开前进行上下文压缩,而非事后;
- 使用API密钥或云服务时,为长会话设置一小时缓存生命周期。
将Opus 5.5应用于开放式、高上下文的任务,养成上述习惯,效果更佳。详情请参见《Opus 5.5任务成本》。