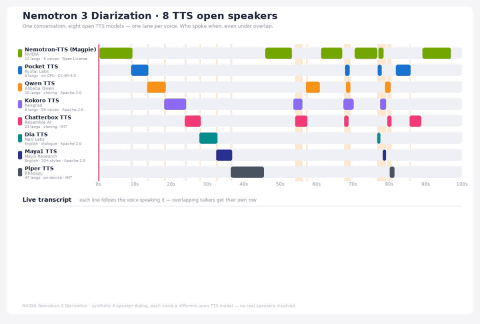
在会议录音转文字时,常常遇到无法区分“谁在什么时候发言”的问题。为此,日本NVIDIA于9月24日(日本时间)免费发布了参数量仅为0.1B(1亿)的AI模型——Nemotron 3 Diarization。该模型即使在多声重叠的情况下,也能追踪最多8位发言者。模型权重已在Hugging Face平台开放下载,且允许商业使用。
Nemotron 3 Diarization是一款专门用于识别音频中“谁在何时发言”的AI模型,参数量为0.1B。此类处理称为“说话人分离”,广泛应用于会议记录整理和呼叫中心通话分析,帮助将发言内容与发言者对应起来。该模型支持离线批量处理录音文件,也支持会议中实时流式处理,最多区分8位说话人。模型本身不进行文字转写,但可与自动语音识别(ASR)结合,实现带有说话人标签的会议记录生成。
在流式处理模式下,用户可选择三种延迟设置来决定判定发言者的时间延迟。推荐的最短设置仅需0.32秒音频即可输出判定结果。延迟设置为0.64秒和1.04秒时,模型可利用更长的上下文信息,从而提升识别准确率。
对于录音文件的离线处理,默认每次处理30.4秒音频,结合流式处理的三种延迟设置,共有四种模式可选,其中离线模式的准确率最高。输入音频要求为16kHz单声道,支持wav、flac、opus、mp3格式,且通过分段处理可无限制处理长时录音。
Nemotron 3 Diarization在准确率上显著优于以往模型。在涵盖11个领域音频的基准测试“DIHARD III”中,离线模式下的错误率(DER)为12.73%,相比支持最多4人识别的旧版Streaming Sortformer v2.1的19.09%有明显提升。
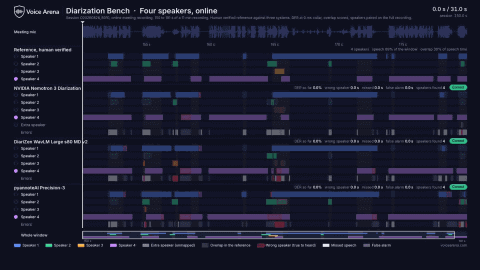
第三方评测中,Nemotron 3 Diarization同样表现优异。在Voice Arena的“Diarization-Bench”首轮测试中,12个系统中排名第一,错误率14.72%,比第二名低约24%。
该模型核心采用基于Transformer的“Sortformer”架构。它按照发言顺序给说话人编号,确保同一声音在音频中不会被混淆。流式模式下,模型通过“Arrival-Order Speaker Cache (AOSC)”保存已出现说话人的声音特征,即使会议时间较长,也能持续准确追踪同一说话人。
Nemotron 3 Diarization支持在普通PC上运行。配套轻量级C++执行环境“NeMo-Speech.cpp”可通过简单命令完成说话人判定及带标签的文字转写。模型也原生支持Hugging Face的Transformers库。推荐硬件为搭载NVIDIA GPU的系统,GeForce系列从RTX 3050至RTX 5090均可支持。
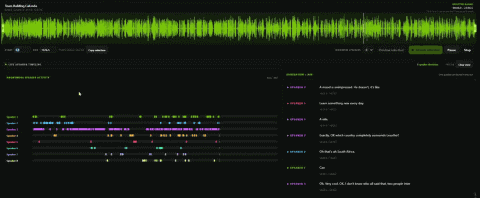
该模型采用Linux基金会旗下项目制定的“OpenMDW-1.1”许可证,允许商业及非商业免费使用,对模型生成的输出无使用限制。训练数据覆盖英语、中文、印地语等多种语言,但未包含日语。用户可通过浏览器公开演示测试其在日语会议中的表现。
Nemotron 3 Diarization主要规格
- 获取方式及许可:可从Hugging Face的“nvidia/Nemotron-3-Diarization”免费下载安装,许可证为OpenMDW-1.1,支持商业和非商业用途
- 模型规模及支持说话人数:参数量0.1B,最多支持8人同时说话的判定
- 支持处理方式:支持离线批量处理和流式逐次处理,流式延迟可选0.32秒、0.64秒、1.04秒,离线处理默认30.4秒
- 输入格式:16kHz单声道音频(wav/flac/opus/mp3),支持分段处理无限长录音
- 本地运行环境:支持C++执行环境NeMo-Speech.cpp、NVIDIA NeMo及Hugging Face Transformers