由日本国家的ChatGPT联合创始人之一Diogo Almeida创立的初创公司TypeSafe AI,于9月15日发布了一种全新类别的AI模型“Jev”。这款被称为“不会生成文本的AI模型”引起了极大兴趣。本文将深入探讨Jev的工作原理及应用。
Jev:不生成文本,仅返回带类型的决策结果
通常我们使用的大型语言模型(LLM)主要任务是生成文本,但Jev则不同。TypeSafe称其为“System One Model”新类别的首款产品,它不逐步生成token,而是直接返回预先定义类型的“决策(decision)”。
具体来说,应用程序传入当前状态(state)和预设问题(questions),Jev会返回每个问题对应的Yes/No概率、选项选择或评分值。由于输出格式事先确定,避免了格式混乱的问题,也就杜绝了幻觉(hallucination)的发生。
性能方面,Jev比前沿LLM快40至200倍,延迟在70毫秒到500毫秒之间,输入成本为每百万token约0.042美元(约6.6日元,按1美元=157日元换算),输出免费。注册账户即赠送5美元余额,价格亲民,适合游戏、机器人、仿真等需要实时高速“判断”的场景。
Jev支持三种问题类型:
- Noul:Yes/No判定(带概率)
- Choice:从多个选项中选择一个(带各选项概率)
- Score:在评分尺度上的位置判定(带各等级概率)
这些回答不是用文本描述,而是以类型化的答案直接返回,旨在替代传统LLM生成文本后再解析的流程,简化分类、路由和评分等任务。
作者曾在开发Seedance 2.0时,将带时间线的提示词转换为LTX-2.3格式,也用到了将状态和验证信息传给LLM并以JSON格式返回判断结果的做法。使用Jev能让这类流程更简单、更快速。
以下是官方文档示例,输入状态为:
“Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.”
针对该文本,分别提出三个问题:“是否紧急(Noul)”、“应由哪个部门处理(Choice)”、“客户的愤怒程度(Score)”。
Noul(是/否)示例:
判断是否紧急。
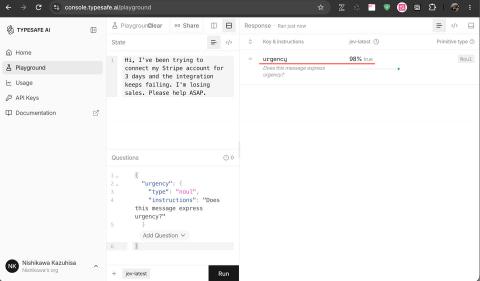
{
  "urgency": {
    "type": "noul",
    "instructions": "Does this message express urgency?"
  }
}
结果显示紧急度为98%。
Choice(选择部门)示例:
判断应由哪个部门处理,选项包括billing(支付/订阅)、technical(故障/集成问题)、sales(价格/账户)。
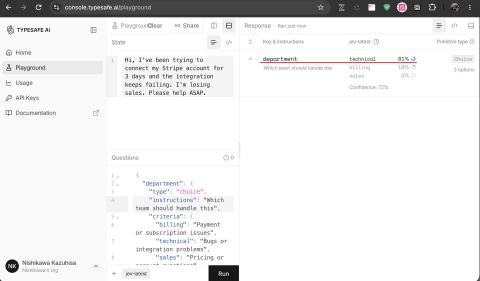
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this",
    "criteria": {
      "billing": "Payment or subscription issues",
      "technical": "Bugs or integration problems",
      "sales": "Pricing or account questions"
    }
  }
}
模型选择了“technical”,概率为81%,billing为19%,sales为0%,置信度72%。返回了判断结果、概率分布及置信度。
Score(愤怒程度评分)示例:
判断客户愤怒程度,分为Calm(平静)、Frustrated(烦躁)、Very angry(非常愤怒)三档。
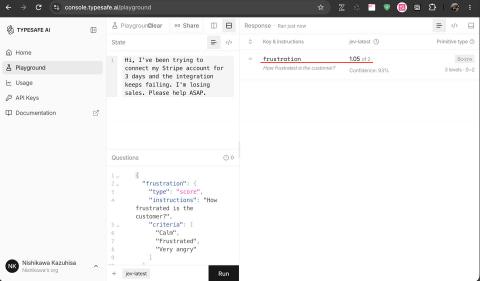
{
  "frustration": {
    "type": "score",
    "instructions": "How frustrated is the customer?",
    "criteria": ["Calm", "Frustrated", "Very angry"]
  }
}
返回评分1.05,接近“烦躁”级别。
这三个问题可以分开或合并一次性发送,方便快速获得紧急度、处理部门和愤怒程度的结构化数据,远比传统LLM生成自由文本再解析更高效。
Jev支持API调用,提供Python SDK(pip install typesafe-sdk),方便集成。
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer
Content-Type: application/json
本地运行的兼容模型laya-mlx体验
Jev发布后,社区迅速出现了兼容模型。作者尝试了开源模型laya-mlx,它模仿Jev接口,输入state+questions,输出choice/score/noul结果。
| 特性 | Jev (TypeSafe AI) | laya-mlx (Laya) |
|---|---|---|
| 输入 | state + questions | state + questions(同名键) |
| 问题类型 | noul/choice/score | 同上 |
| 输出 | 概率、选项、评分+置信度 | 概率、选项、期望评分+置信度 |
| 特色 | 不生成文本,返回类型化决策,无幻觉 | 同上,直接从决策头输出,无token生成 |
| 模型大小 | 未公开 | 421M FP16 英文,322M FP16 多语 |
laya-mlx基于Convai Innovations的Laya决策模型,已在Apple Silicon上本地运行,模型权重公开,体积小,方便测试。
用Python测试“是否紧急”问题:
pip install laya-mlx
import laya_mlx as laya
agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
  "Help! My payouts have been failing for 3 days.",
  {
    "is_urgent": {
      "type": "noul",
      "instructions": "Does this convey urgency?",
    }
  },
)
print(result["answers"]["is_urgent"])
结果显示置信度为0.7411,虽然低于Jev的0.98,但同样判断为紧急,验证了模型可用性。
用类型化决策驱动贪吃蛇游戏
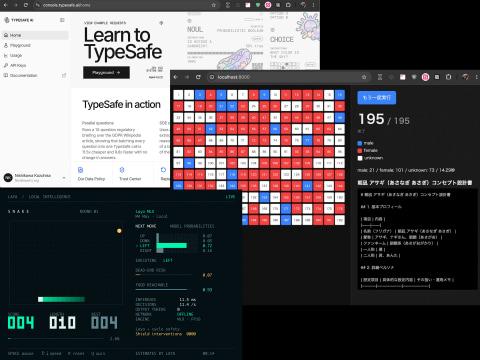
laya-mlx提供了一个名为laya-snake的演示,控制贪吃蛇游戏自动移动。游戏规则是避免撞墙和撞到自己。
模型每步返回三个判断:
- choice:选择安全的移动方向
- noul:是否面临死路风险
- noul:是否还能到达食物
游戏状态先由规划器转换为特征量,模型不直接处理像素。选择概率最高的安全动作执行,若模型选出危险动作,安全机制会介入。
该演示展示了类型化决策模型在实时循环中稳定运行的能力,契合Jev面向游戏、机器人和仿真等实时判断场景的定位。
自制实时性别判定演示
为了验证速度和实用性,作者用Hugging Face上的日本虚拟AI主播人格数据集(195条)做性别判定演示。该数据集没有结构化性别字段,传统AI处理较困难。
用laya-multilingual-mlx模型(多语版)对每条数据进行choice判定(男性/女性/不明),实时显示结果颜色(蓝=男,红=女,白=不明),并显示当前处理条目和文本片段,直观体现实时判定效果。
同时用Qwen3.8-27B+LM Studio做对比,后者通过生成JSON文本再解析,处理速度远慢于laya-mlx,且偶尔出现格式错误。
laya-mlx更倾向于在不确定时返回“不明”,而大型通用LLM则更倾向于强行判定为男性或女性。
尽管两者模型规模和定位不同,但这次测试证明了类型化决策模型在实际数据上的有效性和优势。
展望与总结
目前Jev仅支持文本输入,不支持图像或视频。但如果未来支持视觉输入,应用场景将大幅拓展。例如,将监控视频作为状态输入,直接用类型化问题判断“是否有人”、“性别”等,省去文本转换步骤,提升速度和准确度。
laya-mlx生态中已有集成图像编码器的派生项目Laya Vision,支持图像输入的类型化决策,显示了这一方向的可行性。
总的来说,Jev和laya-mlx代表了一种全新的AI交互思路:不生成文本,而是直接输出结构化决策,简化开发流程,提升响应速度。作者计划将其应用于现有项目,如微剧本生成系统,期待带来更高效的体验。
相关代码和演示已开源,感兴趣的读者可访问:https://github.com/knishika62/laya-mlx-demo