人工智能正在重塑世界,同时也创造了一套全新的语言来描述其运作方式。无论是参加产品会议、推介会还是讨论小组,你都会听到人们频繁提及LLM(大型语言模型)、RAG(检索增强生成)、RLHF(基于人类反馈的强化学习)等术语。最近,OpenAI新发布的Astra模型中采用的“不透明递归”推理技术引发了AI安全研究人员的关注和担忧。AI领域的术语更新速度极快,甚至让技术圈内的专家也感到些许不安。
本文旨在为你提供一份简明易懂的AI术语词汇表,无论你是从事AI开发、投资,还是通过阅读科技新闻或收听相关播客来了解AI,都能从中获益。我们会随着领域的发展不断更新这份词汇表,使其成为一份“活文档”,就像它所描述的AI系统一样。
AGI(人工通用智能)
AGI是一个模糊的概念,通常指的是在多数任务上能力超过普通人的AI。OpenAI CEO Sam Altman曾将AGI形容为“你可以雇佣作为同事的普通人类”。OpenAI的章程中定义AGI为“在大多数经济价值工作上超越人类的高度自主系统”。谷歌DeepMind则认为AGI是“在大多数认知任务上至少与人类同等能力的AI”。即使是AI领域的顶尖专家,对AGI的定义也存在分歧。
AI代理(AI Agent)
AI代理是指能够代表用户执行一系列任务的AI工具,超越了简单聊天机器人的功能,比如报销、订票、预订餐厅,甚至编写和维护代码。这个领域仍在快速发展,基础设施尚未完全完善。基本上,AI代理是一个自主系统,可能会调用多个AI系统来完成多步骤任务。
API端点
API端点可以理解为软件背后的“按钮”,其他程序可以通过调用这些接口让软件执行特定操作。开发者利用API构建集成,例如让一个应用获取另一个应用的数据,或让AI代理直接控制第三方服务。随着AI代理能力提升,它们能自主发现并使用这些端点,带来强大且有时意想不到的自动化可能。
思维链(Chain of Thought)
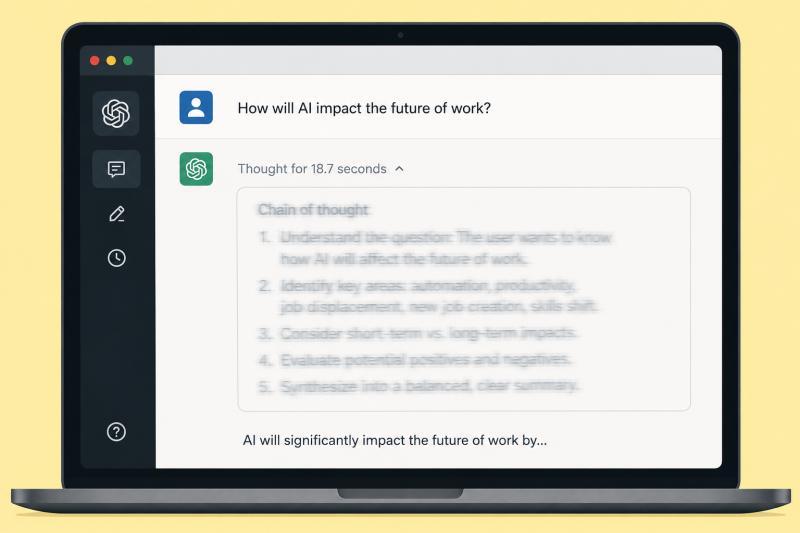
人类在回答简单问题时往往不需要过多思考,但复杂问题通常需要分步骤推理。AI中的思维链推理指将问题拆解为多个中间步骤,以提升最终答案的准确性,尤其在逻辑推理或编程场景中效果显著。此类模型基于传统大型语言模型,通过强化学习优化思维链能力。
编码代理(Coding Agents)
编码代理是AI代理的一个专门应用,能够自主编写、测试和调试代码,完成开发中的反复试验工作。它们可以跨整个代码库工作,发现漏洞、运行测试并推送修复,极大提升开发效率,但仍需人工审核。
计算能力(Compute)
计算能力通常指支持AI模型运行的计算资源,包括GPU、CPU、TPU等硬件。这些硬件为AI训练和部署提供动力,是现代AI产业的基础。
深度学习(Deep Learning)
深度学习是机器学习的一个子领域,采用多层人工神经网络结构,能够自动识别数据中的重要特征,并通过反复学习不断优化输出。相比传统机器学习,深度学习需要大量数据和更长训练时间,成本较高。
扩散模型(Diffusion)
扩散技术是许多生成艺术、音乐和文本的AI模型核心。它模仿物理学中的扩散过程,通过逐步加入噪声“破坏”数据结构,再学习逆向过程从噪声中恢复数据,实现生成任务。
蒸馏(Distillation)
蒸馏是一种通过“师生模型”提取大型AI模型知识的技术。通过让学生模型模仿教师模型的输出,训练出更小、更高效的模型。OpenAI的GPT-4 Turbo即采用了此技术。
微调(Fine-tuning)
微调是对已有AI模型进行进一步训练,以优化其在特定任务或领域的表现,通常通过引入专门的数据完成。许多AI初创企业以大型语言模型为基础,通过微调提升产品针对性和实用性。
生成对抗网络(GAN)
GAN由两个神经网络组成,一个生成数据,另一个判别真假,二者相互竞争,提升生成数据的真实性。GAN适合生成逼真的图像或视频,但不适用于通用AI。
幻觉(Hallucination)
幻觉指AI模型生成错误或虚假的信息,是AI质量的重大挑战。幻觉可能导致误导性输出,甚至带来现实风险,如错误的医疗建议。为减少幻觉,业界倾向开发更专业化的垂直领域AI模型。
推理(Inference)
推理是运行AI模型以做出预测或结论的过程,必须基于训练完成的模型。推理可在多种硬件上执行,但大型模型通常需要高性能服务器支持。
大型语言模型(LLM)
大型语言模型是驱动ChatGPT、Claude、谷歌Gemini、Meta Llama、微软Copilot等AI助手的核心。它们由数十亿参数组成,学习词语间关系,基于海量文本数据生成语言输出。
内存缓存(Memory Cache)
内存缓存是一种优化推理效率的技术,通过保存部分计算结果减少重复计算,提升响应速度。KV缓存是常见的缓存类型,广泛应用于基于Transformer的模型。
模型上下文协议(MCP)
MCP是一个开放标准,允许AI模型连接外部工具和数据,无需为每种组合开发专门接口。由Anthropic提出并交由Linux基金会管理,已被OpenAI、谷歌和微软采纳。
专家混合模型(MoE)
专家混合模型将神经网络拆分为多个专门子网络,仅激活部分专家处理任务,提升模型效率和速度。Mistral AI的Mixtral和OpenAI的新型GPT模型据称采用了此架构。
神经网络(Neural Network)
神经网络是深度学习的基础,灵感来源于人脑神经元连接结构。GPU的兴起推动了多层神经网络的发展,使AI在语音识别、自动导航、药物研发等领域表现卓越。
神经语(Neuralese)
神经语是假设的极端情况,模型完全用内部数字表示推理,无法用人类语言解释,导致思维过程成为黑箱。目前无已发布模型采用此方式,OpenAI的Astra模型虽使用不透明递归,但仍保持思维链可读。
不透明递归(Opaque Recurrence)
不透明递归指模型反复将同一查询在内部层循环处理,而非逐步用自然语言推理。这种方法计算效率高,但减少了可读的推理轨迹,增加了安全监管难度。
开源(Open Source)
开源指软件或AI模型的代码公开,任何人都可使用、检查和修改。Meta的Llama是开源AI模型的代表。开源促进了全球合作和安全审计,是AI行业的重要议题。
并行化(Parallelization)
并行化指同时执行多项任务,是现代GPU设计的核心,使训练和推理更快更高效。随着模型规模扩大,优化并行策略成为关键研究方向。
内存危机(RAMageddon)
内存危机描述了RAM芯片供应紧张的现象,因AI行业大量采购导致游戏、消费电子和企业计算等领域面临内存短缺和价格上涨问题,短期内难以缓解。
递归深度(Recurrent Depth)
递归深度是“不透明递归”的工程术语,指模型多次循环处理同一输入。媒体报道中两者常被交替使用。
递归自我改进(Recursive Self-Improvement)
递归自我改进指AI模型自主提升自身能力的过程,可能带来能力爆发和高度自治。尽管部分初创企业致力于此,普遍将其视为研究前沿而非灾难性事件。
强化学习(Reinforcement Learning)
强化学习通过奖励机制训练AI,模型通过试错不断优化行为。RLHF(基于人类反馈的强化学习)是提升大型语言模型推理能力的关键技术。
令牌(Token)
令牌是人机交流的基本单位,将文本拆分成可处理的小片段。AI公司通常按令牌数量计费,令牌数量越多,成本越高。
令牌吞吐量(Token Throughput)
令牌吞吐量衡量系统单位时间内处理令牌的能力,决定了模型能同时服务多少用户及响应速度,是AI基础设施优化的重要指标。
训练(Training)
训练是让AI模型学习数据模式的过程,需大量数据和计算资源。训练成本高昂,微调等混合方法可降低成本。
迁移学习(Transfer Learning)
迁移学习利用已有模型作为新任务的起点,节省开发时间和数据需求,但仍需针对目标领域进行额外训练。
验证损失(Validation Loss)
验证损失衡量模型训练效果,数值越低表示学习越好。它帮助识别过拟合,指导训练调整。
权重(Weights)
权重是训练中调整的数值参数,决定输入特征的重要性,影响模型输出。训练开始时权重随机,逐步调整以优化结果。
*本文将持续更新,补充最新信息。