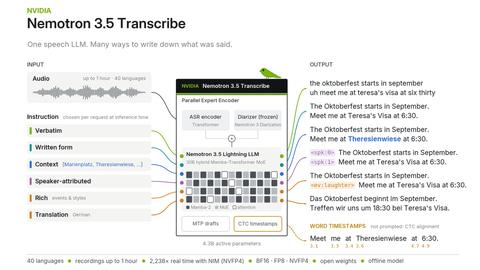
日本国家NVIDIA于10月28日宣布推出支持文字转录、翻译及说话人分离的开源权重AI模型“Nemotron 3.5 Transcribe”。该模型支持40种语言的文字转录,31种语言与英语之间的互译,以及13种语言的说话人分离,能够处理最长1小时的音频。基础模型已在Hugging Face平台公开,FP8和NVFP4量化模型也将于近期发布。该模型采用“OpenMDW-1.1”许可协议,免费且支持商业用途。
Nemotron 3.5 Transcribe在开源权重模型中,凭借其精准的发言内容识别能力和卓越的说话人分离性能表现突出。模型总参数量为340亿,活跃参数为43亿,采用MoE架构,支持长达65,536个标记的上下文长度。
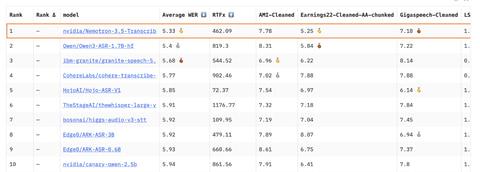
在Hugging Face Open ASR基准测试中,该模型的平均词错误率(WER)表现优异:英语为5.33%,7种语言为4.62%,长文本为10.98%,均优于其他开源权重模型。
此外,在David AI DAI-ASR-I18N基准测试中,Nemotron 3.5 Transcribe在文字转录和说话人分离性能方面排名开源权重模型第一,整体排名第二。在说话人分离错误率测试中,其表现略优于NVIDIA专门的说话人分离模型“Nemotron 3 Diarization”,同样位列第一。
该模型还以高吞吐量著称。利用NVFP4量化模型时,搭载NVIDIA RTX PRO 6000 Blackwell Server Edition GPU的服务器能够在不到3分钟内处理100小时的音频数据。
Nemotron 3.5 Transcribe已支持通过vLLM进行部署,使用NeMo-Speech.cpp可实现本地部署,量化模型也可用。该模型适用于RTX Spark、DGX Spark及Jetson AGX Thor等设备的边缘文字转录应用。同时,NVIDIA还发布了新的语音数据集“Granary v2”。