 AI教程
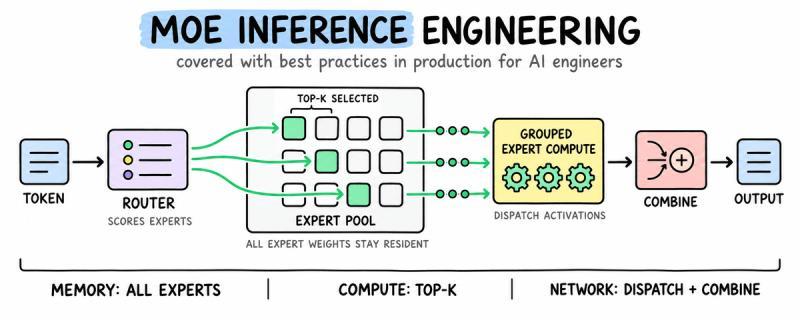
MoE推理工程:从路由到瓶颈,一条链路看透
沿着一个token在MoE层里的完整旅程,拆开路由、专家批处理、GPU放置与通信细节,帮你看清MoE推理的真实工程成本。
按标签聚合查看文章内容。
AI教程沿着一个token在MoE层里的完整旅程,拆开路由、专家批处理、GPU放置与通信细节,帮你看清MoE推理的真实工程成本。
 AI教程
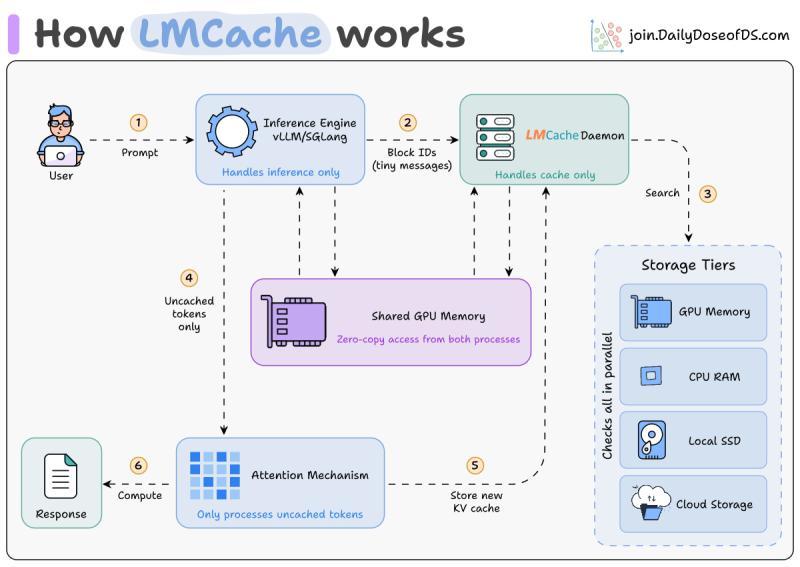
一份面向生产环境的 KV 缓存管理新思路:为什么 62% 的上下文是重复的、前缀缓存的天花板在哪里,以及 LMCache 如何用分离式架构和 CacheBlend 改写成本与性能曲线。
 AI教程
用可视化和类比操作系统分页内存的方式,讲清楚分页注意力如何把LLM推理的显存利用率从20%拉高到接近满载。
 AI教程
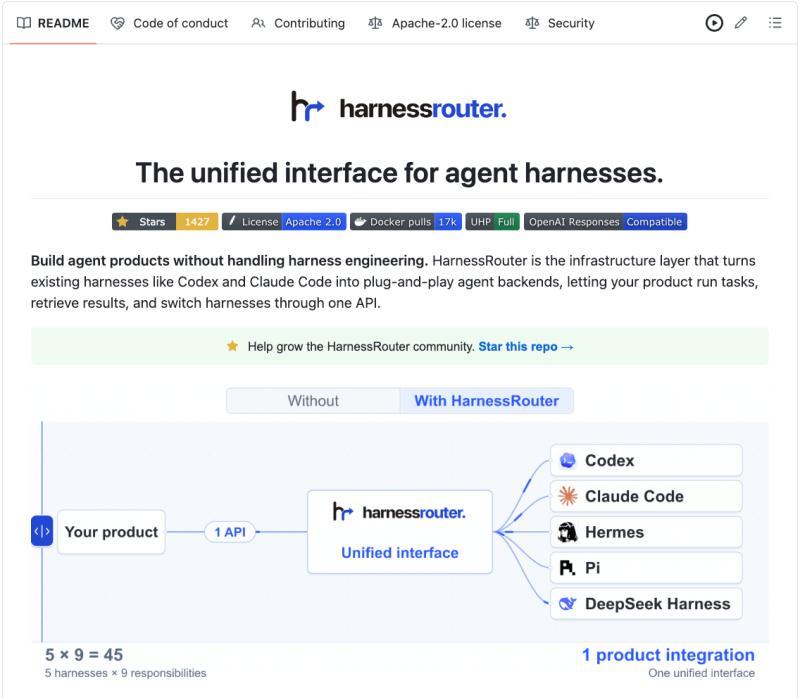
用统一执行协议(UHP)和 HarnessRouter,把 Codex、Claude Code、Hermes、DeepSeek Harness 等不同代理执行框架,收拢到同一套接口下路由与管理。
 AI教程
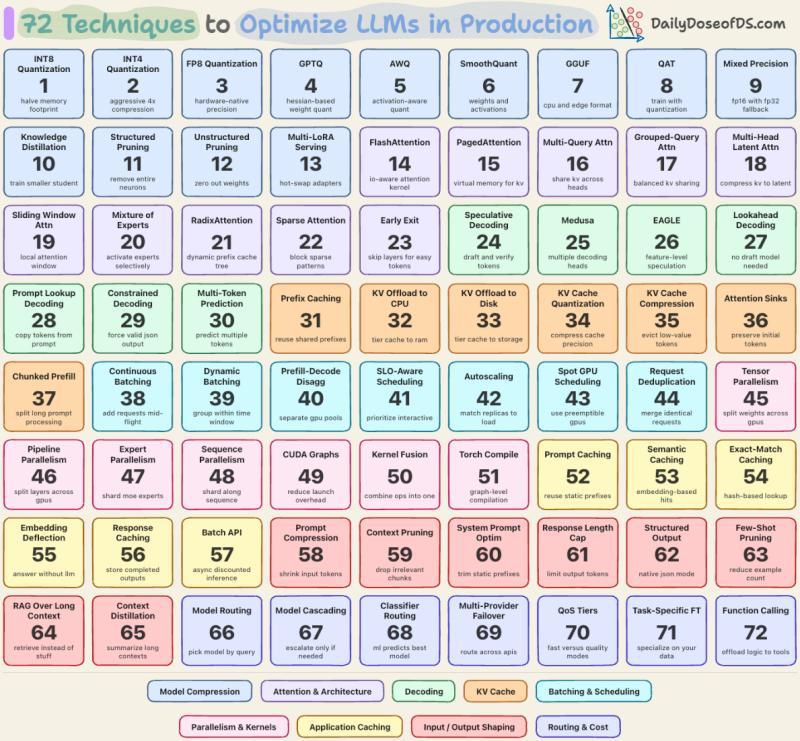
在同一块H100上,Llama 70B预填充阶段GPU利用率能到92%,解码却只剩28%。硬件没变,钱却在悄悄流失。本文从9个层面拆解72种优化技术,帮你把「研究用大模型」变成「能赚钱的大模型」。
 AI教程
一份面向 2026 年的 DeepSeek 实战指南:如何在托管 API、本地 Ollama 以及自建推理集群之间做选择,并避免老教程中的常见坑。
 AI教程
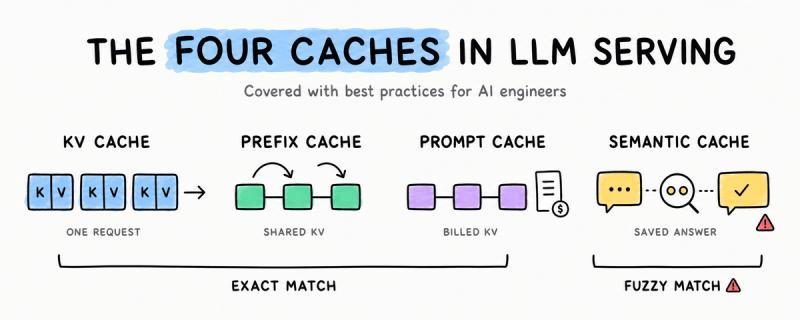
KV 缓存、前缀缓存、提示缓存、语义缓存听起来都叫缓存,但存的东西、命中规则和踩坑点完全不一样。本文用代码和案例拆开讲清楚:它们各自做什么、在哪一层省钱省时、以及在生产环境里最容易翻车的地方。
 AI教程
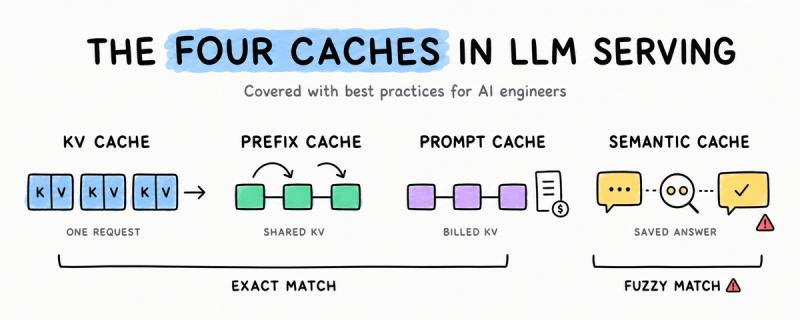
KV 缓存、前缀缓存、提示缓存、语义缓存到底差在哪?哪种能省钱,哪种可能悄悄帮你制造 bug?一文拆开底层机制和生产坑点。
 AI教程
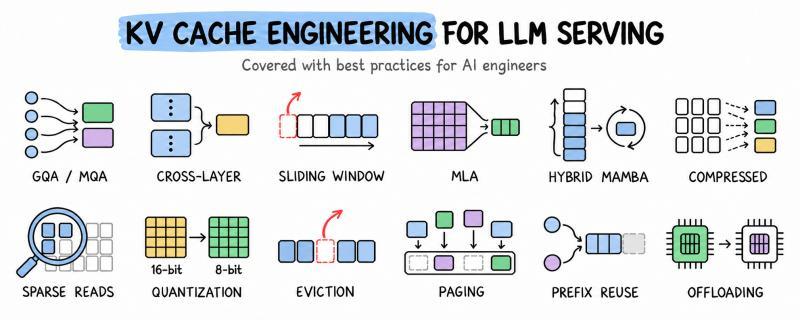
KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串在一起,讲清它们各自减的是什么、怎么组合、以及在真实生产环境里的坑和取舍。
从零到全栈AI工程师的系统路径:技术栈、学习路线与实战建议一文打包。
 AI教程
每个智能代理背后,都在悄悄运行同一个循环。模型在变成“水电煤”,而真正拉开差距的,是你怎么设计这层循环和它外面的系统。
 AI教程
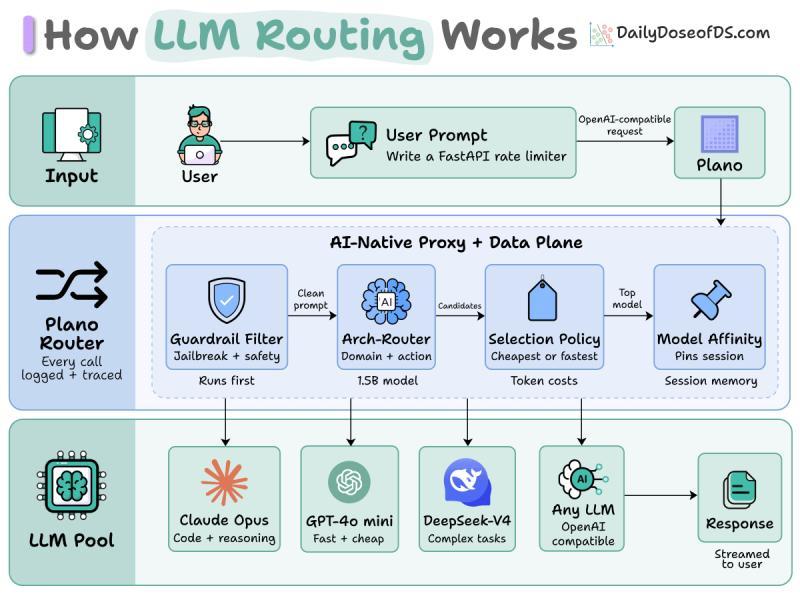
用Plano在应用前加一层“模型路由大脑”,自动选模型、保留会话上下文、按价格动态切换,在不改业务代码的前提下,把LLM成本压低50%-60%。