 AI教程
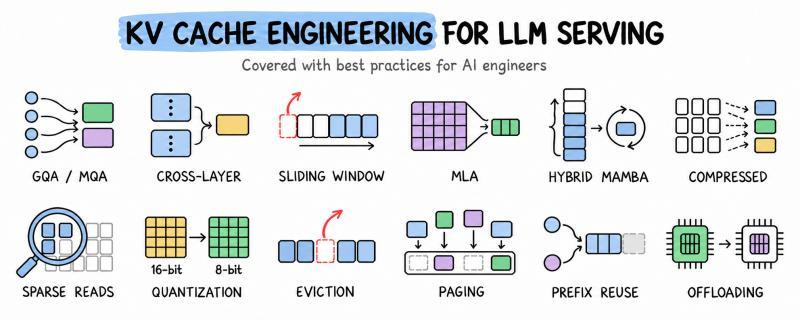
LLM 服务里的 KV 缓存:12 种工程减法
KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串起来,讲清它们各自减的是什么、怎么组合、踩坑在哪。
按标签聚合查看文章内容。
AI教程KV 缓存往往比模型权重更先把你的 GPU 挤爆。本文用一套“缓存公式”把 GQA/MQA、滑动窗口、MLA、量化、分页、前缀复用、卸载等 12 种技术串起来,讲清它们各自减的是什么、怎么组合、踩坑在哪。
 AI教程
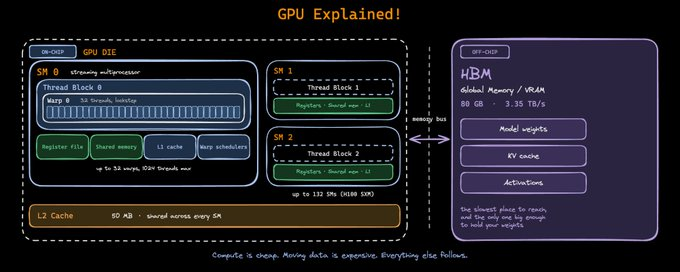
为什么顶级 GPU 标称千万亿次算力,却只能跑出几十 token/s?本文用直观比喻和可算的数字,重建你对 GPU 的系统直觉,让批处理、量化、FlashAttention 等优化从“技巧清单”变成顺理成章的结果。
 AI教程
DeepSeek 不是普通的 Web 服务镜像放大版,而是一整套从小型蒸馏模型到 671B 参数 MoE 大模型的家族。本文给出在 Kubernetes 上部署 DeepSeek 的三条路径:Ollama 快速演示、vLLM 生产推理、Ray Serve + vLLM 分布式大模型服务,并覆盖 GPU 规划、命名空间与 Secret、YAML 示例、监控、安全与扩缩容策略。