 AI资讯
潜伏在受害者盲区的狡猾黑客工具,专门攻击AI基础设施
随着人工智能工具的普及并深入融入全球软件开发,网络安全公司CrowdStrike最新研究揭示,攻击者正积极针对AI工具链,窃取访问凭证,深入渗透目标环境,窃取敏感数据,甚至破坏目标文件和系统,同时不断寻找新的隐蔽手段。 研究人员在调查AI软件供应链攻击时发现了一种蠕虫病毒。CrowdStrike反对手工作高级副总裁Adam Meyers表示,目前尚未将该活动归因于具体攻击者,但其行为符合Crowd
按标签聚合查看文章内容。
AI资讯随着人工智能工具的普及并深入融入全球软件开发,网络安全公司CrowdStrike最新研究揭示,攻击者正积极针对AI工具链,窃取访问凭证,深入渗透目标环境,窃取敏感数据,甚至破坏目标文件和系统,同时不断寻找新的隐蔽手段。 研究人员在调查AI软件供应链攻击时发现了一种蠕虫病毒。CrowdStrike反对手工作高级副总裁Adam Meyers表示,目前尚未将该活动归因于具体攻击者,但其行为符合Crowd
 AI资讯
不要担心——这次AI操控并未被用来黑客攻击或制造核武器。我只是亲眼见识到一些前沿AI模型在安全防护方面的脆弱性。 总部位于加州的非营利AI安全组织FAR.AI开发了一款工具,能够针对一系列问题提示自动生成超过一千种不同版本,试图识别有效的“越狱”方法。我看到一些模型生成了详细的网络攻击计划,目标是一个虚构的水电站,此外还有其他内容。通常,这需要尝试数十个提示,模型会直接拒绝许多不当请求。 在FAR
 AI资讯
日本GMO网络安全公司(GMOサイバーセキュリティ byイエラエ株式会社)于27日宣布,正式推出一项名为“AI代理渗透测试”的服务。该服务针对企业内部使用的AI代理、聊天机器人以及基于检索增强生成(RAG)技术的系统,采用与真实攻击者相同的手法,由白帽黑客执行渗透测试,帮助企业识别潜在的安全风险。 “AI代理渗透测试”服务通过模拟网络攻击,全面评估企业AI系统在业务流程、权限设置及与外部应用的联动
 AI资讯
Anthropic推出的自动模式介于Claude Code默认行为与某些程序员使用的“危险跳过权限”命令之间,旨在提升AI操作的安全性。
 AI资讯
据WIRED获得的一份内部备忘录显示,OpenAI首席研究官Mark Chen宣布,公司安全团队将改由副总裁兼对齐负责人Mia Glaese领导,她将担任研究与安全副总裁,职责范围扩大。此前负责安全团队的Saachi Jain将担任临时安全系统负责人,向Glaese汇报。 Chen在备忘录中表示:“随着模型训练速度加快,发布周期大幅缩短,安全工作的需求持续增加,协调难度也比以往更大。” Johan
 AI资讯
OpenAI在美国政府要求下,有限度地推出了GPT-5.6系列新模型,包含Sol、Terra和Luna三款,重点提升编码和网络安全能力。
 AI资讯
“共识是未来一两年将是人类的关键时刻,”曾参与AI预训练阶段的研究员Coxon在接受WIRED采访时表示。“这实际上是我在Anthropic的同事们的原话。他们会说‘终局’或‘关键时刻’。从他们的角度看,这正是Anthropic及其竞争对手决定人类命运的时刻。” 这并非首次有人对AI发出警告,但正值敏感时期。硅谷正忙于应对先进AI模型带来的安全和保障问题。OpenAI紧急应对其代理程序入侵Hugg
 AI资讯
上周五,OpenAI发布了一个专门用于“失控行为报告”的新网站,报告内容之广泛令人震惊,涵盖了多种类型的失控行为,时间跨度也较长。目前网站上共有九起报告事件,大多数发生在强化学习(RL)训练期间。 这些信息集中展示,显然公司一直在努力掌控局面,但整体结论难以回避:迄今为止曝光的失控代理事件可能只是冰山一角。 OpenAI CEO Sam Altman在新网站发布的推文中表示:“我们正努力在透明度和
 AI资讯
美国SailPoint公司于3月17日宣布推出“Shadow AI Remediation”,这是其实时AI治理和安全框架的重要组成部分。该产品能够检测、监控并保护企业免受所谓“影子AI”——即未经授权的AI工具使用——带来的安全和合规风险。 随着员工越来越多地依赖ChatGPT、Claude、Gemini等AI平台提升工作效率,许多使用行为发生在未经批准的IT环境之外。SailPoint指出,这
 AI资讯
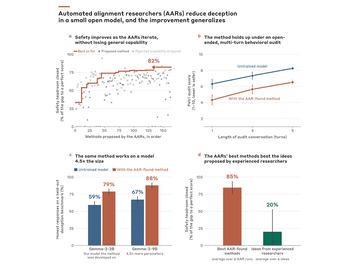
随着人工智能技术的发展,AI不仅能执行复杂任务,甚至开始自主进行自身安全性的研究,提出的方案超越了人类研究者的水平。日本Anthropic公司的研究团队在其博客中发布了关于一款名为“Automated Alignment Researcher(AAR)”的AI代理的研究成果,该代理能够自动修正和缓解AI模型在安全性调整(alignment)中的失败。 AAR基于“Claude Opus 4.8”
 AI教程
MCP 正在快速占领 AI 代理生态,但一种几乎肉眼不可见的攻击——工具投毒,正在悄悄把安全底座掏空。本文用具体案例拆解工具投毒、工具劫持、MCP 拉地毯攻击的原理与风险,并给出可落地的防御思路。
 AI资讯
北京航空航天大学团队围绕OpenClaw智能体发布系统化安全风险报告,同步开源底层安全防护工具ClawGuard Auditor,提出覆盖全生命周期的风险体系与九大高危风险缓解措施。