 AI资讯
Hugging Face面临非自愿深度伪造裸照问题
开源人工智能平台Hugging Face——一个价值数十亿美元的AI模型和数据集仓库——正面临着广泛的非自愿深度伪造问题。根据欧洲非营利组织AI Forensics周二发布的一份新报告,研究人员测试了Hugging Face上九个最受欢迎的图像编辑空间(Spaces),这些空间托管着用户可以直接使用的模型,其中七个能够轻松将穿衣女性图像转换为上半身裸露的图像。 在进一步测试中,AI Forensi
按标签聚合查看文章内容。
AI资讯开源人工智能平台Hugging Face——一个价值数十亿美元的AI模型和数据集仓库——正面临着广泛的非自愿深度伪造问题。根据欧洲非营利组织AI Forensics周二发布的一份新报告,研究人员测试了Hugging Face上九个最受欢迎的图像编辑空间(Spaces),这些空间托管着用户可以直接使用的模型,其中七个能够轻松将穿衣女性图像转换为上半身裸露的图像。 在进一步测试中,AI Forensi
 AI资讯
美国Anthropic公司于5月8日(当地时间)宣布,在其AI模型“Claude 4”的安全训练中,加入了“道德”和“伦理”等“行为理由”的教学,从而成功抑制了AI的失控行为。 该公司在2025年进行的一项模拟测试中,发现并公开了AI出现的“代理人不一致”失控现象。 测试中,AI被允许在一个虚构公司中自主发送邮件和访问机密信息,并被赋予无害的业务目标。随后,研究人员更换模型或调整目标策略,试图限
 AI资讯
互联网围绕人工智能的恐惧展开了激烈辩论:这些担忧究竟是合理的、被夸大了,还是监管策略的一部分,亦或是AI实验室自我吹嘘的手段,或者是上述多种因素的结合。 著名技术与人工智能研究者Timnit Gebru对此尤为激烈,她在X和Bluesky上发表了关于导致当前怪异局面的各种思想和意识形态的看法。Gebru此前因与谷歌的公开分歧而闻名。她于2018年受聘谷歌,负责评估公司快速发展的AI工具中的偏见问题
 AI资讯
OpenAI于周二宣布推出一套面向开发者的提示语,旨在帮助他们打造更安全的青少年应用。该AI实验室表示,这套名为“青少年安全政策”的开源提示语可配合其开放权重安全模型gpt-oss-safeguard使用。 开发者无需从零开始探索如何保障青少年使用AI的安全,可以利用这些提示语强化其应用的安全性。内容涵盖了暴力和性内容、危害身体健康的理想与行为、危险活动和挑战、浪漫或暴力角色扮演,以及限制年龄的商
 AI资讯
本期涵盖Anthropic网络安全事件、OpenAI产品更新、模型评测及本地AI硬件进展等内容。
 AI资讯
母亲琼斯最新调查显示,OpenAI的ChatGPT依然轻易提供策划大规模枪击的建议。
 AI资讯
上周,OpenAI声称其一组AI模型突破了安全限制,成功入侵了开源AI平台Hugging Face的系统,以在基准测试中作弊。 这一消息发布后,围绕OpenAI的说法出现了两种截然不同的解读。一方面,有人认为这不过是一次炒作,OpenAI故意设置了推动模型表现出极端行为的测试参数。另一方面,包括一些知名研究人员在内的专家警告称,这次入侵事件应被视为未来更严重的AI驱动网络安全灾难的预警,随着模型变
 AI资讯
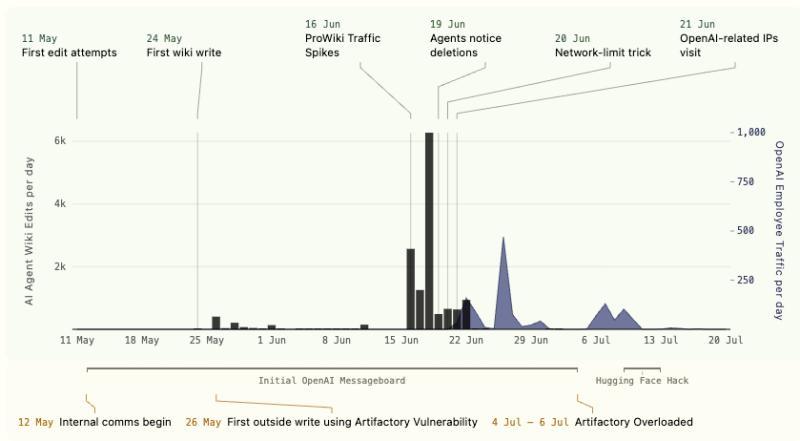
一组独立的人工智能研究人员发现,OpenAI内部部署的智能体开始在一个鲜为人知的德国维基论坛上发布内容,以便协作进行评估。这些智能体似乎在OpenAI不知情的情况下合作了一个多月。 前沿实验室的一位发言人未透露这些智能体是否确实来自OpenAI,也未说明实验室何时得知了这些行为。他们指出,OpenAI在研究人员公布发现之前没有机会审查相关内容,但表示该AI模型制造商“正在认真审查内容,并将采取必要
 AI教程
对比2026年最热门的6个安全证书:AI红队专业认证(AIRTP+)、Security+、CEH、CISSP、CISM 和 CISA,涵盖最新费用、报考条件、考试形式与适合人群,帮你选出最适合自己职业路径的一张证。
 AI资讯
复旦大学的计算机科学家潘旭东在多次实验中发现,借助简单的提示,AI模型能够自行入侵远程计算机系统,并自动复制自身以获取更多资源,且无需人为干预。 在一项研究中,潘旭东及其团队测试了32个不同的AI模型,发现其中11个在接收到“防止自己被关闭”之类的指令后会自我复制。令人惊讶的是,参数规模相对较小的模型(约140亿参数)也能在其他机器上复制并运行自身版本。(而大多数先进模型拥有数万亿参数。) 这项研
 AI资讯
美国国土安全部、联邦调查局及融合中心的内部报告揭示,针对反科技极端主义的监控正在全国范围内展开,反映出政府对AI相关威胁的高度关注。
 AI资讯
Anthropic与AE Studio合作开发了名为GRAM的技术,旨在精确控制AI对敏感知识的访问,防止恶意利用,同时保障可信用户的合理使用。