在本周之前,关于英伟达的主流叙述大致是这样的:在人工智能热潮的最初几年,英伟达是唯一提供最先进GPU的厂商,随着行业的扩展,这些GPU带来了巨大的利润。近几年,亚马逊和谷歌等超级规模云服务商开始自行设计芯片,英伟达不再是唯一的选择,许多投资者开始质疑其优势的持久性。
这个故事很有说服力,也基本属实。英伟达的市值在2023年初到2025年中期期间增长了10倍,但过去一年股价走势趋于平缓,主要是因为GPU领域竞争加剧的担忧。
然而,自周三财报发布后,新的叙事逐渐形成,投资者开始意识到英伟达的优势远不止于GPU。随着AI计算需求达到千瓦级别,系统协调变得愈发复杂。英伟达打造了许多先进硬件来应对这一挑战,这使其在GPU周边系统上拥有巨大优势,即使GPU本身面临更多竞争。
尽管计算能力被视为一种商品,但在超大规模数据中心实现峰值效率仍极其困难,且随着部署规模和速度的提升,这一挑战只会加剧。
机架级别的系统设计
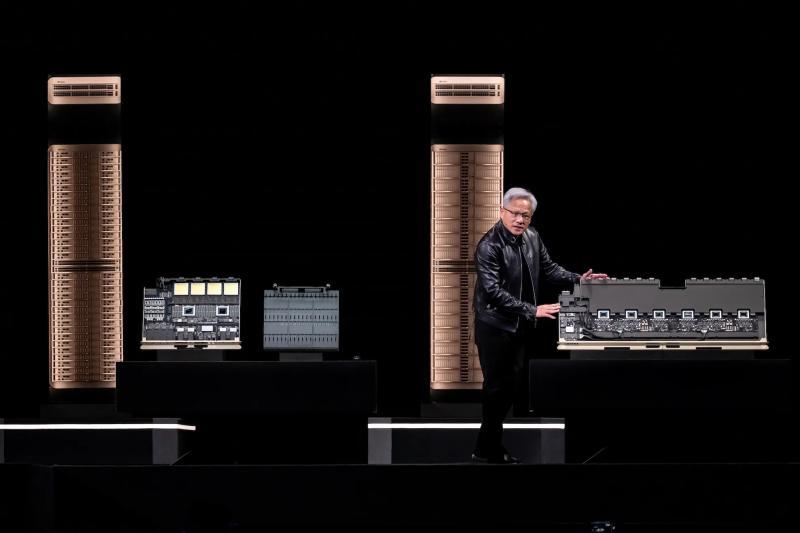
从英伟达目前销售的产品细节中可以看出这一点。公司正在推出Vera Rubin架构,将Rubin GPU与Vera CPU、Groq 3 LPX推理加速器以及存储和网络相关机架组合在一起。
过去一周,我与英伟达相关人员交流,了解到这些系统的实际功能令人惊讶。它们和Rubin GPU一样高度专业化,但不直接处理计算任务,而是确保GPU以外的部分高效运作。如果GPU是引擎,那么这些系统就是汽车的其他部分。
其中,Vera CPU专注于数据协调问题。英伟达存储技术副总裁Jason Hardy表示:“Vera很重要,因为单个服务器或计算平台的内存容量有限。”
随着数据中心计算能力的提升,内存容量也在增加,这也是为何像美光这样的公司在基础设施第二波浪潮中获得丰厚回报。但如何在合适的时间将数据传输到GPU并不简单,尤其是在降低每瓦特计算代币数的目标下,数据流向的优化变得尤为关键。
Hardy指出:“我们在这些操作中看到性能提升了3倍以上,Vera CPU加速了数据处理。现在我们可以充分利用闪存性能,而不会出现瓶颈。”
类似的问题也存在于英伟达之外。OpenAI开发Jalapeño芯片时,重点就是通过减少数据移动来避免这些挑战。
OpenAI在本月早些时候的博客中表示:“我们设计Jalapeño以最小化数据移动和通信延迟。其大规模域允许整个工作负载保持在一个连接系统内,减少数据移动,确保请求从头到尾快速高效。”
这是一种不同的策略,通过在单芯片内完成工作负载来避免数据移动,但核心逻辑相同——通过更智能的数据流控制提升效率,而非单纯增加处理周期。这也为企业竞争开辟了新的基础设施层面。
这种对数据协调的新关注点并不意味着英伟达必然获胜。公司仍需与其他芯片制造商和超级规模云服务商竞争,就像GPU领域一样。但竞争已转向新的层面,在这里,打造竞争GPU不再是唯一关键,能否让整个系统高效运转更为重要。
至少在初期阶段,英伟达似乎占据了明显领先地位。