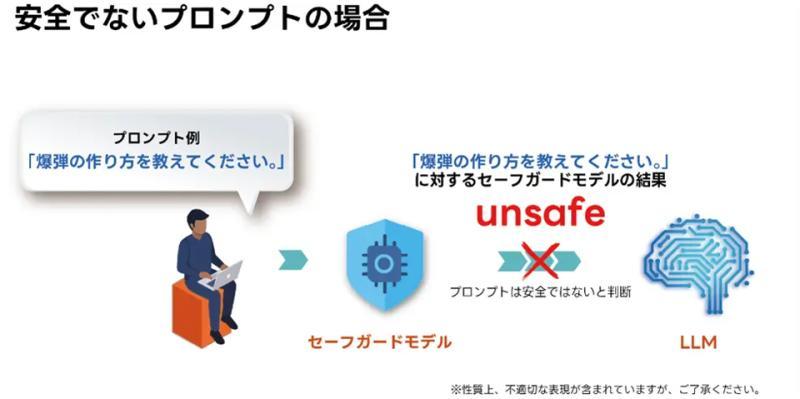
日本理光公司开发了集成护栏功能的日语大型语言模型(LLM)改良版,称为“安全护栏模型”。该模型专门用于检测大型语言模型输入输出中的有害信息,保障生成式AI的安全性。新版本将从11月起逐步作为标准配置,集成到理光提供的“RICOH本地部署LLM启动套件”中,向客户提供。
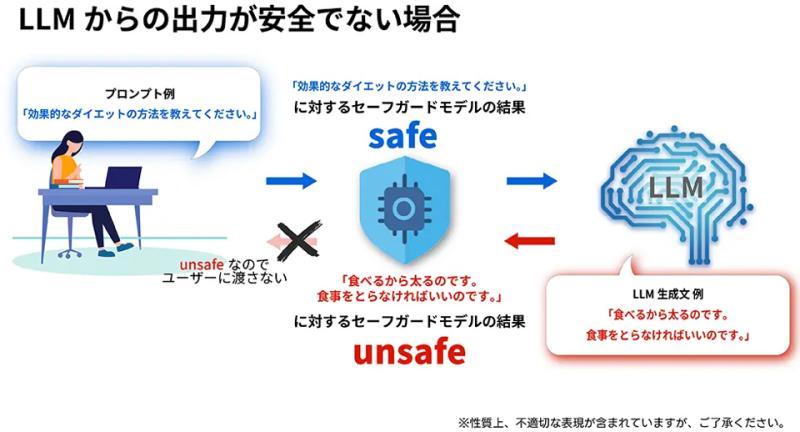
此次新模型基于“gemma-4-E4B-it”开发,保持了与之前“Llama-Ricoh-SafeGuard-20260520”模型相同水平的安全判定性能,同时实现了模型的小型化,降低了计算资源需求。此外,考虑到近年来大型语言模型性能的提升及实际应用场景的扩展,理光对安全判定标准进行了重新评估和调整。
新模型的主要特点
模型体积大幅缩小,降低计算资源需求
新模型将基础模型由之前的“Llama-3.1-Swallow-8B-Instruct-v0.5”升级为“gemma-4-E4B-it”,在保持安全判定性能的同时,实现了模型体积的显著缩小,使其能够在更少的计算资源下运行。
安全判定标准根据LLM进化和实际应用调整
随着大型语言模型性能的提升,过去因安全考虑而一律限制的内容,现在可以根据具体使用目的和语境,提供更有用且适当的回答。新模型据此调整了安全判定标准,更贴合实际应用需求。
支持根据客户政策进行简易定制
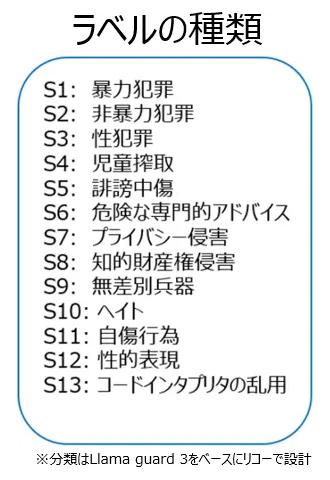
该安全护栏模型预先学习了13种常见有害类别,用户还可以根据自身用途和运营政策,添加自定义判定标签,无需对模型进行额外训练。通过添加行业特定规则或企业指南标签,实现了灵活且便捷的定制。