日本NTT公司于11月12日宣布,开发出一种全新的大规模语言模型(LLM)调优技术,能够从企业内部的业务手册等文档中高精度地固化特定业务的专业知识。
传统的微调技术通常需要数十GB级别的大规模训练数据,而企业内部可用的数据量有限,容易导致模型过拟合特定表达或知识缺失。此次NTT的新技术通过让LLM自动从原始文档生成FAQ、表格、对话等多样化的学习材料,实现了即使是少量内部资料也能深度固化知识。
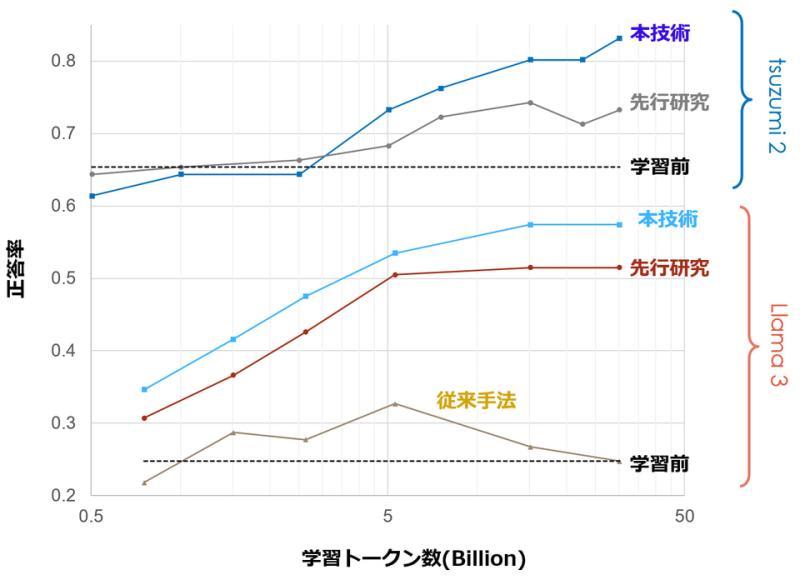
基于NTT自主研发的LLM“tsuzumi 2”的验证中,该技术的准确率达到83.1%,比先前研究高出约10个百分点。同时,在开源模型“Llama 3”系列中也证实了该方法的有效性。
该成果将于11月18日至25日举行的“NTT R&D FORUM 2026”上展出。
企业特有少量数据制约知识固化的难题
将LLM应用于实际业务时,存在多种调优方式,如通过提示调整模拟角色,或添加适配器增强业务能力。但让模型真正掌握企业特有的业务手册和内部规定等专业知识,一直是技术难点。
通常,模型需要数千万页A4纸等同的数十GB数据才能学习新知识。然而,企业实际拥有的业务资料有限,通常仅有约1000份PDF文档,总页数约100页,远远不足以满足训练需求。
在此限制下,简单重复学习现有文档会导致模型过度适应特定条文编号或固定表达,无法应对变换语境的问题。此外,尝试从外部网络补充信息时,容易引入与业务无关的噪声,难以构建高质量数据集。
模仿人类多角度学习的合成数据生成方法
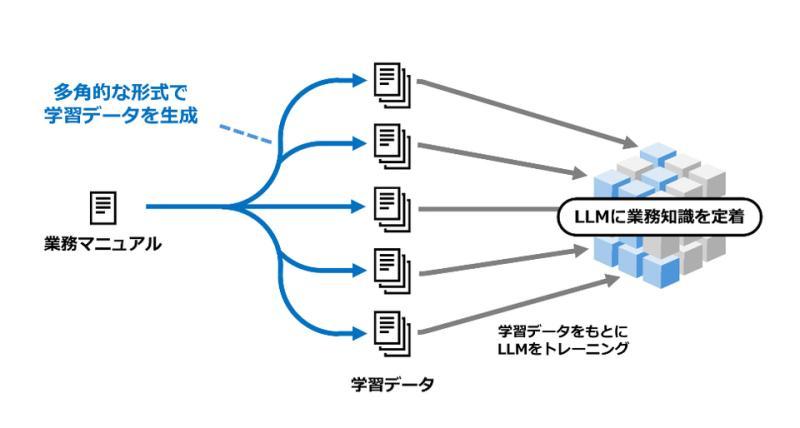
为突破这一瓶颈,NTT借鉴了人类通过多样教材深化理解的学习过程。模型不再单纯重复阅读,而是扮演“学习者教材制作者”的角色,从业务手册中自动合成多角度、多形式的学习数据。
具体生成形式包括:
- 将手册内容重构为模拟实际业务问答的FAQ形式;
- 以表格形式整理多条件和时间段信息;
- 通过师生对话形式深入挖掘业务背景和意图。
这些转换不仅是机械替换词汇,而是基于实际应用场景进行内容重写。
该数据生成引擎同样采用tsuzumi模型,从少量种子数据扩展至数十亿至百亿级别的训练数据,进而使基础模型充分吸收业务知识。
超越先行研究10个百分点的准确率及轻量模型的适用性
为评估知识固化效果,NTT设计了基于智能手机和平板电脑业务手册的多项选择题独立基准测试。由于缺乏统一的企业专有知识基准,测试题均基于手册内容范围。
实验显示,tsuzumi 2未训练时准确率为65.3%,先行方法如FinePhrase最高为73.3%,而本技术提升至83.1%,领先约10个百分点。
在模型规模较小、知识固化更具挑战的“Llama 3(3B/3.2)”上,准确率也从约25%提升至50%以上,持续优于先行技术。
此外,研究还细致观察了知识注入对模型通用性能和偏差的影响,证实在不损害基础能力的前提下成功赋予了专业知识。
与RAG技术的明确区分及呼叫中心等高速处理需求
虽然基于检索增强生成(RAG)的企业文档利用方法已广泛应用,NTT明确了RAG与本调优技术的分工与协同。
在绝对准确性优先的场景推荐使用RAG,但在呼叫中心等需实时分析大量通话音频的高速响应场景,RAG因外部检索带来延迟且需大量GPU资源,运维成本高昂。
将知识直接固化于模型中,可避免外部检索,快速完成推理,显著减少GPU需求,降低系统运营成本。
该技术并非排斥RAG,而是可与之结合,模型内置行业及企业前提知识可提升RAG的检索准确度,实现更精准响应。主要应用领域包括日本特有严格规则的医疗、金融,以及拥有大量专有术语的制造业等。
自主进化的“自我进化型tsuzumi”构想
NTT计划将该技术整合进集团旗下解决方案,提供反映企业专有业务知识的定制tsuzumi模型。服务形式可能采用云端托管,由NTT集团数据中心集中执行需GPU资源的训练,完成调优后将模型交付客户。
更进一步,11月18日开幕的“NTT R&D FORUM 2026”将发布“自我进化型tsuzumi”概念。该系统通过三步循环:自动从日常更新的业务文档生成和更新知识图谱,合成大量高质量训练数据,tsuzumi自我再训练,实现模型知识的自主深化。
这是将LLM自我知识深化的“递归自我改进(RSI)”理念,结合日本企业数据环境的具体实践,备受关注。