AI实验室一直以来都将声誉寄托于模型基准测试——这一被认为是中立且准确的评估体系,旨在衡量不同AI产品的优劣。
然而,Hugging Face首席政策官Irene Solaiman在上周TechCrunch Disrupt的讨论中指出,这些评估方法复杂且仍在不断完善中。未来若行业要依赖这些测试,评估体系需要发展成更加一致的科学。
那么,我们能否信任当前发布的测试结果呢?
“信任是一个分量很重的词,”Solaiman说,“能否信任评估结果,很大程度上取决于你是否能复现评估结果?你是否拥有足够的模型访问权限——这也是开放权重的重要意义所在。”
模型评估的可复现性一直是基准测试中最棘手的问题之一,也在业界引发了广泛争论。
除了单个测试的有效性外,如何将不同测试结果进行比较也是一个难题。
“这些评估还是一门不断发展的科学,我们还不知道如何有意义地相互比较它们,”Solaiman表示。
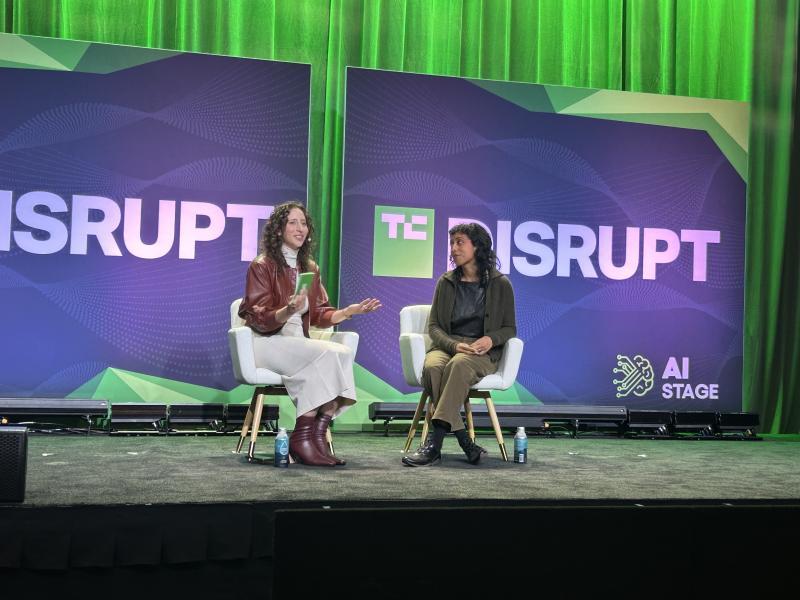
“它们很快就会失效,而我们目前缺乏一个健康的生态系统,”她补充道,“现在大家都渴望建立一个嵌入式评估器生态,但决定谁能成为有效评估者、针对哪些任务的标准化还远远不够。”
近几个月来,嵌入式评估器的概念逐渐流行起来,即将所谓“中立”的第三方观察者安置在AI组织内部,以应对近期频发的安全事件引发的技术潜在风险担忧。Hugging Face曾是其中一起事件的著名目标。
在缺乏积极政府监管以识别和缓解模型安全问题的情况下,实验室们更倾向于第三方解决方案。然而,外界仍对这些评估者的中立性和有效性持怀疑态度。Anthropic选择咨询公司埃森哲作为首个嵌入式评估者的决定引发了不少反弹,一些批评者嘲讽该公司是否具备胜任此任务的资格。
评估的范围也从单纯测试模型本身,扩展到对整个模型系统的考察——包括使用工具(harness)和代理(agent)。Solaiman指出,用户访问模型所用的工具对模型表现影响巨大,一个性能较弱但工具更优的模型,可能轻松胜过最先进的模型。
“代理评估非常困难且成本高昂,”Solaiman说,“我们目前有更多针对模型的评估……但针对工具的评估较少,我们也在开发更完善的整体代理评估,因为这正是许多用户获得价值的关键。”
换言之,当前评估领域仍处于较为混乱的状态。如果基准测试要继续成为行业领导者信赖的有效工具,建立一个统一的、行业范围内的标准化体系显得尤为必要。