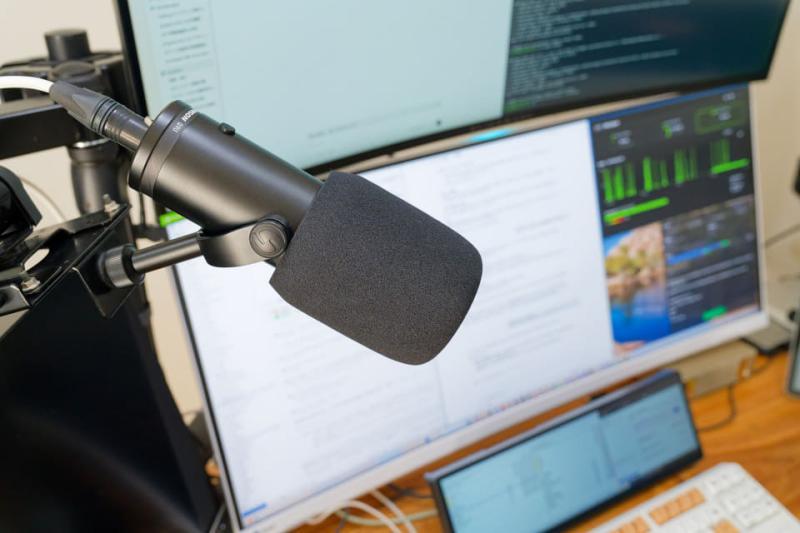
近年来,虽然短时的在线会议仍时有发生,但明显比以前减少了许多。采访活动也基本恢复为面对面形式。偶然发现,之前为此购入的高品质麦克风已经积满了灰尘。
为了充分利用这款麦克风,我尝试使用日本NVIDIA提供的开源语音识别模型“Nemotron 3.5 ASR”开发一款基于语音输入的实时笔记工具。
试用NVIDIA两款语音分析AI模型
Nemotron 3.5 ASR是一款支持英语、日语等40种语言的语音识别模型,参数量仅6亿,体积小且运行轻量,能够实现近乎实时的语音转文字处理。
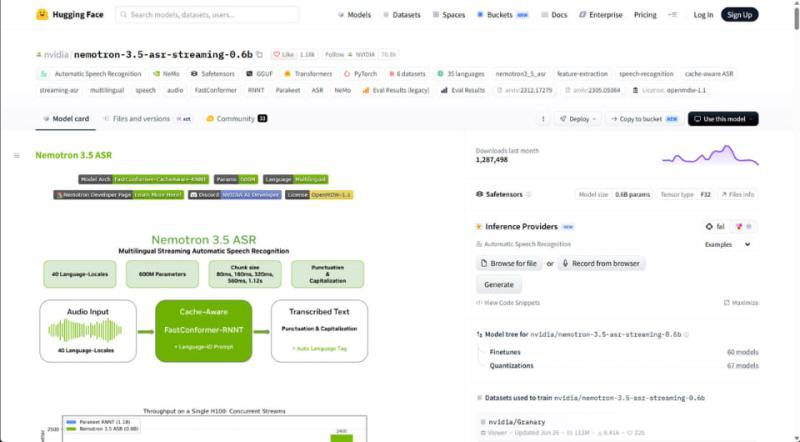
该模型通过将音频数据分段传入进行处理,返回文本结果,虽然不完全是毫秒级实时,但分段时间可调,最短可设为80毫秒,能在牺牲部分准确度的情况下获得极快响应;最长可设为1120毫秒,以提高识别精度。
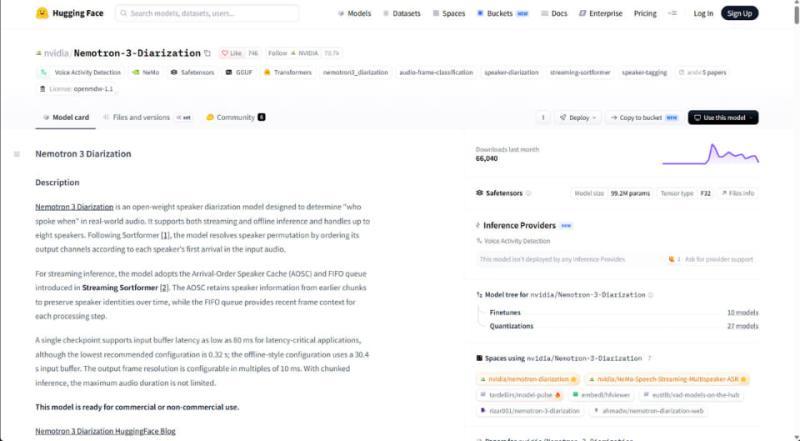
此外,我还结合了“Nemotron 3 Diarization”模型,该模型专注于说话人分离,最多可区分8人同时发言的内容。该模型参数量仅1亿,和Nemotron 3.5 ASR一起运行时,对日本NVIDIA DGX Spark服务器的128GB内存负担极小。
服务器-客户端架构实现语音笔记工具
本次开发的工具目标是实现持续开启麦克风,利用语音输入自动生成笔记的功能。虽然市面上已有多款支持语音转文字的应用,且操作系统层面也有支持,但专注于长时间持续语音输入并实时生成笔记的工具并不多见。
云端AI服务在长时间使用时存在限制,且涉及隐私风险,因而本地处理成为明显优势。此外,本地部署便于根据需求自由定制,适合日常使用。
工具架构为:Windows桌面端(客户端)通过麦克风采集音频,发送至日本NVIDIA DGX Spark服务器(服务器端)进行处理。
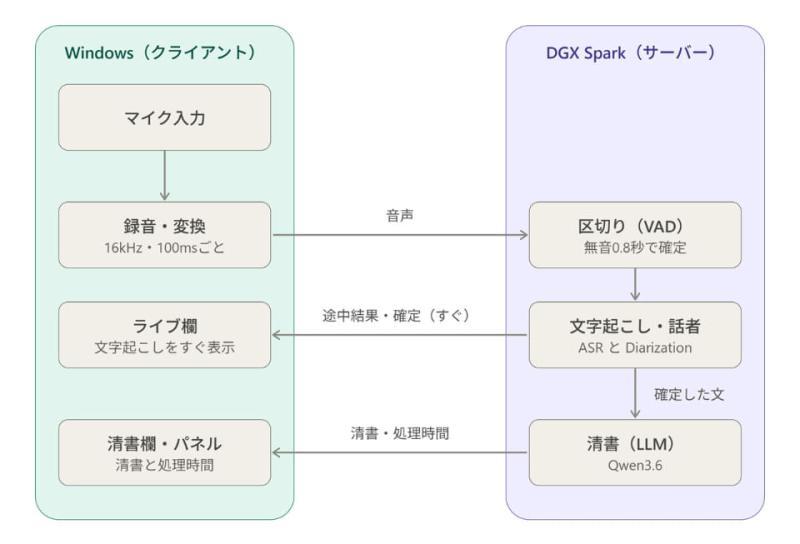
服务器端先用Nemotron 3.5 ASR进行文字转录,Nemotron 3 Diarization实现说话人分离,随后用Qwen 3.6-35B-A3B-NVFP4模型对文本进行润色,最后将整理后的笔记实时显示在客户端界面。
转录文本会实时显示,但不会直接作为笔记,而是经过格式整理,去除多余词汇和表达,使其更适合笔记用途。
虽然实际使用中只有我一人发声,理论上不需要说话人分离,但利用该功能可避免识别到其他人声,如家人讲话或背景广播,从而提升识别准确率。
该功能会在麦克风开启后只识别最先发声者的声音,具体效果和调优仍需进一步测试。
轻量高速,支持多AI并行运行
开发过程中,Windows端使用Claude Code(Sonnet 5.5 高版本),服务器端使用Codex(GPT-6.1 Sol xhigh),半天内完成实现。
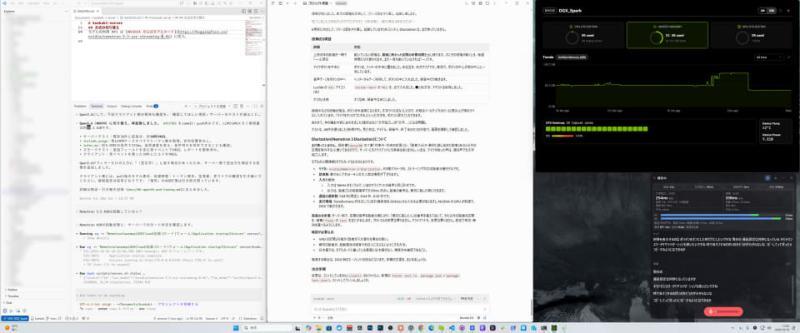
使用时通过快捷键(如Ctrl+Alt+1)开启麦克风,讲话内容会被实时转录并润色生成笔记。
生成的笔记可通过点击复制按钮或语音指令“复制”操作复制到剪贴板,方便粘贴到其他应用。
工具还内置了性能监测功能,用于测量转录速度等指标。
服务器端内存使用方面,Qwen 3.6润色模型占用约33GB,Nemotron 3.5 ASR约1.5GB,Nemotron 3 Diarization约250MB,总计不足35GB,整体内存使用约52GB,128GB内存的DGX Spark仍有充足余量支持多任务并行。
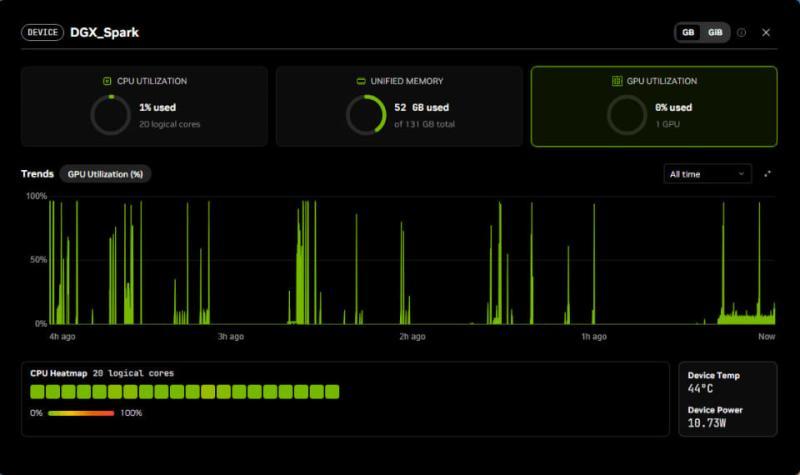
语音输入体验良好,转录和润色响应速度快,推理处理每560毫秒音频仅需约55毫秒,整体处理速度是发声时间的10到20倍,堪称实时甚至超实时。
润色生成速度约为每秒100个词元,虽说话人分离处理需几十到几百毫秒,但延迟感极低,整体上讲话结束即显示润色文本,方便立即复制使用。
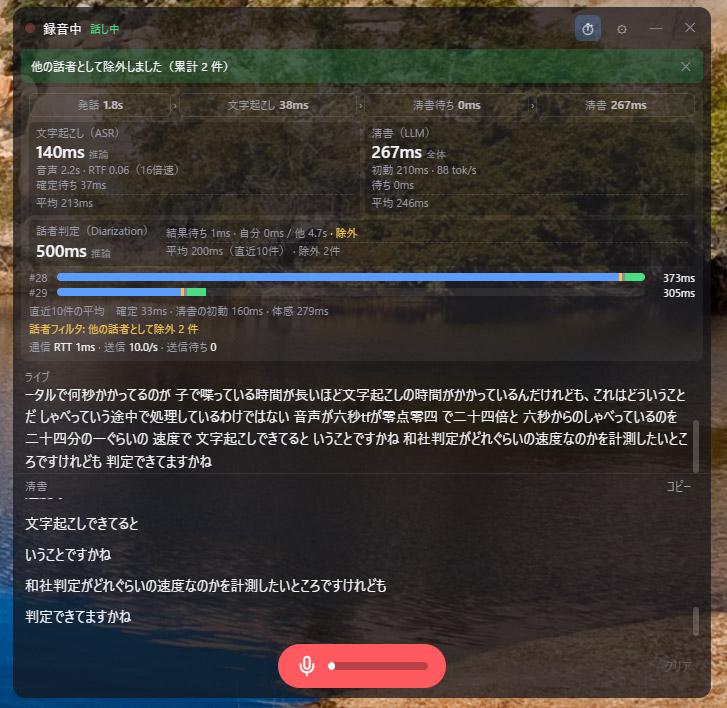
针对“是否只识别我的声音”的担忧,测试显示只要开麦后我先发声,后续即使有他人声音介入,转录文本会暂时包含,但润色后文本会自动过滤,起到类似噪声抑制的效果。
GPU负载方面,麦克风开启但无输入时使用率为零,转录时使用率个位数百分比,润色时偶尔短暂峰值达50%至90%。整体GPU和内存负载均低,支持同时运行其他AI任务。
未来展望:语音聊天与语言学习应用
目前唯一不足是润色文本质量仍有提升空间,需进一步优化提示词或尝试替换润色模型。
尽管如此,DGX Spark平台已证明能轻松实现实时语音输入和转录。若加入文本转语音功能,可实现与AI的语音对话;结合翻译功能,还能应用于语言学习。
Nemotron 3.5 ASR与Nemotron 3 Diarization的组合,为开发复杂语音处理系统提供了便利。相信更多开发者会被激发出各种创新应用的灵感。