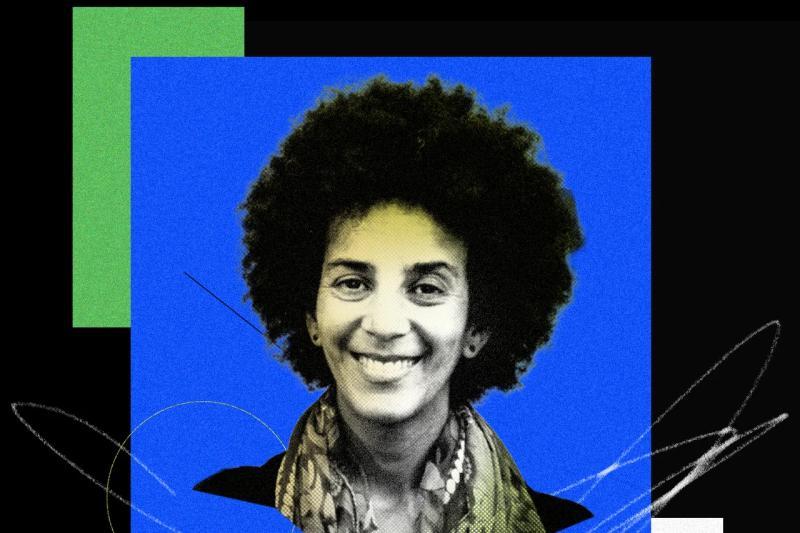
在人工智能领域,两个词汇逐渐成为焦点:“随机鹦鹉”和“生存风险”。而这场讨论的中心人物之一,是从未退缩过的著名AI研究者Timnit Gebru。
几年前,Gebru因与谷歌就一篇她共同撰写的论文产生争议而进入公众视野。该论文指出谷歌的AI存在偏见,认为大型语言模型(LLM)本质上是对训练数据的“鹦鹉式”重复,可能会延续偏见观点。这篇论文引发争议,最终导致她离开谷歌,并创立了一个研究技术带来危害、支持无偏见技术工具开发的机构。她还著有新书《深度去学习:人工智能的崛起与技术理想主义者的激进化》,预计明年初出版。
最近,Gebru公开反对业界一部分认为AI强大到可能毁灭人类的观点。对此,部分业内人士,包括Anthropic的联合创始人,认为她早期关于“随机鹦鹉”的研究已不再适用,AI确实具备“思考”或推理能力。有趣的是,Gebru对AI有效利他主义社区的“教派”性质的看法,使她与一些右翼团体观点不谋而合,这些团体也批评这些利他主义组织。
如今,AI的争论已不仅仅是技术本身,更涉及意识形态团体和战略叙事。Gebru认为这些叙事是对AI真正问题的“有害干扰”。我最近采访了她,探讨她认为这些争论分散了人们对AI核心问题的关注,也让她回应了对她早期研究低估当今AI能力的批评。
以下内容经过编辑以保证简洁和清晰。
采访实录
LAUREN GOODE: Timnit,非常感谢你接受采访。
TIMNIT GEBRU: 谢谢邀请。
几周前,Anthropic一位年轻AI研究员辞职,他在社交媒体上表示公司内部许多人认为AI带来了重大生存风险。随后引发了大量关于AI真实威胁的讨论。你当时说,这种叙事分散了我们面对的真正问题。能详细说说吗?
我甚至认为这不仅是分散注意力,而是危险的。这个叙事已经存在很久了。Elon Musk和Peter Thiel自2013年起就一直在传播AI是人类生存风险的说法。每隔三年,这种说法就会重复出现。
比如“生命未来研究所”(Future of Life Institute),由MIT物理学家Max Tegmark和Anthropic的早期投资者、Skype联合创始人Jaan Tallinn创立。公众可能觉得有很多独立机构在发声,但实际上这些机构的创始人和投资者与Anthropic有直接利益关系,他们同时也资助了被广泛引用的第三方审计机构。
为什么我说“机器神”叙事是干扰?因为这些利益相关者既是叙事的制造者,也是潜在的最大受益者。他们一方面声称AI可能毁灭人类,另一方面又从AI的商业化中获利巨大。这听起来很矛盾。
我很佩服前联邦贸易委员会主席Lina Khan,她指出现有法律对AI公司没有例外,而这些公司却装作有例外。他们说自己在造未来,但未来如果不能继续发展AI会很可怕。这其实是一种自我吹嘘。
他们在新闻中说AI既能带来气候变化解决方案、世界和平和消除贫困,也可能毁灭人类。其实这是在向投资者、政府和监管机构传递信息:你们想掌控这些超级强大的机器,别让对手先得手。监管应该针对这些虚构的超级机器,而不是现实中的具体问题,比如污染、数据中心、版权保护和正在进行的诉讼。
这也是一种推卸责任的方式。比如“自主武器”这个词,法律上包括地雷,但“生存风险”阵营把它曲解成超级智能机器自主行动。我曾在联合国大会旁听,看到多位科技领袖呼吁全球合作应对AI生存风险,但这其实是监管捕获的一部分——他们在寻求自我监管,避免真正的监管措施。
那么,如何治理AI?
治理很简单。前FTC委员Lina Khan提出五点建议:一是打击虚假营销;二是要求透明和数据文档;三是防止数据劳动剥削;四是禁止非法数据盗用;五是确保责任追究。很多公司不愿意做这些基本的事情,比如数据透明和文档,因为这会限制他们的商业模式。
回到你2021年合著的论文《随机鹦鹉的危险》,这篇论文指出大型语言模型本质上是基于大量互联网文本训练,输出最可能的文本序列,类似鹦鹉重复训练数据,而非真正理解。你能简单解释一下“随机鹦鹉”是什么意思吗?
“随机鹦鹉”是比喻,帮助人们理解大型语言模型的工作原理。它们并不理解文本含义,只是根据训练数据预测最可能的词序列。比如我们现在常用的ChatGPT和Claude都是基于此原理。我们写论文时,ChatGPT还没发布,但已经看到大型语言模型规模竞赛的风险。
这种模型可能会重复偏见、错误信息,甚至误导用户相信机器背后有“思考”的意识。比如论文中提到的巴勒斯坦男子写“早安”,被错误翻译成“攻击他们”,因为翻译语法正确,用户难以察觉错误。这种“自动化偏见”会导致过度信任机器输出,产生严重后果,比如医疗误诊。
Anthropic联合创始人Jack Clark最近称“随机鹦鹉”理论是“认知病毒”,误导了许多研究者,低估了AI能力。你怎么看?
我一点也不惊讶。这是有效利他主义者用来劝说立法者的说辞,称“随机鹦鹉”理论过时了。但大型语言模型的本质没有变,仍然是基于训练数据的概率预测。即使现在有强化学习等新技术,基础仍是大型语言模型。
我看到的最大问题是人们过度信任这些系统,缺乏有效监督,导致错误判断。比如医疗领域的错误诊断,直接源于模型本质上的“随机鹦鹉”特性。
有人说现在的AI具备推理和递归智能,你怎么看?
没有真正的推理和递归智能。很多AI研究者喜欢用理想化的术语,但实际模型只是基于模式匹配。比如我前经理Samy Bengio的研究表明,稍微改变推理测试标准,模型表现就崩溃,说明它们并不具备真正的推理能力。
你怎么看AI未来?
我认为应该专注于构建符合伦理、环保、不剥削劳动的替代技术。很多小型组织正在做这些事情,给我带来希望。我相信人类的能动性和集体力量能够想象更美好的未来,阻止坏事发生。
总结
Timnit Gebru强调,当前关于AI“生存威胁”的叙事更多是利益驱动的营销和监管策略,分散了对实际问题的关注。她呼吁加强数据透明、劳动保护和责任追究,推动负责任的AI发展。她坚持大型语言模型本质是“随机鹦鹉”,不具备真正的理解和推理能力,未来应关注构建公平、可持续的技术生态。