NVIDIA在IFA 2026展会期间发布了一款名为「PAIR」的有趣软件。它通过代理LLM的端点(Endpoint),实现任务的分散与并行处理。本文将带来首次试用的详细报告。
什么是NVIDIA PAIR?
2026年9月3日(美国时间),NVIDIA发布了家庭内多台PC自动分配AI推理请求的软件「NVIDIA PAIR」的测试版,并以Apache 2.0开源许可公开。该软件全称为“Personal AI Router”,它能在家庭局域网内自动检测多台PC,并将AI推理请求智能路由分配。其主要特点包括:
- 安装在各PC后,利用mDNS自动发现设备
- 通过6位代码配对,设备间通信采用mTLS加密
- 作为LM Studio和Ollama API端点的代理,转发请求
- 不采用模型切片或张量并行,而是按请求整体转发到不同PC
- 支持Windows、Linux、macOS,且不限于NVIDIA GPU,Apple M4芯片Mac也可作为节点
- 当前版本为0.1.1(测试版),采用Apache 2.0许可
| 系统要求 | 规格 |
|---|---|
| 支持操作系统 | Windows 11、DGX OS、Ubuntu 14.04及以上、macOS(含Intel Mac二进制) |
| 支持GPU/设备 | 支持运行LM Studio、Ollama的设备(PAIR本身不直接操作GPU) |
| 内存 | 8GB以上 |
| 存储 | 推荐20GB以上 |
| 网络 | 仅支持局域网连接(仅模型下载时需联网) |
PAIR通过6位代码完成配对,支持OpenAI API兼容和Ollama兼容API的代理和负载分配,但不支持VPN,仅限家庭局域网使用。虽然如此,指定LM Studio和Ollama的原因值得深入研究,本文也将结合GitHub源码和AI辅助分析进行探讨。
安装与软件结构
安装非常简单,可从GitHub下载对应环境的安装包。本文测试了Windows和macOS版本。GitHub上有多个版本文件,主要对应如下:
| 文件名 | 适用版本 |
|---|---|
| NVPAIR-Setup-0.1.1-arm64.dmg* | macOS/Apple Silicon (M1至M4系列) |
| NVPAIR-Setup-0.1.1-x64.dmg | macOS/Intel Mac |
| NVPAIR-Setup-0.1.1-arm64.exe* | Windows ARM |
| NVPAIR-Setup-0.1.1-x64.exe* | Windows Intel/AMD |
| NVPAIR-Setup-0.1.1-amd64.deb | Linux (Ubuntu等)/x64 |
| NVPAIR-Setup-0.1.1-arm64.deb | Linux/arm64 (如DGX Spark) |
带*号的为本文测试的三个环境。另有service版本,适合无GUI仅使用后台服务的场景。Intel Mac版本虽支持,但体验一般。
macOS安装时遇到错误,原因是PAIR默认查找~/.lmstudio/bin/lms,但实际路径为/Users/knishika/.cache/lm-studio/bin/lms,创建符号链接后问题解决。一般用户可能会因此放弃安装。
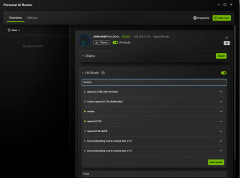
测试环境包括:一台安装有LM Studio但iGPU性能较弱且未下载LLM的ARM Windows笔记本(仅用LM Link),一台搭载RTX 5060 Ti和RTX 4060 Ti双GPU的PC(安装有LM Studio,未参与LM Link)。
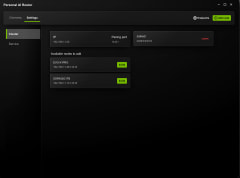
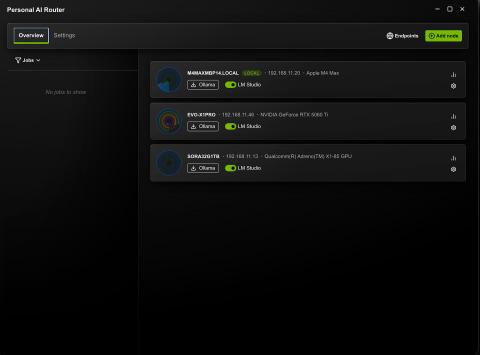
最终实现了三台设备互联:搭载M4 Max 128GB的MacBook Pro 14、双GPU PC和ARM Windows笔记本。
实际使用体验
使用时,只需准备支持OpenAI API或Ollama兼容API的聊天应用或代理,将端点指向PAIR即可。本文使用了Open WebUI进行测试。
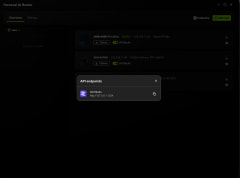
由于各设备上的LLM版本不一,无法完全验证负载均衡,但基本运行正常。LM Studio控制台显示PAIR通过轮询监控状态。
负载均衡测试中,准备了两台运行完全相同LLM的LM Studio设备,连续发送请求观察分配情况。
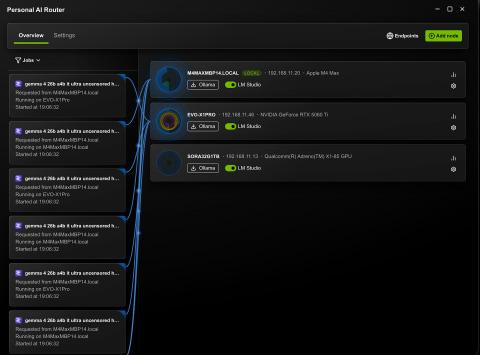
结果显示:
| 请求编号 | 用时 |
|---|---|
| req 1, 2, 4, 6 | 约54.3~54.4秒(快速组,4个请求) |
| req 3, 5, 7, 8 | 约94.9~96.1秒(慢速组,4个请求) |
快速组为RTX 4090(48GB改装),慢速组为RTX 5060 Ti+RTX 4060 Ti双GPU。值得注意的是,RTX 4090 PC未直接加入PAIR,而是通过Mac上LM Studio与RTX 4090 PC的LM Link间接访问,实现了复合连接。
故障测试中,故意关闭一台LM Studio,结果如下:
| 请求编号 | 结果 |
|---|---|
| req 1, 3, 4, 8 | 200 OK,约53.8秒(存活节点正常完成) |
| req 2, 5, 6, 7 | 400错误,约13.8秒终止,body: {"error":"terminated"} |
说明PAIR不具备自动将失败请求重发到存活节点的功能,这与官方文档中“PAIR不会自动检测卡住的服务”一致。
ARM Windows笔记本仅安装了LM Studio和LM Link作为客户端,但测试发现即使无LM Studio或Ollama环境,PAIR依然能正常运行并响应请求,适合轻量设备使用。
深入分析与未来展望
PAIR目前仅支持LM Studio和Ollama,且不仅仅是简单的请求转发,还管理引擎的安装、启动停止、模型目录和加载状态。由于Ollama无正式停止API,需以进程方式管理,而LM Studio有官方停止命令,导致实现上需针对不同引擎单独开发。
模型目录格式也不同,分别采用Ollama Library和基于Hugging Face的LM Studio格式,PAIR为此提供了专用解析器。
负载均衡策略较为简单:
- 仅向拥有请求模型的节点发送
- 优先处理队列较短的节点
- 不考虑GPU性能、内存空闲或请求复杂度
因此,必须在多节点上运行完全相同的模型才能实现有效负载均衡。未来若能支持同系列模型或更灵活的调度,将大大提升实用性。
从实际应用角度看,家庭用户拥有多台高性能GPU的情况较少,多数家庭甚至缺乏能运行LLM的设备。相比之下,使用VPN服务如Tailscale可实现跨网络的多设备连接,配合LM Studio和LM Link更为便捷灵活。
对于拥有多GPU的用户,通常会根据用途分配不同GPU,如图像生成、代码辅助或日常使用,且部分设备运行特定LLM,导致PAIR的统一负载均衡意义有限。
最适合PAIR的场景可能是小型办公室,拥有24-32GB VRAM的GPU,多个用户共享同一LLM模型,需简单快速地扩展服务器并负载均衡。但目前仅支持LM Studio和Ollama,且不支持vLLM,限制了应用范围。
NVIDIA显然意识到这些限制,未来版本预计会增加更多功能和兼容性,甚至支持ComfyUI等其他应用。
总结来说,NVIDIA PAIR是一款代理LLM端点的工具,安装相对简单,功能处于初期阶段。最大挑战在于家庭用户缺乏多设备LLM资源,以及当前仅支持LM Studio和Ollama。随着硬件成本上升,普通用户本地运行高性能LLM的门槛越来越高,这也是PAIR推广的现实障碍。未来的发展值得期待。