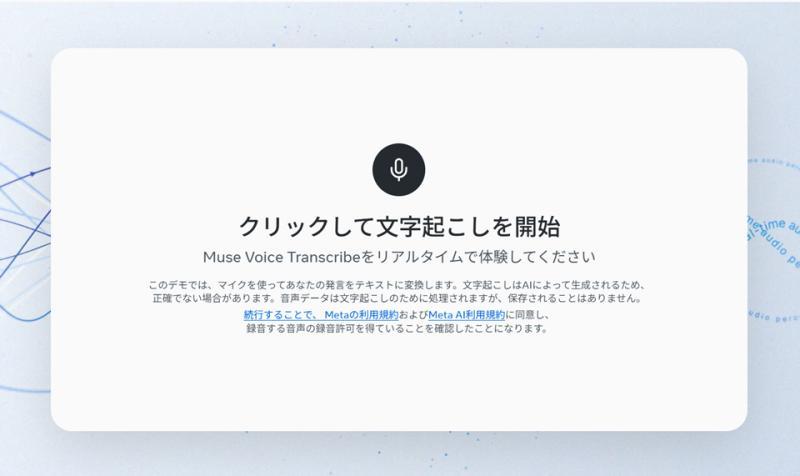
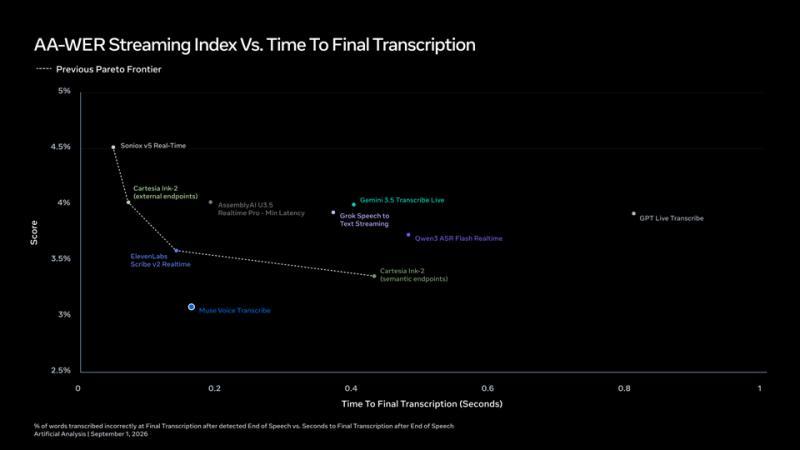
日本Meta Superintelligence Labs于9月1日宣布推出实时语音识别模型“Muse Voice Transcribe”。该模型目前可通过Meta Model API、Meta AI for Mac以及Muse Code进行使用。
Muse Voice Transcribe能够实时执行流式自动语音识别(Automatic Speech Recognition),支持超过20名说话人的分离以及语音段落的检测。该模型兼容Meta AI和Muse Code的语音输入功能,能够在屏幕上的任意窗口或应用程序中运行。
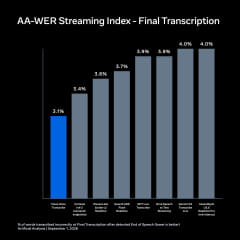
在语言支持方面,Muse Voice Transcribe已学习超过70种语言,并在其中25种语言中完成了性能验证。它通过利用上下文偏差提升识别准确率,且能够在单句中无缝处理多语言切换。此外,该模型支持超过1小时的长时间语音输入,无需后期处理。
该技术基于Muse Spark系列的自回归多模态模型。输入的语音以80毫秒为单位进行处理,模型会判断是等待下一段语音还是输出文本。为了平衡转录速度与准确性,系统引入了“自适应延迟”机制,根据单词难度动态调整处理等待时间。
在说话人分离和语音段落检测方面,模型通过在文本流中插入专用标记,指示说话人切换及语音开始和结束,从而实现精准的分离和检测。