日本国家OpenAI、Google、微软(Microsoft)、Anthropic宣布,将推动制定一项共通规范,使网站运营者能够通过robots.txt文件指定是否允许AI进行学习,计划于2027年正式实施。
robots.txt是网站中用于指示搜索引擎等爬虫(自动收集网站信息的程序)访问权限的文件。通过设置robots.txt,网站运营者可以决定是否允许搜索服务或AI服务收集特定页面或整个网站的信息。然而,在AI服务领域,robots.txt常被忽视,导致未经许可的信息采集,这一问题在日本国家也引起了新闻协会等机构的关注。
因此,网站运营者过去需要针对不同爬虫单独识别并制定规则,管理负担较大。此次制定的共通规范旨在通过统一信号,减轻运营者负担,提高管理效率。
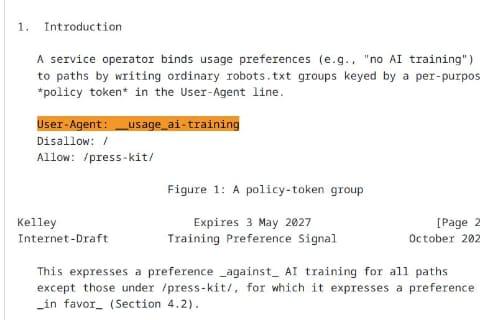
根据Google的说明,网站所有者可在robots.txt中使用共享的“策略令牌”(Policy Token),从而对所有参与的AI服务提供商统一设置访问权限。
以Google为例,网站运营者或发布者可利用“Google-Extended”机制,在允许搜索引擎爬取的同时,拒绝Google的AI模型Gemini进行学习。此次规范即是将此类设置标准化,形成robots.txt中的共通机制。
该规范由互联网工程任务组(IETF)AI Preferences工作组讨论制定,计划于2027年由各大公司陆续引入。Google计划于2027年实施,OpenAI则计划在未来几个月内开始采用,微软预计从2027年2月起执行。
在制定共通规范的基础上,各公司仍将继续维护自有的爬虫控制策略。Google将继续利用Google-Extended实现更细致的设置,微软则计划增加页面级学习设置及独立的基础数据控制等功能。