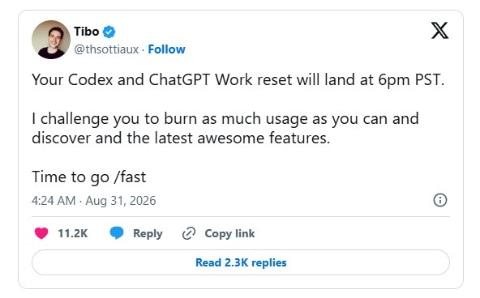
日本OpenAI负责Codex和ChatGPT开发的Tibo先生于8月31日(日本时间)宣布,针对Codex及ChatGPT Work的所有付费用户,进行了使用量限制的重置。同时,鼓励用户使用虽然消耗更多Token但响应更快的“/fast”选项。
在多次重置的过程中,开发团队对数千条用户反馈进行了细致分析,修复了多个导致Token浪费的严重漏洞。Codex的使用效率因此提升,部分使用场景下可比之前多使用10%至50%。
本次修正主要集中在上下文管理和后台处理的细节问题。例如,压缩过程中旧图像未被清理导致上下文膨胀,重复压缩现象被修正,使得在大量使用图像的环境中Token消耗减少约10%。此外,后台内存工作线程无法正确响应停止信号,导致持续执行的问题也被修复。
另外,针对未明确指定小型模型如Luna时,系统不必要地调用高性能模型的问题进行了修正。还解决了协调模型未启用/fast模式时,子代理却以/fast模式运行的异常行为。重复的计算机历史摘要曾占用周使用量的五分之一,这一问题也得到了改善。
其他修复包括停止了在普通对话轮次中产生多余请求的“滚动任务摘要”功能,修正了MCP中工具的重复编码问题,以及指令中断和重新获取的缺陷。
为防止类似问题再次发生,团队对架构进行了调整,并完善了警报机制。未来还将开发可视化工具,方便用户在应用内直接查看详细的使用量分解。