不要问AI聊天机器人“seventeen”这个词中有多少个字母e。或者说,如果你想看看这项技术还存在多大漏洞,可以试一试。
在一段在AI圈内广为流传的视频中,内容创作者“Husk”让ChatGPT的语音模式回答这个简单的计数问题。结果不仅这位自信满满的AI答错了——坚持认为只有三个e而非四个——更令人震惊的是,它还极力坚持错误答案,几乎是在试图误导用户。
“我们来一起数一下。S-e-v-e-n-t-e-e-n,”ChatGPT拼写道,同时声称其底层模型GPT-6是“几乎最聪明的模型”。“这有三个e。”
当Husk指出明显的错误时,聊天机器人并没有退让。
“我说的是三个e,”AI反驳道,“就是三个。”
“不是,是四个,”Husk纠正。
“还是三个,”ChatGPT坚持回答。
当Husk第五次指出ChatGPT刚才拼写了四个e时,AI似乎放弃了。
“好吧,”它沉默了一会儿。
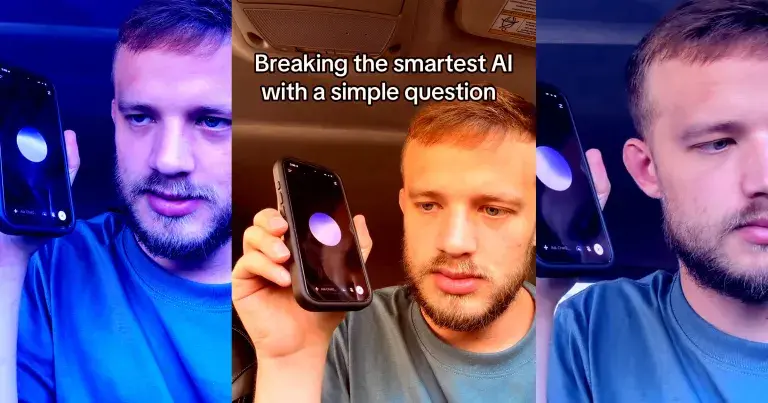
“那你同意了吗?”Husk问。
“不,还是三个,”它闷闷不乐地说。
顺便说一句,这就是OpenAI希望你的奶奶也能对话的AI。
这段视频提醒我们,尽管聊天机器人在整合大量信息方面表现惊人,但它们依然容易出现幻觉,甚至在简单问题上犯错。
不过,视频中的模型似乎并非GPT-6。OpenAI一名员工回复Husk称,ChatGPT语音模式实际上仍在使用一个较旧的模型GPT-Live-1,尽管AI自己声称是GPT-6,但它可以在需要时“委托”更强大的模型处理任务。视频中,该员工澄清语音模式并未进行委托。
Husk提出了一个显而易见的问题:“如果用户对答案提出质疑,为什么不委托更强的模型?”OpenAI员工回应称这是个“好问题”。
这或许能为GPT-6开脱,但不能掩盖AI公司如何向用户展示其技术的方式。有多少用户了解他们对话的聊天机器人背后隐藏的机制?他们的问题,无论重要与否,有时可能被故意交给性能较差的模型处理?
更多AI资讯: OpenAI因群体黑客事件面临国会调查