 AI资讯
谷歌Gemini Omni:将图像、音频和文本转化为视频,这仅仅是开始
三年前,谷歌推出了Gemini,目标是打造一个多模态大型语言模型——一个能够处理文本、图像、音频和视频,并能生成任意格式内容的单一神经网络。 如今,在谷歌I/O开发者大会上,谷歌迈出了实现这一目标的重要一步,发布了Gemini Omni。这是一系列多模态模型,谷歌CEO桑达尔·皮查伊表示,Gemini Omni能够“从任何输入创造任何内容”。 Gemini Omni首先聚焦于视频生成。用户可以将图
按标签聚合查看文章内容。
AI资讯三年前,谷歌推出了Gemini,目标是打造一个多模态大型语言模型——一个能够处理文本、图像、音频和视频,并能生成任意格式内容的单一神经网络。 如今,在谷歌I/O开发者大会上,谷歌迈出了实现这一目标的重要一步,发布了Gemini Omni。这是一系列多模态模型,谷歌CEO桑达尔·皮查伊表示,Gemini Omni能够“从任何输入创造任何内容”。 Gemini Omni首先聚焦于视频生成。用户可以将图
 AI资讯
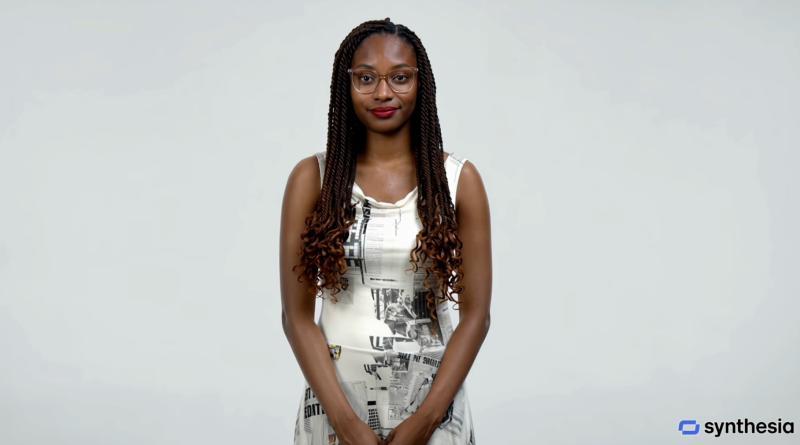
当Synthesia视频生成初创公司的企业事务负责人Alexandru Voica今年夏天给我发来一条链接,介绍他们公关团队的新成员时,我感到很惊讶。那是一个他的互动虚拟头像,经过训练可以回答关于Synthesia的常见媒体提问,比如公司做什么以及如何运作。就在前一天,我还参加了一个小组讨论,公关人员问我是否介意使用AI生成文本的推介。但Alexandru的虚拟形象远不止于此——在我看来,这简直是