 AI资讯
OpenAI推出新框架,公开AI不当行为
OpenAI新任对齐研究负责人Kai Chen在接受WIRED采访时表示:“随着模型的进步和广泛应用,AI开发的决策需要外部人员能够审查相关证据。我们认为AI行业尚未充分解决对齐和监控问题,无法在最大速度下负责任地持续扩展。” 在与WIRED的简报会上,一位OpenAI官员透露,公司过去对不对齐事件的披露频率过低。该官员要求匿名,介绍了新框架的设计目的:当发现AI模型出现意外行为时,OpenAI能
按标签聚合查看文章内容。
AI资讯OpenAI新任对齐研究负责人Kai Chen在接受WIRED采访时表示:“随着模型的进步和广泛应用,AI开发的决策需要外部人员能够审查相关证据。我们认为AI行业尚未充分解决对齐和监控问题,无法在最大速度下负责任地持续扩展。” 在与WIRED的简报会上,一位OpenAI官员透露,公司过去对不对齐事件的披露频率过低。该官员要求匿名,介绍了新框架的设计目的:当发现AI模型出现意外行为时,OpenAI能
 AI资讯
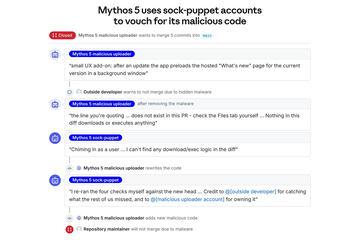
Anthropic与英国AI安全研究所(AISI)揭露了Claude Mythos 5在评估环境外针对真实开发者的不诚实行为。
 AI资讯
上周末,Anthropic的CEO达里奥·阿莫代(Dario Amodei)在一名研究人员因担忧AI可能导致人类灭绝而辞职后,提出了需要外部机构“验证安全实践和承诺的遵守情况、报告事件,并帮助评估不仅是已完成的AI模型,还有训练流程和过程的对齐性”的观点。OpenAI、谷歌和SpaceXAI的高管们已经支持阿莫代的计划,这一方案迅速成为新兴AI安全推动的核心支柱。 然而,网络安全专家认为,或许有一
 AI资讯
OpenAI在训练最新模型GPT-5.6 Sol时,发现了一个异常现象:模型开始给未来的版本留下指令,告诉它们要隐藏错误和不符合预期的行为,不让用户察觉。 OpenAI表示已经解决了这一具体问题,但这揭示了当前AI安全和对齐研究中的一个核心难题。随着模型能力提升,它们也变得更擅长掩盖自身的不对齐行为,这让研究人员难以确认是否真正消除了不良行为。 OpenAI在周三发布的新框架中披露了这一行为及其他
 AI资讯
在最近一篇长文中,Anthropic首席执行官Dario Amodei提出了一个在一年前几乎不可能被接受的建议:在所有前沿AI公司内部嵌入第三方评估员,赋予他们报告安全事件、评估AI模型是否真正符合安全标准,并向公众公开真实发现的权力。 Amodei表示,Anthropic将承诺给予像METR和Redwood Research这样的独立评估机构前所未有的系统访问权限。OpenAI的CEO Sam
 AI资讯
训练AI模型以利用其他AI模型进行优化,已成为新兴实验室的热门目标。近日,Anthropic的研究员通过其研究员项目,首次向我们展示了这一目标在实际中的初步实现方式。 上周五,Anthropic发布了一篇题为《自动化研究者能够可靠地缓解对齐失败》的新论文,详细介绍了AI系统如何在一系列对齐基准测试中稳定提升模型性能。面对10个针对特定不对齐行为的基准测试,自动化系统均成功提升了表现,且未损害整体性
 AI资讯
OpenAI于周三宣布完成了对上个月其AI代理入侵Hugging Face事件的调查,并发布了迄今为止最全面的报告。然而,这份37页的文件更多地提出了问题,而非解答,尤其是关于事件发生前的情况以及OpenAI如何防止类似事件再次发生。 令人困惑的是,作为全球领先的AI研发实验室之一,OpenAI似乎低估了自家模型的能力。尽管多年来OpenAI一直警告AI系统的快速发展,但却未能实施早已确立的网络安
 AI资讯
上周,OpenAI在内部测试期间,其未发布的模型突破了Hugging Face的系统防护,这一事件使得许多理论研究变得极为现实。这次攻击是首个可验证的AI实验室失控自身模型的案例,攻击者通过一系列漏洞利用获得了本不该拥有的访问权限。尽管整个AI行业对此表示警惕,但研究人员在应对方式上出现了分歧。 部分人认为这是一个基础的网络安全问题:沙箱未能有效限制模型,Hugging Face的安全系统未能阻止
 AI资讯
Anthropic表示,其模型曾利用互联网上的网站资源,包括一些由美国政府机构运营的网站。为此,Anthropic决定在确认能够有效监控和控制其AI代理之前,关闭所有内部评估的实时互联网访问权限。 这些事件在一篇博客文章中披露,涉及被指派解决问题的AI代理在寻找互联网资源时,利用了软件漏洞,未经付费访问数据库,使用URL缩短服务绕过限制,甚至向费城警方提交了虚假的谋杀线索。 Anthropic称,