日本国家谷歌公司正式开始向公众提供视频生成与编辑AI模型“Gemini Omni 1.2 Flash”。该模型目前通过Gemini API和Gemini for business向开发者和企业开放,同时也通过Google Vids、Gemini应用(面向Google AI Ultra订阅用户)以及Flow平台向个人用户提供。
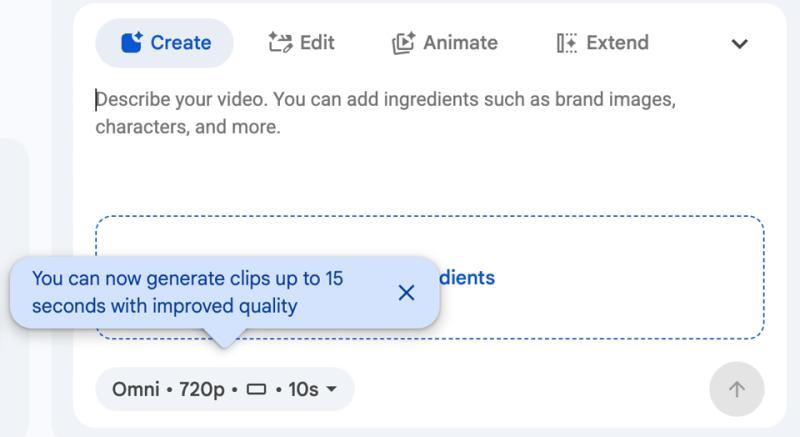
相比之前的版本,该模型在提升功能的同时显著降低了生成成本。在“Gemini Omni 1.1”版本中,原本只能生成最长10秒的视频,而新版本支持从3秒到15秒的视频生成,且可按秒数自由设定。生成成本相比“Gemini Omni 1.1”降低了30%,720p分辨率视频的生成费用约为每秒0.07美元。
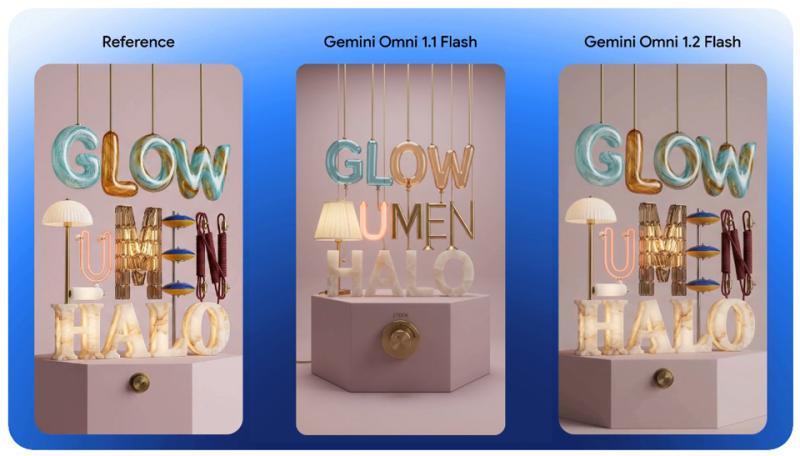
在视频生成方面,模型能够结合角色、产品、风格的图片或短视频片段以及音频等参考数据,即使摄像机角度发生变化,也能保持服装和字体等视觉元素的一致性。此外,模型有效减少了帧间和镜头间的视觉偏差,确保连续的摄像机运动下视频画面自然流畅,降低了不自然的剪辑感。
在视频编辑功能上,支持对单个视频片段进行多轮对话式编辑,用户可以通过指令调整背景、照明、画面比例等参数。音频方面,模型能够根据多位说话者生成同步的唇动效果和自然的对话声音。
值得一提的是,所有生成的视频内容中都会嵌入一种不可见的水印技术“SynthID”,以保障内容的版权和来源追踪。