2023年9月23日,日本谷歌宣布推出全新音声生成AI模型“Gemini 3.8 Flash TTS”和“Gemini 3.8 Flash-Lite TTS”(文本转语音技术)。这两款模型现已通过谷歌AI Studio和Gemini API提供,用户还可在Gemini Notebook和Google Vids中即时使用,未来也将逐步引入Gemini Enterprise。
“Gemini 3.8 Flash TTS”专为深度创意指导和角色设计打造,能够根据自然语言提示从零生成音声,支持对语速、方言变化、非语言表达(如笑声、叹息、背后反馈)以及逐句的表演指令进行精细控制。
而“Gemini 3.8 Flash-Lite TTS”则针对大规模配音处理和语音代理应用设计,注重处理效率和成本优化。
功能方面,这两款模型支持超过100种语言和方言,内置2000多种即用音声。它们还能通过30秒的音频样本捕捉说话者特征,保证长时间音声生成时音质稳定,并支持从单一脚本中再现两人对话场景。
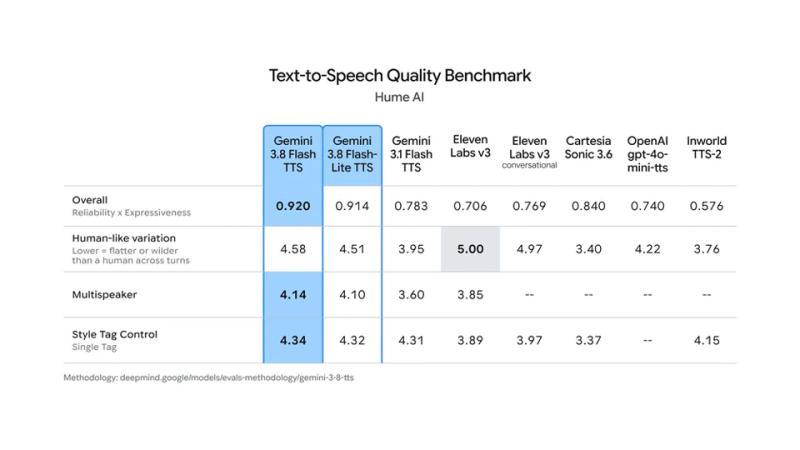
性能上,谷歌的这两款模型在Hume AI的音声设计及综合质量指标评比中获得第一和第二名,并在涵盖日语等多语言的Voice Arena盲测中名列前茅。
在安全性方面,谷歌要求音声复制必须经过说话者本人同意验证,并集成了“SynthID”水印技术和C2PA认证,以确保生成音声的可识别性和防伪能力。