美国谷歌(Google)宣布,为其生成式AI模型“Gemini”的最新版本推出“智能代理视频理解”功能。该功能在大幅降低令牌消耗和成本的同时,显著提升了视频分析的准确性。
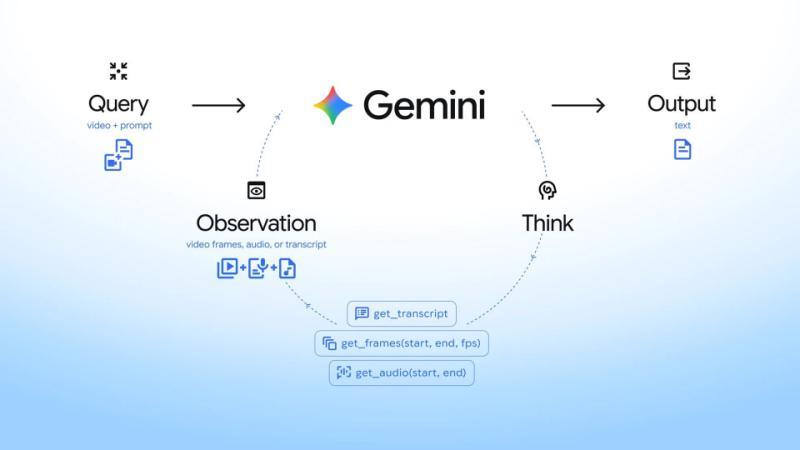
此前,视频分析主要采用逐帧静态处理方式。而新推出的“智能代理视频理解”功能则结合了模型推理能力与视频处理工具,能够跨越视频画面、音频和字幕,实现动态的视频搜索和扫描。
具体来说,Gemini能够根据分析目标,智能判断应观看视频的哪些部分以及以何种速度观看,从而聚焦于关键时刻和重要片段,精准提取所需信息。
这一改进使得分析成本最多降低66%,令牌消耗最多减少88%,同时准确率提升最高达7%。该功能在超过10分钟的教学视频或90分钟的讲座视频等长视频中的效果尤为显著。
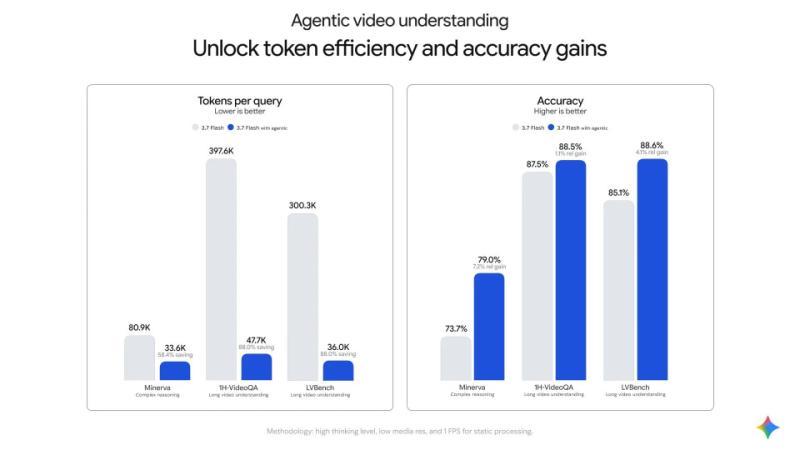
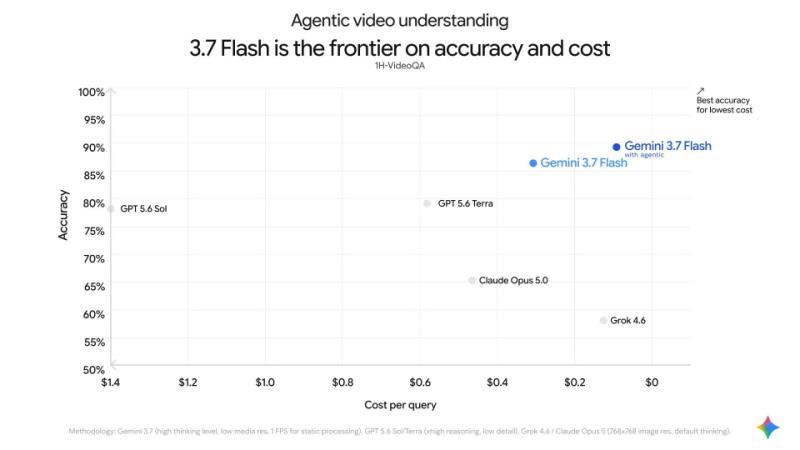
目前支持该功能的模型包括Gemini 3.7 Flash、3.6 Flash和3.5 Flash-Lite三款,其中Gemini 3.7 Flash在质量和成本方面表现最佳。
实际应用中,该功能能够精准捕捉1帧每秒(fps)视频中容易被忽略的关键瞬间,帮助准确定位视频剪辑的切割点,极大提升AI视频编辑的效率。
此外,该技术还能在长视频中实现精准的关键点搜索,同时节省令牌消耗。通过对特定时间段进行高帧率回放,还能支持快速动作的“异常检测”应用。
功能还包括对视频中重复动作的计数以及特定物体的精确追踪。
该功能将于近期在Gemini应用中逐步推出,并计划在数月内集成到YouTube的视频观看界面中的“Ask YouTube”功能中,进一步提升用户体验。