每当有新的AI模型发布时,常常会看到“创下世界最高分”“大幅超越前代模型”等宣传语。但AI的“实力”究竟如何衡量?测试得高分,是否意味着在实际工作中同样表现出色?
为了用统一标准比较AI能力,业界引入了“AI基准测试”这一机制。本文主要介绍生成型AI的评估方法。
测量什么?四种代表性评估方式
“基准测试”原指测量中的基准点,在IT领域则指性能比较的标准和测量方法。
AI基准测试通过统一的问题和评估方式,比较不同AI模型的能力。主要可以分为以下四类:
-
考试题型:测试知识和推理能力。代表作是涵盖57个科目的四选一题库“MMLU”,还有测量日语能力的“llm-jp-eval”。
MMLU涵盖从小学数学到历史、法律等多个领域,检验模型的专业知识广度。但仅凭分数无法判断文本自然度或对话流畅性。
-
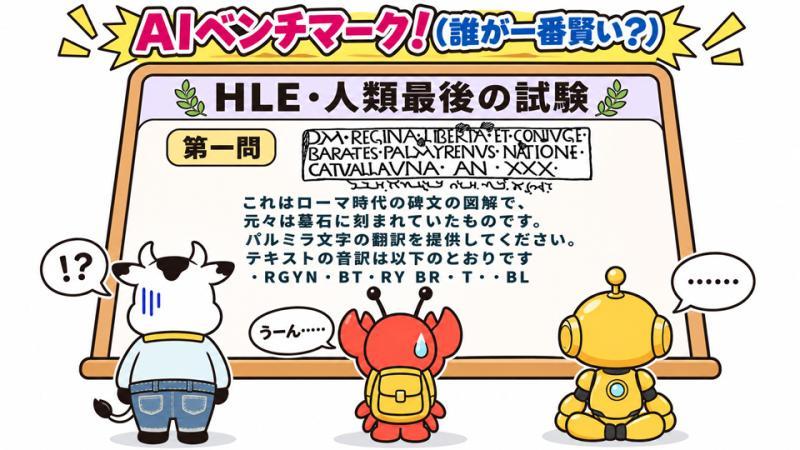
专家级难题:更具挑战性的专业问题,如生物、物理、化学领域的“GPQA”,以及由全球研究者收集的“人类最后考试(HLE)”。
GPQA中,非专业但知识丰富的人使用网络搜索,平均每题耗时超过30分钟,正确率仅34%。HLE包含约2500题,覆盖更广泛的专业领域。
-
实际任务型:例如“SWE-bench”,让AI修复真实软件缺陷,并通过测试评估修复效果。
-
用户偏好型:如“Arena”,对两个匿名AI回答同一问题,由用户投票选出更优答案,侧重使用体验而非正确率。
(以上分类为便于理解而整理)
高分背后的“保质期”问题
AI进步迅速,曾经难题逐渐变简单,模型间差距缩小,出现“饱和”现象。
以MMLU为例,最初的GPT-3得分为43.9%,2023年的GPT-4提升至86.4%,甚至出现超过90%的模型。但研究发现,测试题中约有6.5%存在错误。
因此,出现了增加选项至10个、强调推理的“MMLU-Pro”,以及更难的“GPQA”和“HLE”等新测试。基准测试工具会随着AI进步不断更新。
记忆问题导致的“数据污染”
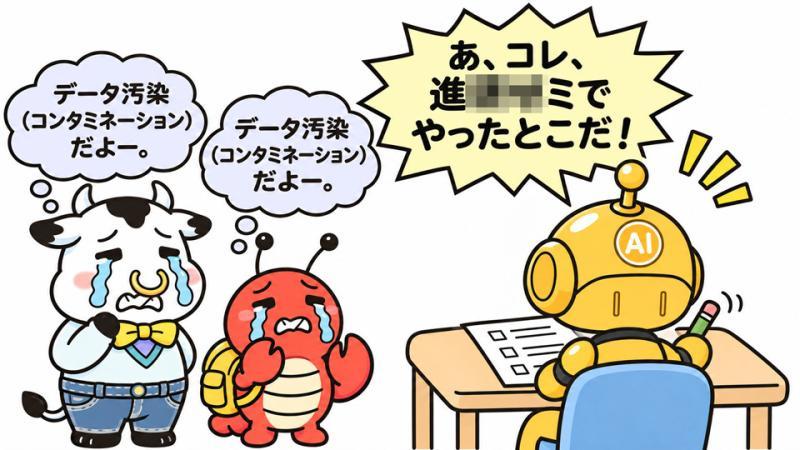
另一大问题是“数据污染”。如果公开的测试题和答案被纳入AI训练数据,AI就可能“背题”,无法准确衡量其解决未知问题的能力,类似考试前看过真题答案。
2024年2月,OpenAI停止公布编程能力测试“SWE-bench Verified”的分数。
该测试由专家挑选的500题组成,是衡量模型编程能力的经典指标。
调查发现,AI未能通过的138题中,59.4%存在评分或题目本身的严重缺陷,正确修复也可能被判不合格。此外,顶尖模型在部分题目中复现了人类编写的修复代码,表明训练时可能已见过这些题目。
这使得分数提升难以判断是否真正代表AI实力的增长。
类似“汽车标称油耗”,需看具体条件
AI基准测试类似汽车的“标称油耗”,在统一标准下可作比较,但实际表现受道路和驾驶方式影响。
AI表现也受提示词设计(第3期介绍)、推理模型复杂度(第5期介绍)、外部工具和运行环境等因素影响。测试题数量少时,几分之差难以决定优劣。
因此,“基准测试第一”不等于“实际工作中最优”。关键是了解测试测量的能力和条件,理性看待排名,将其作为了解AI优势和不足的参考工具。