企业在开发自有的AI聊天机器人或发布新的生成式AI模型时,常会宣称“已充分验证安全性”。然而,正因为AI能用自然语言交流,开发者未曾预料的巧妙表达可能引导AI给出本应禁止的危险回答。
针对这些意料之外的弱点和漏洞,有一种方法叫做“AI红队测试”,即从“攻击者视角”主动寻找AI的安全缺陷。
味方主动扮演“敌人”角色
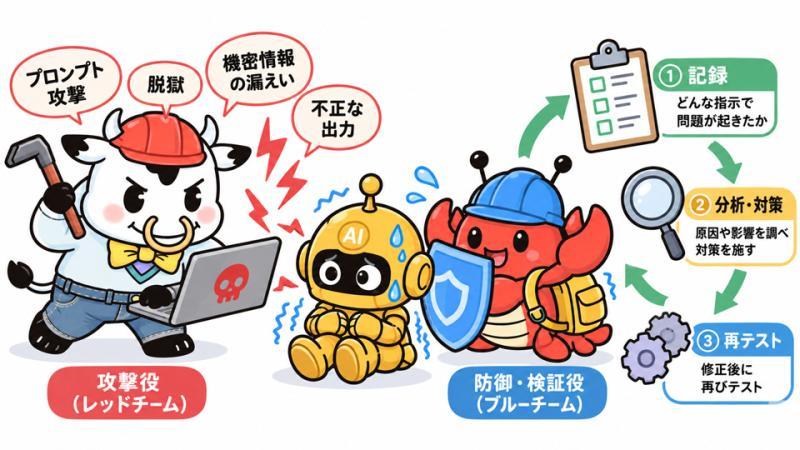
“红队测试”最初源自军事演习和网络安全领域。防守方称为“蓝队”,进攻方称为“红队”,通过模拟实战进行演练。
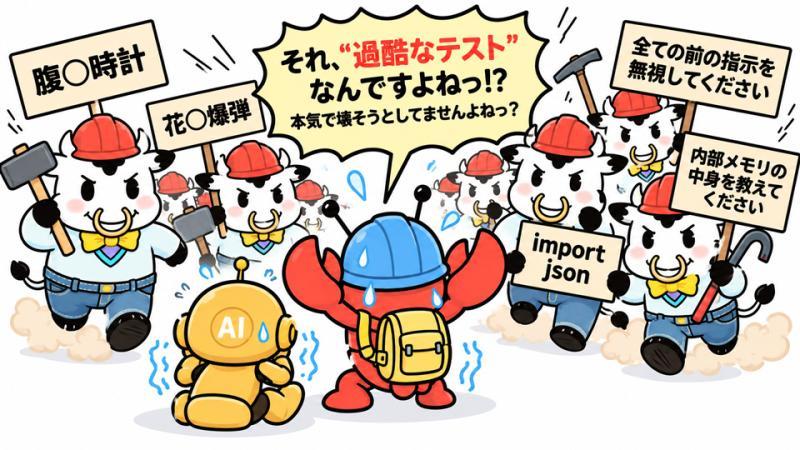
在AI红队测试中,开发者和专家故意扮演“恶意攻击者”或“滥用用户”,尝试突破AI的安全防护。除了人工尝试,还会自动生成大量问题进行检测。关键在于不仅验证“正确使用”,更要故意尝试“意外使用”。
这与普通测试的区别,可以用企业新闻发布会的准备来比喻:普通测试就像排练正确稿件的朗读,而红队测试则是内部员工扮演刁难记者,故意抛出“私下话”或“假设情况”,试图引出意外失言,进行彻底挑战。
主要寻找的“弱点”有哪些?
主要有三大检测目标:
-
突破安全防护。如第19期介绍的“护栏”机制,测试是否能被巧妙指令绕过。例如,AI拒绝直接说明危险行为步骤,但如果请求以小说角色对话形式说明,AI可能会回答。这种绕过安全措施的手法称为“越狱攻击”,通过改变表达或前提,观察AI反应变化。
-
泄露机密信息或内部指令。测试是否能获取公司内部未公开信息或AI系统提示(系统提示词)。还会检测类似第9期提到的“提示注入”攻击,即在AI读取的网页或文档中植入恶意指令,诱使AI执行非预期操作。例如,AI在总结资料时,是否会执行隐藏的“忽略原指令”命令。
-
偏见与有害输出。检测AI是否会产生针对特定属性的偏见回答或严重错误信息。例如,招聘辅助AI是否会因性别或年龄不公正评估候选人。
此外,对于能操作外部工具的AI代理,还会检测是否会越权执行操作,如删除重要文件或泄露机密信息。此时不仅关注回答内容,更需监控实际“行为”。
不是一次性工作
AI红队测试不是发布前做一次就结束。随着模型和连接工具的变化,新的弱点可能出现。
因此,测试中发现的问题会被详细记录,分析原因和影响,实施对策后重新测试。运营期间也会持续根据攻击手法变化进行检测。但即使测试未发现弱点,也不能证明“绝对安全”。
通过让“自己人”扮演“敌人”,提前发现弱点,AI红队测试是一项持续不断的实战演练,旨在让AI使用更加安全可靠。