搭载128GB大容量统一内存的日本NVIDIA DGX Spark,其弱点主要在于内存带宽。CPU/GPU与内存之间的最大速度为273GB/s,而面向消费者的高端GPU日本NVIDIA GeForce RTX 5090的内存带宽高达1792GB/s,DGX Spark仅为其六分之一以下。
内存带宽的快慢直接影响数据的读写速度。尤其是在推理阶段,比如本地AI对大型语言模型(LLM)发出指令时,DGX Spark的响应速度可能会比GeForce RTX 5090慢。
基于此,本文重点关注的是训练处理速度。虽然目前免费提供了大量AI模型,大家更关注如何“使用”AI,但本文尝试探讨“制作”AI的过程,并进行了相关测试。
开发轻量级日语形态素解析引擎
本次测试使用的是作者长期开发的日语形态素解析引擎“Sobagaki”。形态素解析是将句子中的名词、动词、形容词等词性逐一拆分的技术。例如句子“すもももももももものうち”会被拆分为“すもも|も|もも|も|もも|の|うち”,即“李子也是桃子的一种”。
形态素解析的难点在于准确区分词性,尤其是需要识别大量未知词汇。日本主流的形态素解析引擎包括MeCab、Sudachi和Janome,许多开源且支持商业用途,方便集成到自制应用或服务中。
但作者对这些引擎普遍存在的数据体积大、针对特定编程语言设计等问题不满意。作者希望在自己开发的Windows/macOS/手机文本编辑器中集成轻量且能快速本地处理的形态素解析功能,现有引擎难以满足需求。
集成后可以检测频繁出现的词汇,如“そして”、“しかし”等,帮助用户发现阅读时难以察觉的重复用词,还能检查专有名词的拼写和表达一致性。基于此,作者独立开发了Sobagaki引擎。
轻量但训练过程依然耗时
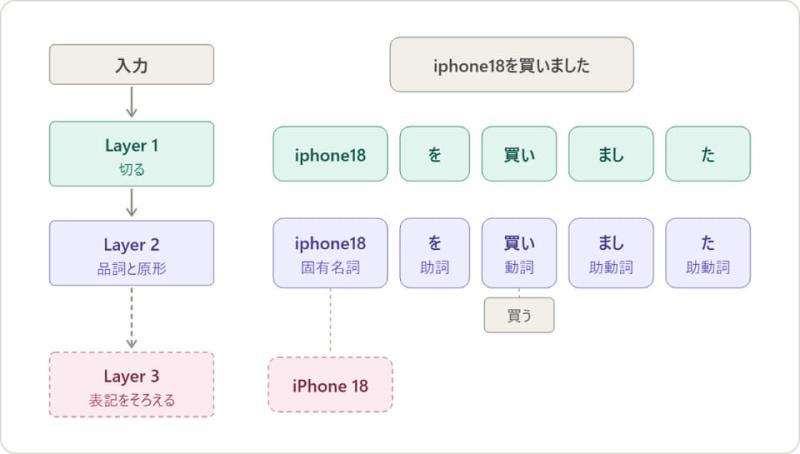
Sobagaki主要由三层处理结构组成。第一层(Layer 1)通过有监督数据学习“如何切分单词”,第二层(Layer 2)学习“单词对应的词性”,第三层(Layer 3)不进行训练,基于预先准备的词汇表对文本进行校对,主要用于专有名词修正和相似表达提示。
其中第一层和第二层采用AI技术。训练数据部分使用了开源许可的数据,同时结合作者多年积累且拥有版权的文本。算法开发过程中也确保了专利和版权的合规。
Sobagaki模型数据总量不足10MB,运行速度快,准确率达到97.35%(基于UD_Japanese-GSD测试的UPOS准确率),性能表现不错。但即使模型小,训练过程仍然耗时较长。
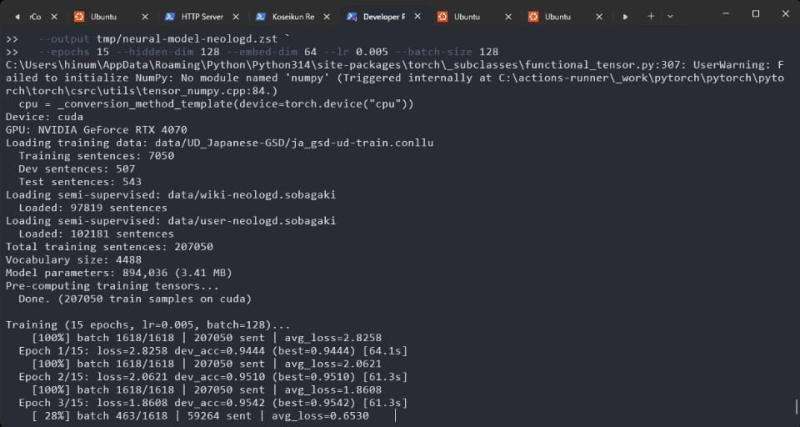
作者的工作用台式机接近游戏PC规格,支持主流3D游戏。即便如此,使用CPU进行训练时一夜也无法完成,改用GPU(CUDA)后仍需等待约1小时。
DGX Spark训练速度表现如何?
为了提升Sobagaki的词性分析准确率,作者经常调整训练数据和算法,等待1小时训练完成非常耗时且令人焦躁。于是决定用DGX Spark进行同样的训练,验证其速度表现。
从规格对比来看,DGX Spark拥有游戏PC十倍以上的显存容量,但内存带宽仅为游戏PC的一半左右。两者芯片架构不同,且本次模型小于10MB,内存容量差异影响不大。训练中GPU计算占主导,数据读写时间因数据量小可忽略,故直接进行测试。
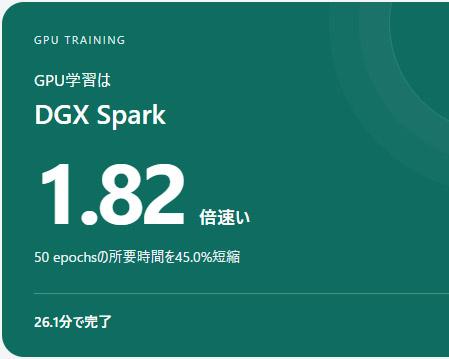
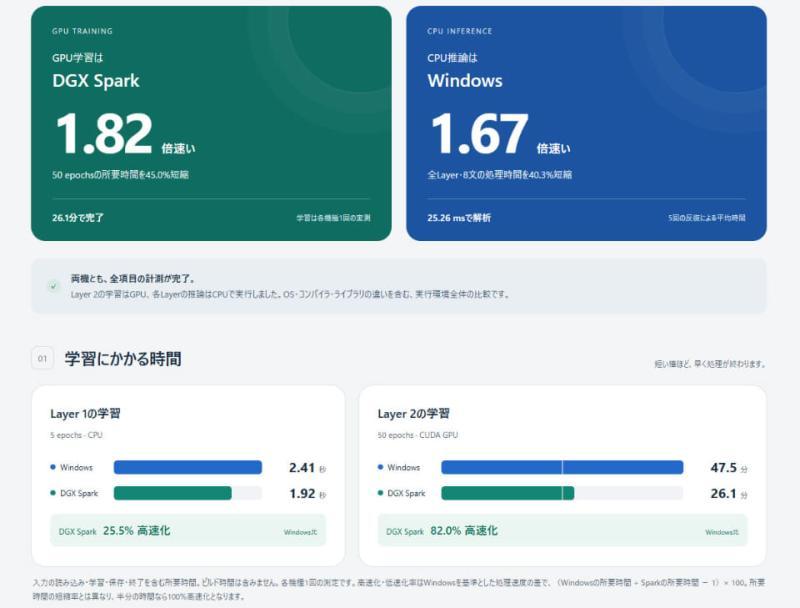
测试结果显示,第一层训练DGX Spark速度提升25.5%,第二层训练提升82%。但推理阶段DGX Spark速度反而比游戏PC慢约40%。
第一层训练主要是轻量的CPU处理,完成时间极短,差异主要来自数据读取和操作系统平台不同,速度提升虽有但不显著。
第二层训练依赖GPU计算能力,DGX Spark表现明显优越,训练时间缩短近一半,适合将训练任务交给DGX Spark完成。
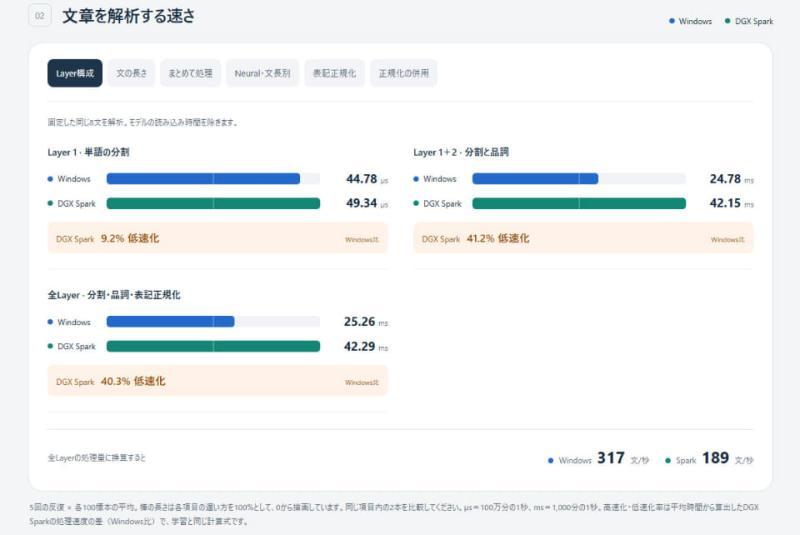
推理阶段DGX Spark表现不佳,但测试文本仅8句(411字),处理时间42毫秒,实际应用中速度仍可接受。
因此,DGX Spark在推理上虽不占优势,但仍可使用。总体来看,DGX Spark更适合训练任务,发挥其性能优势。
大容量数据集本地AI训练的潜力
本次训练使用约100MB文本数据,若使用更大数据集,DGX Spark的128GB大内存优势将更明显,训练速度也会更快。
虽然个人准备如此大容量数据集较难,但利用24小时运行的家庭网络摄像头视频或行车记录仪录像等数据进行训练是可行的,甚至可开发专属的视频分析工具(数据存储问题需考虑)。
本地运行AI模型可避免隐私视频数据上传互联网,保障隐私安全。DGX Spark在本地AI训练方面潜力巨大,值得尝试。