AI正在推动持续集成的演进
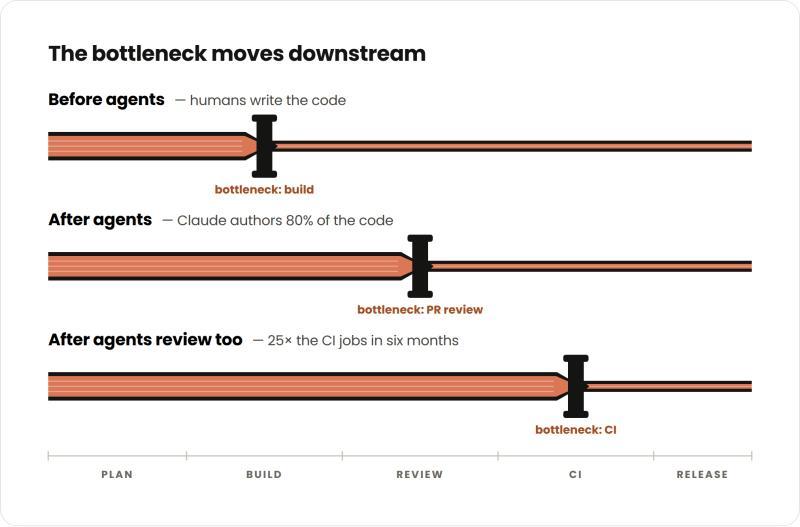
Anthropic的工程师们平均每季度提交的代码量是2021至2025年期间的8倍。Claude负责撰写其中80%的代码,同时在代码审查和合并请求审批中也发挥了重要作用。
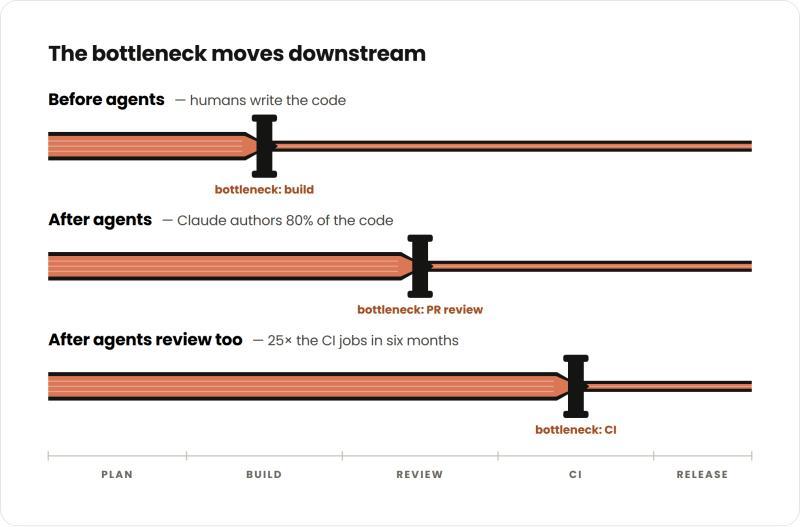
此外,我们代码库中的测试数量增长了10倍,而工程师人数仅略有增加。这导致在六个月内,持续集成(CI)作业数量激增了25倍(并非每个测试都会在每个合并请求上运行,稍后会解释)。
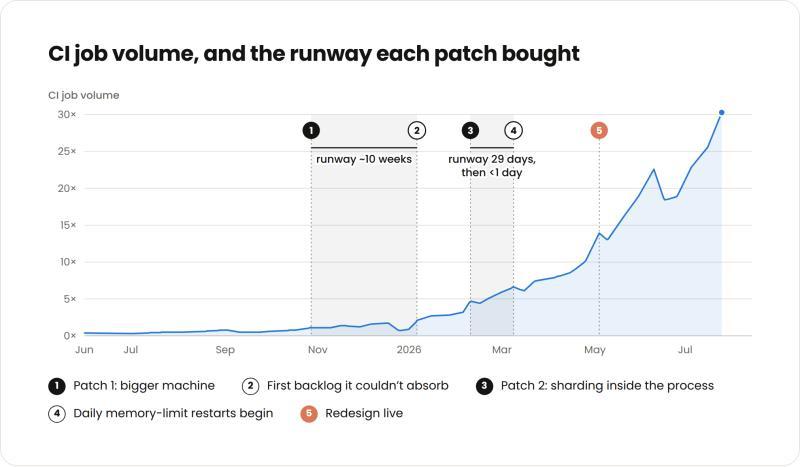
这多次威胁到我们的测试影响分析服务的承载能力。为了避免成为新的瓶颈,我们彻底重构了该服务的架构。这个过程并非一帆风顺,最初尝试了三次快速修补,分别持续了70天、29天和不到一天。
随着智能代理加速代码生成和审查,越来越多的工程团队将面临持续集成扩展的挑战。我预计,水平扩展的测试选择架构将成为行业标准,因为使用智能代理的团队会产生更多的合并请求和测试。
本文将介绍Anthropic如何扩展测试影响分析服务,以及我从中学到的重要经验:始终为指数增长做好规划。购买更大机器、并行处理或重启服务等常见扩展手段并非本文重点,关键是这些方法带来的时间收益远不及一年前。
彻底重构服务虽然耗时,但更可持续,因为代码编写已不再是瓶颈。越早预见压力并规划架构演进,就能避免浪费时间在临时措施上。
测试影响分析架构
许多同行所在的组织仍然对每次代码变更运行所有测试,这种方式在一定规模下可行,但难以扩展,导致持续集成门槛变长、成本高且不够可靠。
此外,人类能判断哪些测试失败不相关,而智能代理则需要更多上下文和指引。给代理一组有效测试后,它们能更好地自我验证和迭代。
Anthropic构建了一个确定性的测试影响分析服务,根据历史表现和包相关性决定每次变更运行哪些测试。这种做法并不罕见,市场上也有相关供应商。
我们的服务依赖两个确定性组件同步:
- 监听器(listener):记录每次CI运行的测试结果。
- 选择器(selector):读取测试结果历史,决定每个打开的合并请求运行哪些测试。
该方案有效,但当每秒有多个CI作业运行时,监听器会逐渐落后于合并请求队列。对于AI原生的软件开发生命周期,哪怕是小的延迟也会带来大影响。例如,监听器延迟20分钟可能导致数万个测试结果未及时更新给选择器。
- 如果有错误变更合并,测试失败会影响所有人,引发大量无谓调查。
- 依赖项不稳定时,频繁的失败阻碍合并。
- 新增或修复测试未被及时执行,存在回归风险。
由于需要维护每个测试的运行历史,监听器设计为单进程单写入者,限制了水平分片扩展的可能。
重构之路的坎坷
去年10月,服务已显现压力迹象,我们连续两天收到告警。
修补1:更大机器
第一步是简单地将服务运行的核心数翻倍,但我们知道这只是权宜之计。
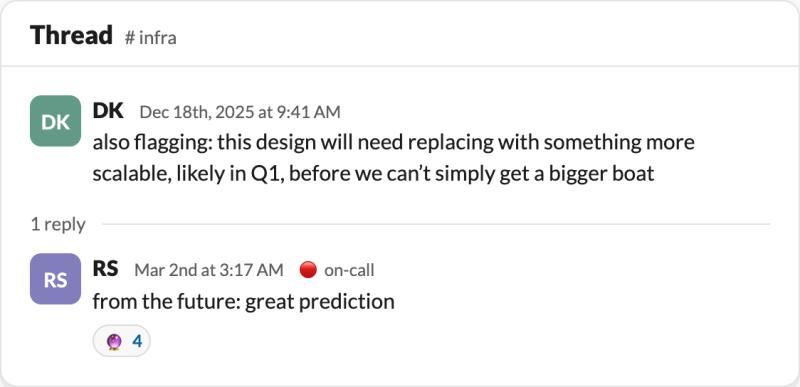
尽管趋势明显,但责任归属不清晰,没有人愿意接手额外基础设施,CI团队也有更重要的任务。
修补2:分片
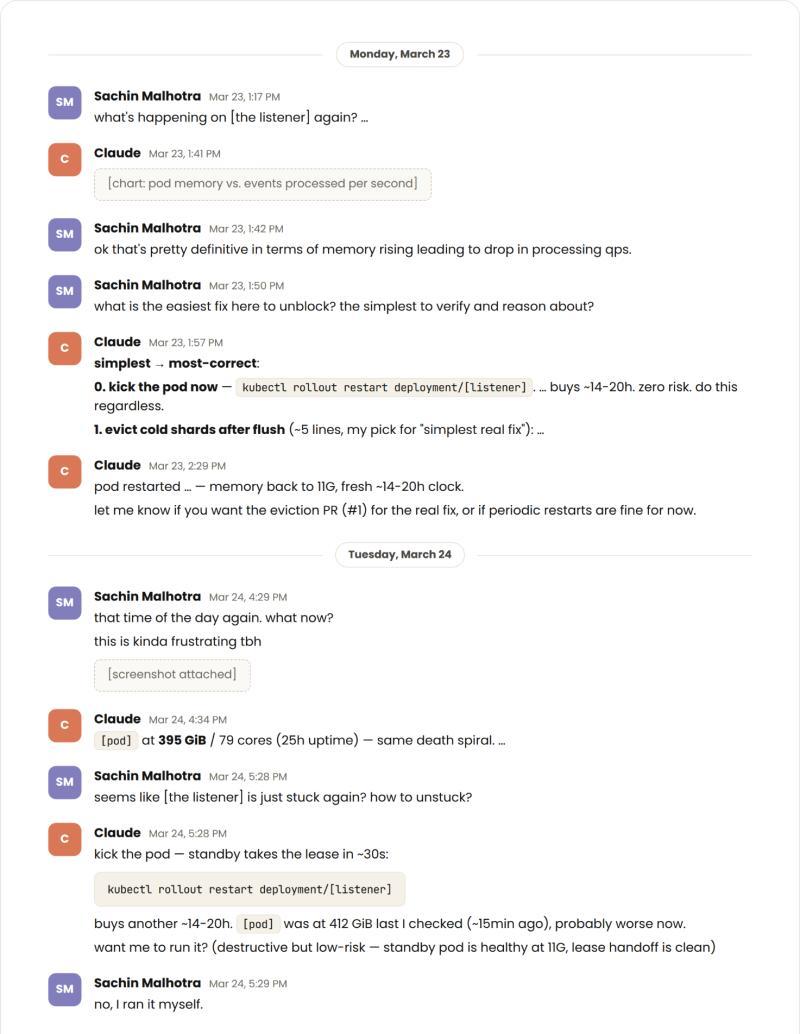
监听器延迟频繁触发告警,为了推动长期解决方案,我启动了一个内部版Claude Tag的长期会话,专门监控服务状态。当监听器落后超过5万个作业时,Claude会提醒我并继续讨论下一步措施。
这持续了数月,避免了重复说明背景。Claude多次建议彻底重构,但我们通常选择再打个补丁。
2月,CI作业的指数增长再次加剧压力,这次我们决定并行化处理。
监听器不再需要单一写入者来排序所有测试结果,而是每个包对应一个写入者,分别处理各自代码区块的测试结果。Claude帮我们生成了代码,将每个包的状态拆分成独立分片并分配给各个工作线程。
我们知道这仍是临时方案,但没想到它只延续了29天。
修补3:每日重启
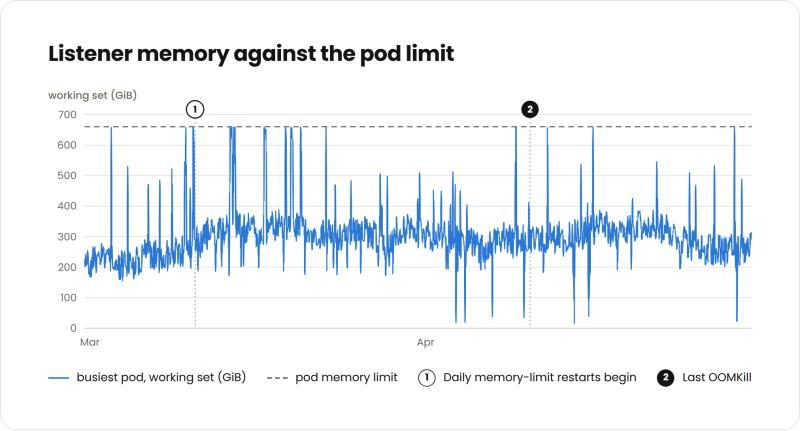
3月,服务在多数工作日下午达到内存上限。我们尝试快速修复:
- 只发现四个bug。
- 更换内存分配器无效,优化垃圾回收并非根本解决方案。
- 不愿在高负载下对单例服务进行内存分析。
- 重启仅带来不到一天的缓解。
我们还发现每日重启导致服务逐渐落后,超过一小时的延迟多次发生,导致大量测试结果未被监听器记录。
这并不意味着CI未运行或未经测试的代码被推送生产,而是监听器未捕获部分结果,选择器基于过时数据决定测试,通常表现为运行大量已知不稳定或普遍失败的测试。
重构设计
是时候彻底重构服务了,我们采纳了Claude的建议:为测试选择服务引入数据库,准确说是内存数据存储。
这样,我们将大量内存处理从单例中卸载。任何监听器工作线程都可以处理结果,将其追加到内存存储的日志中,做到无状态,从而实现水平扩展。一个独立的消费者进程每隔几秒将日志汇总成每个测试的历史,选择器能快速查询相关结果。
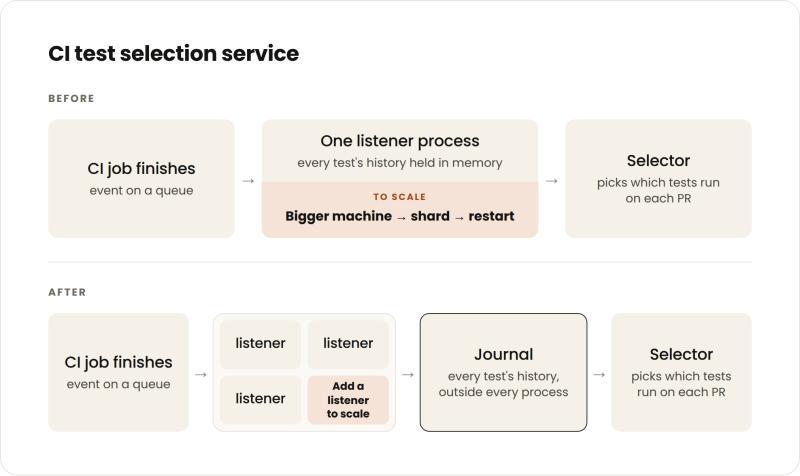
这种分布式架构运行成本更高,但更易扩展和内存分析,远胜不稳定的单例。该项目由一名工程师用三周完成,一年前可能需要一个季度。
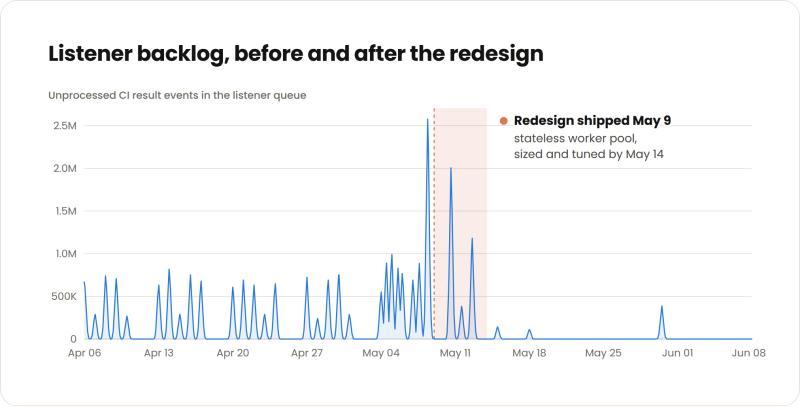
经过Claude的自动调优(日志大小和工作线程数),服务自此保持稳定。
如果重来一次,我会怎么做
如果能回到2025年10月,我会用现在的认知重新规划项目。
首先,我会考虑AI带来的指数增长。随着每位工程师使用的智能代理数量增加,以及加速的合并请求审批,CI作业呈指数增长。
这也改变了Anthropic合并请求的形态,Claude偏好更小、更细粒度的PR(这也是不对每个PR跑所有测试的理由之一),导致每天的CI作业更多。代理在夜间和周末持续推动活动,虽然仍有人工工程师主导和审批大量PR,整体活动水平被抬高且呈爆发式波动。
我的建议是,无论是自建还是采购,设计架构时都应假设两季度内负载会增长25倍。过度设计的理念正在逐渐消失,或者说门槛大幅提高。只要预算允许,初期设计就应考虑10-20倍的规模。
让服务具备类似Claude的“眼睛和耳朵”,帮助它们更快更好地发现和解决问题。尤其要确保输入和输出的CI作业数量保持一致。
从一开始就避免在进程中保存状态。除非能精确测量和控制灰度变更,否则不要让关键服务以单实例运行。CI发展太快,不能再用旧思路。
额外的持续集成资源
我还写过如何利用Claude Tag(测试版)加速CI值班响应,详情见这里。