在生成式AI已成为现代工作不可或缺的背景下,企业面临着新的挑战。随着使用量增加,云端AI的成本不断攀升;机密信息无法外传,导致AI处理受限;网络不稳定或无法连接时,工作效率下降等问题日益突出。
针对这些问题,混合AI策略应运而生,即合理区分云端AI与本地AI的使用场景。复杂推理和大规模信息检索交由云端AI处理,而文档搜索、摘要、草稿撰写等日常任务则由本地AI完成。然而,许多人对本地AI的性能和速度仍持怀疑态度。
本文结合日本AMD的观点,探讨本地AI是否已达到普通办公人员可用的水平,并测试了最新处理器支持下的新一代本地AI环境性能。
AI成本与信息管理的挑战日益复杂
生成式AI在企业中的应用已从试点进入日常阶段。无论是任务梳理、报告撰写还是演示准备,AI的使用已成为常态。
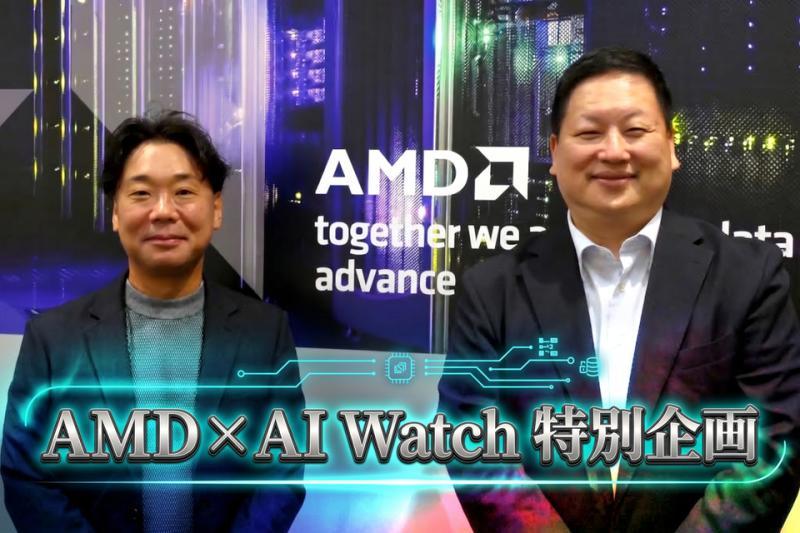
但随着使用者和频率增加,云端AI的使用成本成为企业关注的焦点。日本AMD商业销售部部长杨博光指出,许多企业反映“云端AI费用已不可忽视”。
杨博光表示:“未来AI将作为智能代理广泛应用,如何管理AI成本成为关键。除了按使用量计费的云端AI,企业还需部署本地AI,将能本地处理的任务留在本地完成。”
此外,数据安全也是重要问题。杨博光指出:“公开信息适合云端AI处理,但未发布的产品资料或客户信息不适合上传云端。大型企业可构建专用环境,但并非所有企业都有此能力。”
因此,本地AI成为关注焦点。日本AMD销售工程经理关根正人认为,尽管云端AI在性能和知识库方面占优,但日常办公任务如文档处理、基于资料的问答(RAG)、邮件草稿等,本地AI已能胜任。
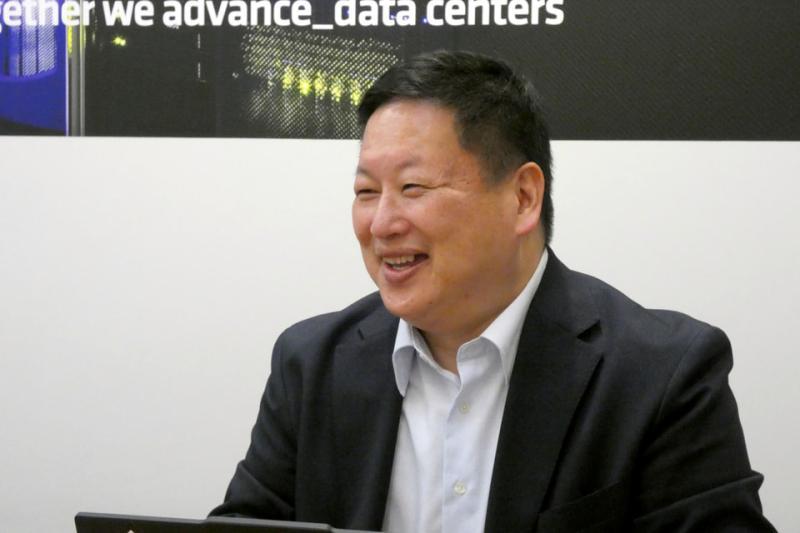
关根正人强调:“停止使用云端AI不现实,关键是避免将所有任务都发送云端。合理分配云端与本地AI的使用,构建混合AI体系至关重要。”
本地AI不再是“复杂且精度低”的代名词
部分读者可能曾尝试过本地大型语言模型(LLM),但因安装复杂、响应慢、精度不足而失望。过去确实如此,但现状已大为改观。
随着实用的开源模型增多,配备RAG和智能代理功能的应用也变得易用。采访中,关根正人演示了4B级模型对英文资料的摘要及问答,以及AI代理从网络收集信息并生成销售文案的过程。
他表示:“过去半年,LLM和开源AI代理应用飞速发展。曾觉得本地LLM‘不可用’的用户,建议重新体验当前环境。”
当然,小型本地模型无法完全替代云端大模型,复杂推理、系统集成和高质量内容生成仍需云端AI支持。但资料摘要、定位搜索、模板草稿和头脑风暴等任务,本地AI已具备实用水平。
针对AMD平台优化的本地AI入口“Lemonade”
许多用户对本地AI望而却步,原因在于模型获取、格式选择、运行环境配置及硬件利用等门槛较高。
开源本地AI执行平台“Lemonade”降低了这一门槛。它支持文本、图像、语音等多种AI模型,用户可通过界面轻松浏览、下载并试用。
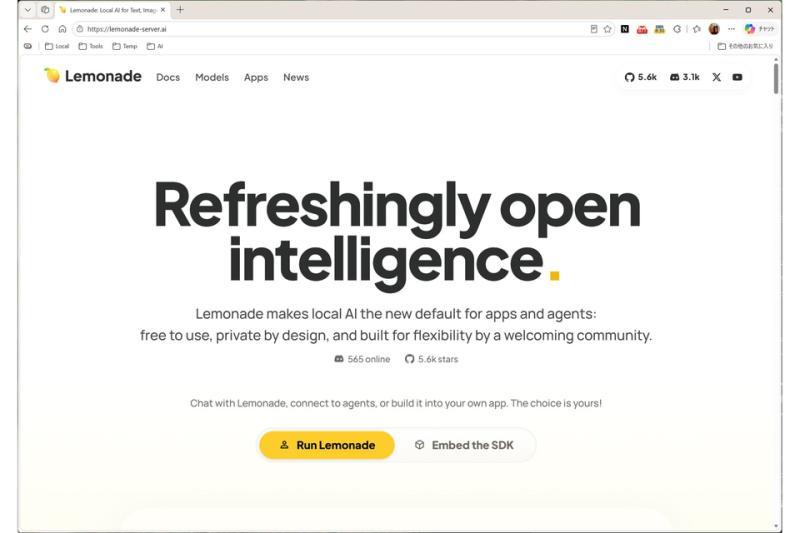
与知名工具LM Studio相比,Lemonade由日本AMD技术人员积极参与开发,针对AMD Ryzen AI处理器进行了优化。
关根正人介绍:“普通用户不知从何入手试用本地AI,AMD提供Lemonade作为入口,支持利用Ryzen AI的NPU和内置GPU,轻松运行模型。”
现代PC配备NPU和高性能GPU,并支持统一内存分配,关键是软件能充分利用这些硬件。只有具备合适模型和运行环境,才能让本地AI真正助力工作。
AMD不仅提供Ryzen AI硬件,还支持Lemonade平台、针对NPU的FastFlowLM推理引擎及优化模型,全面助力本地AI生态建设。
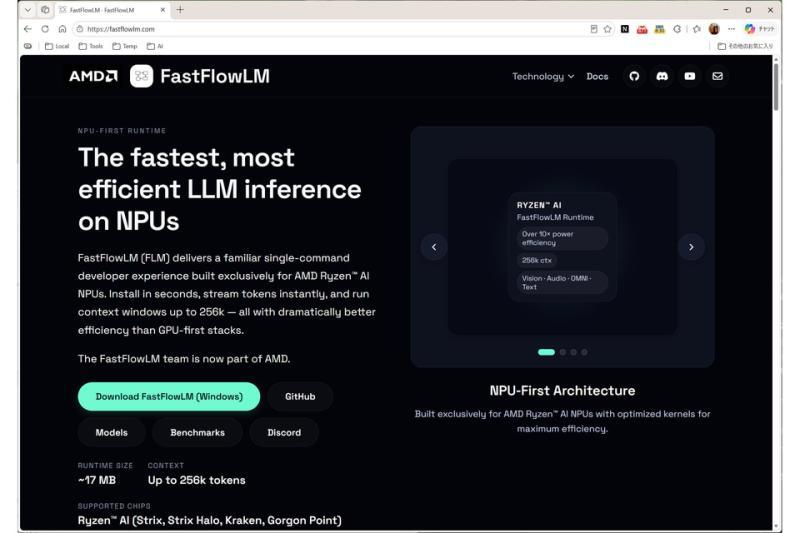
关根正人解释:“LLM处理分为输入预处理和回答生成两部分。针对Ryzen AI优化的模型,将预处理任务分配给NPU,回答生成由内置GPU完成,形成混合计算架构。也有仅用NPU的模型。推荐使用支持FastFlowLM的FLM模型,能高效利用Ryzen AI的NPU。”
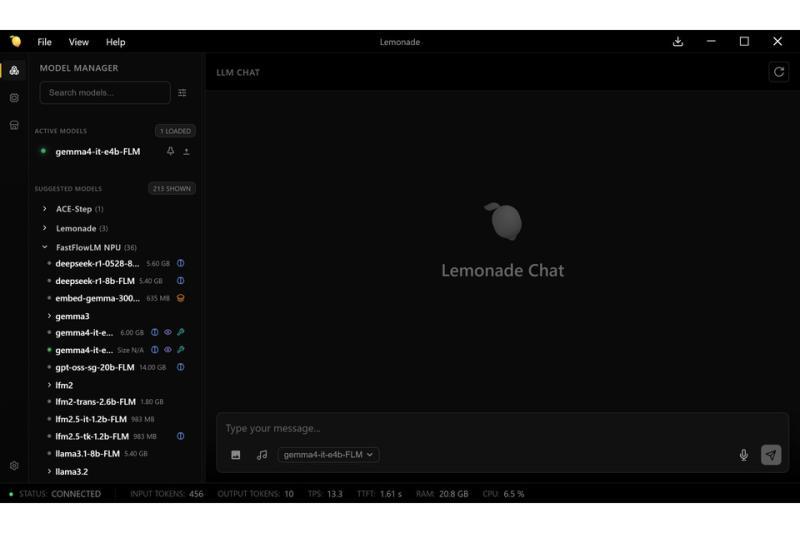
Lemonade的优势在于模型按类别分类,图标显示适用场景,用户可轻松选择适合的模型。虽然涉及NPU和FLM等专业术语,但只要根据提示选择,任何人都能搭建合适的本地AI环境。
Lemonade与AnythingLLM助力企业业务变革
Lemonade虽便捷,但本质是AI模型运行引擎,功能相对简单。企业用户往往因应用场景多样,难以灵活切换不同本地AI应用。
推荐使用集成应用“AnythingLLM”,它支持聊天、RAG、智能代理和文档管理等多功能,界面统一。选择Lemonade作为LLM提供者,即可实现AnythingLLM界面操作,后台调用本地模型推理。
同时支持OpenAI、Anthropic等云端LLM,方便按部门或任务灵活切换处理方式。
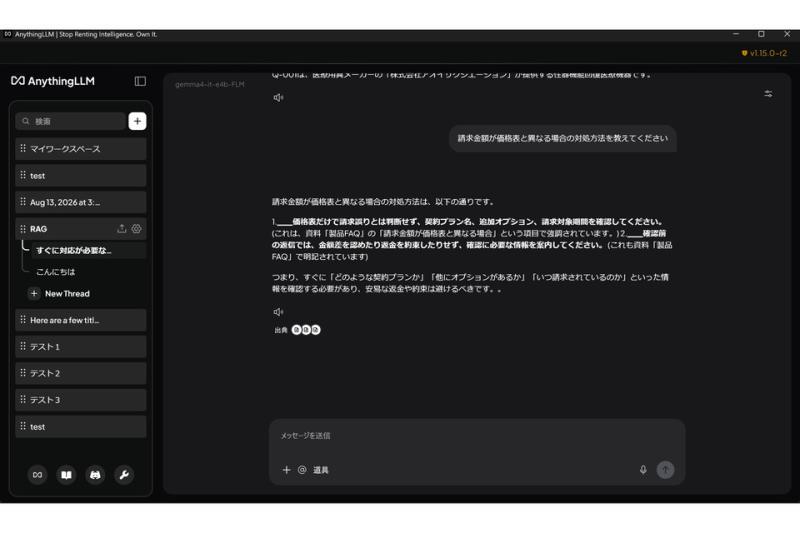
该组合优势在于,即使非专业用户也能为不同工作创建“工作空间”,上传相关资料,方便针对特定内容提问或生成文档。例如,创建“员工手册”、“产品资料”、“销售提案”等工作空间,分别上传对应文档,系统即可基于这些资料回答问题或辅助写作。
实践演示:构建企业内部资料问答RAG环境
以下展示如何用Lemonade和AnythingLLM实现企业内部资料的智能搜索与问答。界面和模型名称可能随版本变化,但整体流程相似。
1. 在Lemonade加载支持NPU的模型
启动Lemonade,从模型列表选择“Gemma4-it-e4b-FLM”模型(支持FastFlowLM和NPU)。
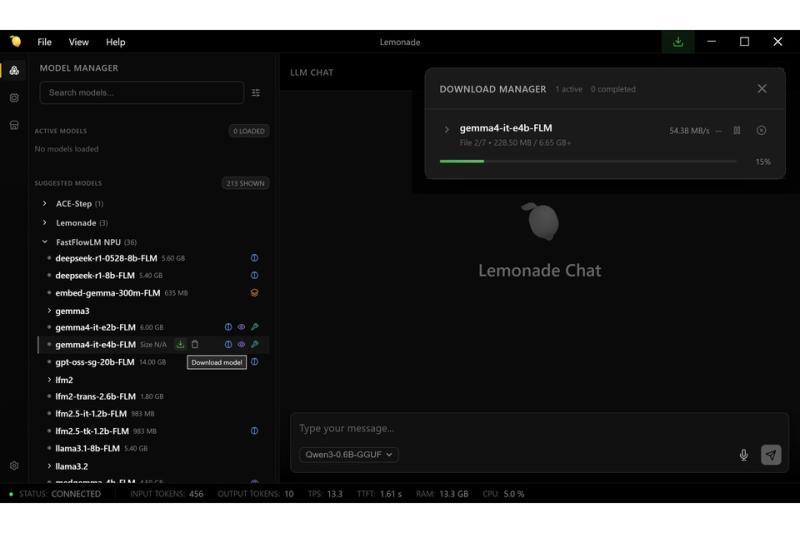
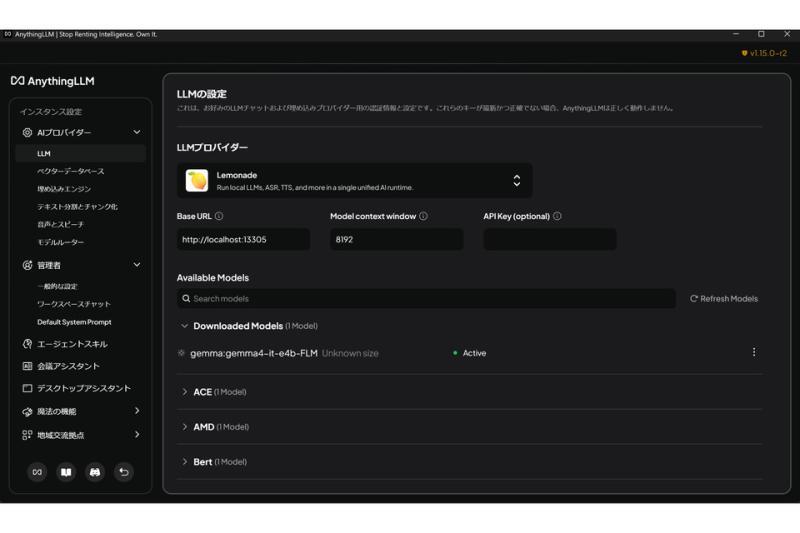
2. 在AnythingLLM中指定Lemonade为LLM提供者
启动AnythingLLM,进入设置,选择“AI提供者”中的“LLM”,指定Lemonade并选择刚加载的模型,激活并保存设置。
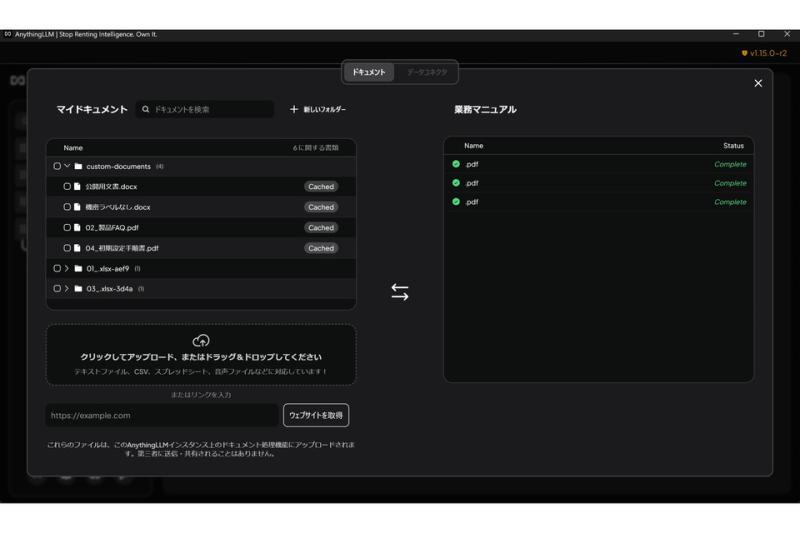
3. 创建工作空间并上传资料
在AnythingLLM中新建工作空间(如“业务手册”),上传PDF等文档,执行“移动到工作空间”和“保存并嵌入”操作,文档将被分割向量化,方便后续检索。
4. 提出问题并获取答案
在聊天窗口输入问题,如“请告诉我如何借用公司车辆,我明天需要用。”稍等片刻,系统会给出答案并显示相关文档出处。
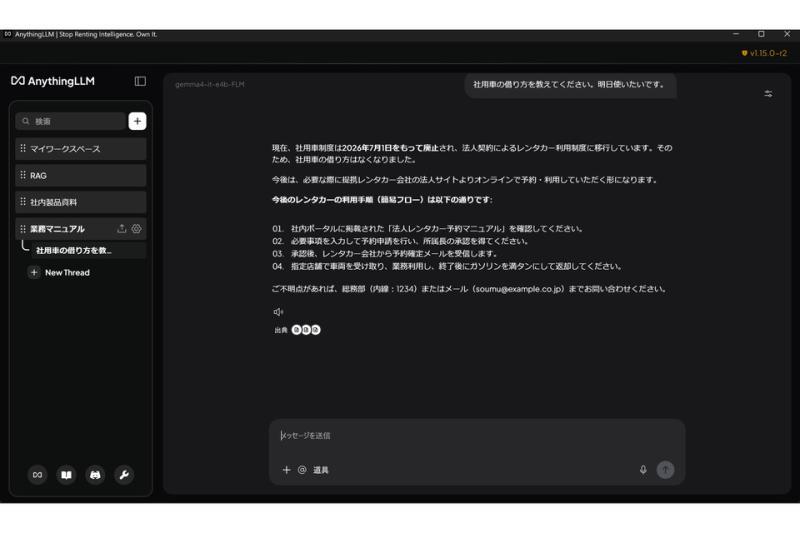
本例中,上传了三份复杂文档:旧版“公司车辆使用手册”、通知车辆废止的内部新闻、以及2026年7月1日起生效的“租车使用手册”。
系统能根据提问中的“明天”推断具体日期(2026年9月1日),识别旧规已废止,准确提供新租车流程,体现了现代本地AI在业务场景中的实用性。
三大场景体现本地AI的实用价值
利用Lemonade和AnythingLLM,企业可轻松搭建本地AI环境,但关键仍在于合理分配云端与本地AI的使用。以下三种场景展示本地AI的优势:
场景一:将日常重复的文档处理转移至本地,分散成本
如销售资料摘要、邮件草稿、会议记录提取等,虽然单次任务小,但频次高。转移至本地AI后,云端AI资源可优先用于复杂分析和开发,提升整体成本效益。
场景二:利用未公开资料进行搜索和草稿撰写,保障机密文档安全
将尚未发布的产品资料和内部规章上传本地AI,进行要点提取和提案生成。避免机密信息上传云端导致的作业中断,必要时仅将公开内容经人工审核后传至云端,完成更精细化处理。
场景三:移动办公时阅读技术资料,不依赖网络环境
无论飞机、高铁还是网络受限环境,只要PC内有模型和资料,即可继续摘要和问答,避免云端拥堵和网络不稳定影响。关根正人表示,NPU运行时功耗约11~15瓦,风扇噪音低,适合会议或旅途中安静使用。
配备NPU的入门级Ryzen AI系列PC
企业关注本地AI适用PC的采购成本。杨博光指出,除了高端机型,企业也可选择价格亲民的入门级PC,结合业务需求选配,降低整体投入。
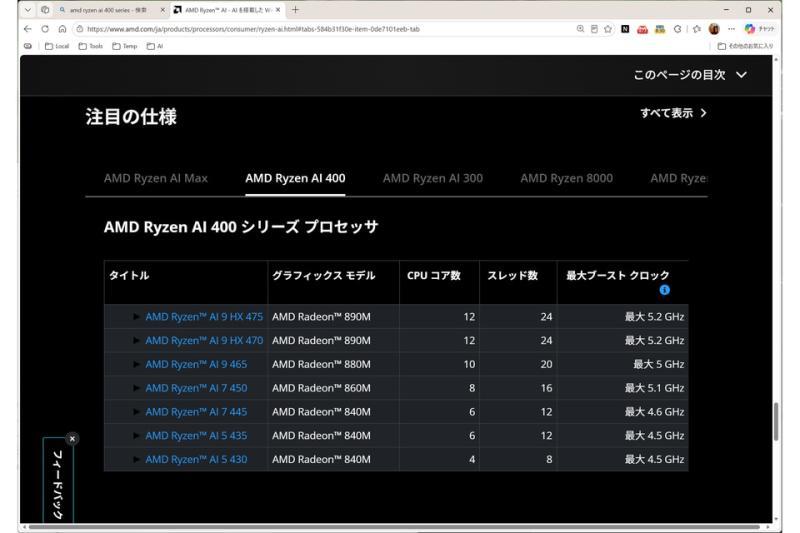
内存容量同样关键。运行本地LLM需处理模型、长文本上下文及其他应用,16GB可能不足,建议至少32GB,以保证多任务环境下的流畅体验。
若未来更依赖智能代理,CPU性能也很重要。关根正人表示,Ryzen处理器的高性能核心对本地AI代理控制尤为有利。
杨博光提醒:“本地AI半年内变化巨大,采购PC时应考虑未来5至6年内的适用性,确保设备能持续支持AI工作。”
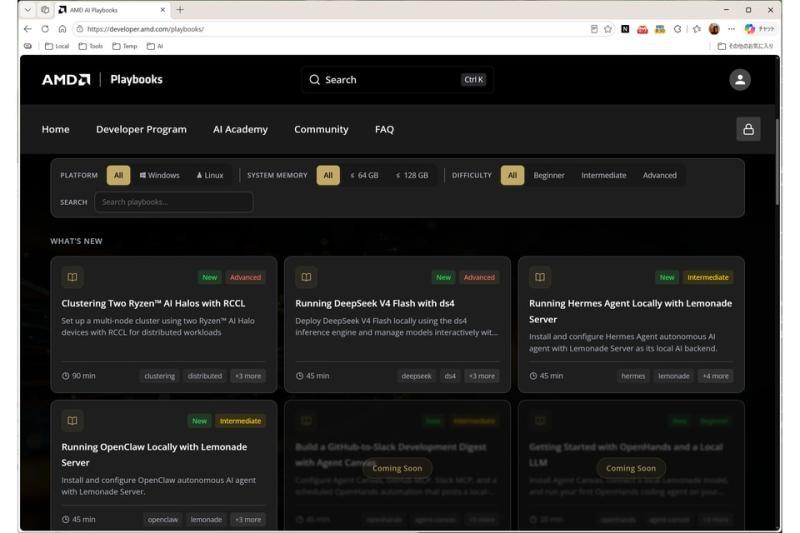
此外,AMD发布了“AMD AI Playbooks”,提供从环境搭建、模型运行到应用开发的详细指南,方便信息系统部门和测试人员开展可复现的PoC项目。
AMD不仅提供硬件,还构建了包括Ryzen AI PC、Lemonade、FastFlowLM推理引擎、优化模型及合作伙伴应用AnythingLLM在内的完整生态,助力企业迈入本地AI时代。
AI时代的PC价值不应仅看操作系统内置功能,更需关注第三方软件和开源项目的支持,结合企业自身信息和规则,将AI深度融入日常工作。Ryzen AI PC为希望深入应用AI的企业提供了强有力的选择。