日本国家理光公司开发了多模态大规模语言模型(LMM)“理光LMM_35B-A3B”。该模型基于阿里巴巴云开发并提供的MoE结构模型“Qwen3.6-35B-A3B”,通过理光自主的强化学习和课程学习技术,显著提升了日语的推理性能。该模型将于11月起逐步集成到“RICOH本地部署LLM入门套件”中。
理光LMM_35B-A3B的主要特点
MoE结构实现高速且节省资源的推理
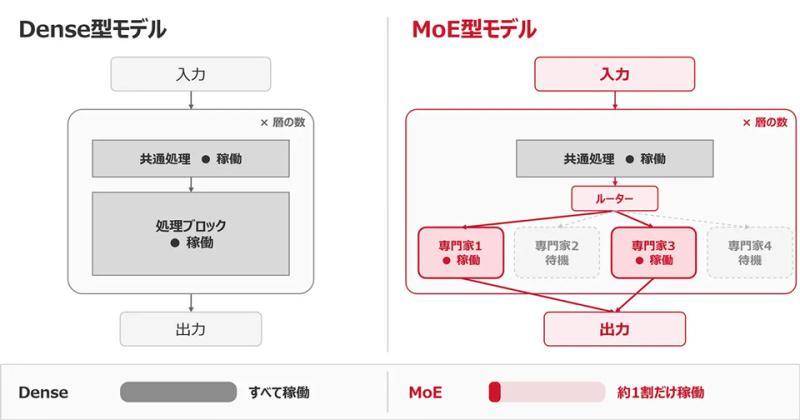
该模型总参数量约为350亿,但推理时仅激活约30亿参数,采用了MoE(专家模型)结构。MoE结构将模型内部处理分配给多个“专家”,根据输入内容选择必要的专家进行计算,从而提高效率并节省计算资源。
日语推理性能显著提升
理光将自主强化学习和课程学习技术针对MoE结构进行了优化,提升了模型对包含图表的企业文档的理解能力。在自有基准测试“JDocQA-Reasoning Benchmark v2.0”中,模型得分从基础模型的0.816提升至0.841。尽管推理时激活的参数仅为基础模型的约九分之一,但性能已达到同系列Dense模型“Qwen3.6-27B”(得分0.841)的水平。
强化日语AI代理性能
除了文档理解和回答生成外,该模型还支持AI代理在业务系统和工具中自主执行任务。在日语AI代理评测基准“j-tau-bench”的通信运营商客户服务场景中,模型在遵守业务策略的前提下使用工具与用户对话,正确完成任务的准确率从基础模型的62.4%提升至77.7%,提升了15.3个百分点。
抑制循环回答,稳定响应时间
推理型模型中常见的“循环回答”问题,即重复输出相同内容,影响实际应用。理光通过在强化学习中引入抑制过长输出的奖励设计,有效减少了不必要的重复,保证了回答质量和响应时间的稳定。
适配小型AI服务器的量子化版本
理光还开发了针对NVIDIA Blackwell及以后世代GPU的NVFP4量子化版本“理光LMM_35B-A3B”。该版本可在单台小型AI服务器“NVIDIA DGX Spark”上运行,量子化后推理性能超过基础模型的量子化版本,且相比BF16版本,单题响应时间缩短至约三分之一(结合MTP技术时缩短至约四分之一)。