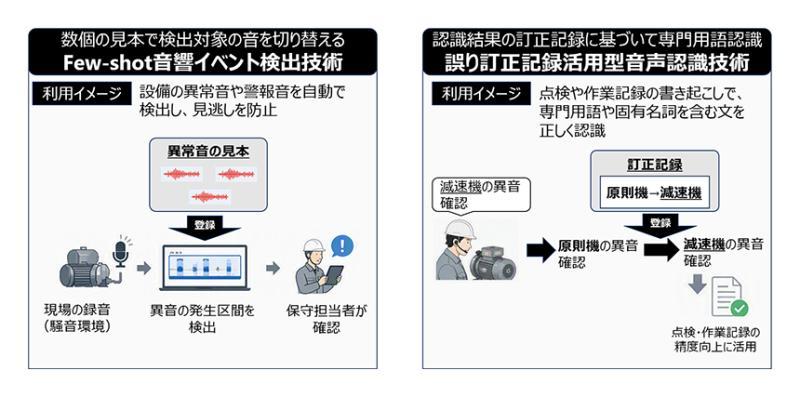
日本东芝公司于10月22日宣布,成功开发出两项能够高精度识别现场不同设备声音、警报音及作业人员发话的AI技术。
在制造业及社会基础设施领域,设备监控和维护人员短缺,以及资深专家知识传承困难,成为亟需解决的问题。设备声音、作业声及工作人员发话中蕴含着设备异常预兆、作业状态及现场特有知识,准确捕捉这些信息至关重要。
然而,传统方法需针对每个现场或用途收集大量音频数据并对AI模型进行再训练,尤其是异常音频数据稀少,且设备运行声等背景噪音严重影响识别准确率。此外,常规语音识别难以准确转写现场特有的新产品名称和专业术语,频繁更新词典增加了运营负担。
为解决上述问题,东芝开发的第一项技术为“少样本音响事件检测技术”。该技术利用预先学习多种声音特征的AI模型,只需注册少量目标声音样本,即可从长时间现场录音中精准定位相同声音出现的时间段,并输出开始与结束时间。
该技术无需大量数据收集和额外训练,能灵活切换检测对象声音,如异常音和警报音。通过从样本和录音数据中推断背景噪音特征,抑制噪音对目标声音的干扰,有效减少在机器运行噪声混杂环境中的漏检和误检。
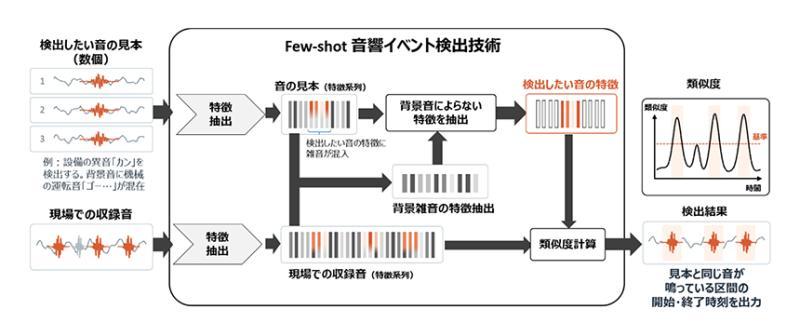
在国际音响事件检测竞赛“DCASE 2024 Task 5”的验证数据评测中,该技术无需额外训练即可达到62.35%的F值,性能媲美需额外训练的公开方法,并支持实时检测。
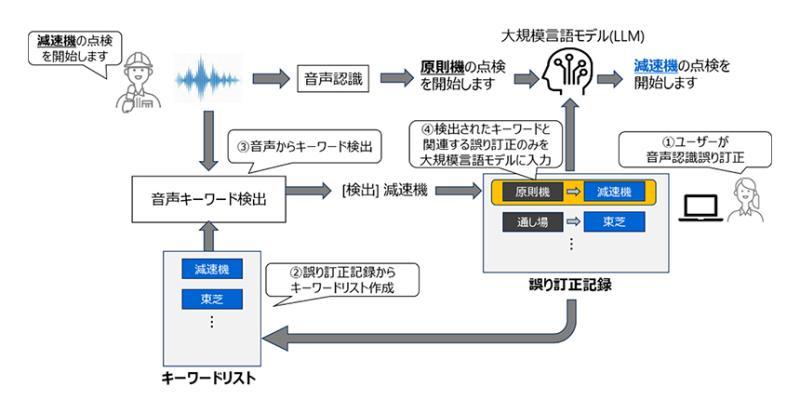
第二项技术为“基于错误纠正记录的语音识别技术”,专注于准确转写包含现场专业术语的发话。该技术通过积累AI错误转写与用户修正的正确表达的纠正记录,输入大规模语言模型(LLM)以自动纠正类似错误。
随着纠正记录增多,若全部输入LLM会增加处理负担且可能降低纠正精度。为此,技术先从语音中检测可能的关键词,仅抽取相关纠正记录输入LLM,提升效率和准确率。
评测显示,与传统仅使用最新记录的方法相比,该技术在减少LLM输入字符数(英语减少70.9%,日语减少71.7%)的同时,关键词识别F值提升(英语由83.6%提升至85.6%,日语由64.8%提升至67.3%)。
东芝计划将这两项技术推广应用于制造、能源、社会基础设施、物流、建筑及呼叫中心等多个领域,支持设备异常检测、运行监控及包含专业术语的作业记录和维护报告的生成,推动现场数字化转型和资深专家知识传承。
未来,东芝将进一步发展这些技术,作为AI深度理解现场状况和隐性知识的基础,结合视觉信息的物理AI,加入听觉信息,实现更全面的社会应用。