近日,日本MiniMax公司发布了一款能够直接生成1600万像素级别图像的AI模型——「MiniMax-H3-Image」。该模型无需通过放大器即可输出高分辨率图像,权重文件已作为开源资源公开,用户可通过Hugging Face平台下载,采用独特的「MiniMax-H3-Image Community License Agreement」许可协议。
「MiniMax-H3-Image」是基于日本MiniMax公司之前推出的视频生成模型「MiniMax H3」衍生而来,集成了文本生成图像和基于参考图像编辑图像的双重功能。该模型支持从1:1的4096×4096像素到21:9的6272×2688像素范围内的图像输出,且无需额外的图像放大处理。用户最多可输入16张参考图像进行辅助生成。
在模型结构上,「MiniMax-H3-Image」移除了「MiniMax H3」中的音频相关层,采用扩散Transformer(DiT)架构,参数量达到331亿,属于Dense类型。文本编码器沿用基于Qwen3-VL的「MiniMax H3」编码器。通过蒸馏技术,模型采样步骤缩减至6步,且无需使用分类器自由引导(CFG),使得1600万像素高分辨率图像生成的计算成本保持在可接受范围内。
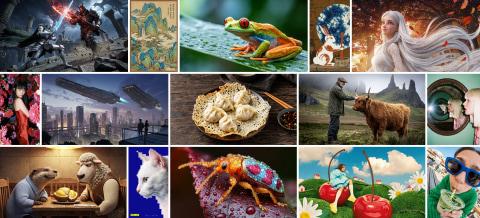
该模型的显著特点包括抑制典型的“AI感”,呈现细腻的细节和高度逼真的真实感,同时在开放模型中具备极高的指令遵循能力。不过,官方尚未公布与其他模型的具体性能对比数据。
模型文件采用BF16格式,大小约为68.65GB,此外还需从「MiniMax H3」仓库单独下载66.7GB的文本编码器。支持在本地环境通过「SGLang」、「vLLM-Omni」、「diffusers」和「ComfyUI」等框架进行推理。硬件方面,兼容美国NVIDIA的「H200」和「RTX PRO 6000 Blackwell」以及美国AMD的「Instinct MI350X」等GPU。
根据「MiniMax-H3-Image Community License Agreement」,该模型在包括日本在内的全球除欧盟、英国、韩国和美国外地区免费开放使用,原则上允许商业用途。但若用户及其关联公司年销售额超过100万美元(约合1.59亿日元),需事先获得MiniMax书面许可。若通过API或Web服务向第三方提供模型功能,也需遵守同样规定。商业产品或服务中使用时,界面必须标注“MiniMax-H3-Image”。此外,禁止将生成的图像输出用于其他AI模型的改进,无论是否商业用途。