小米MiMo-V2.6系列亮相,开创中国AI新纪元
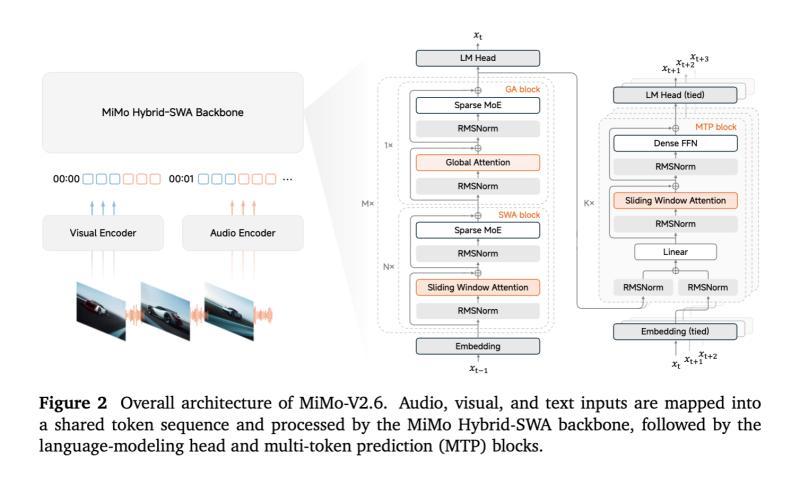
小米,这家被誉为“中国的苹果”的手机制造商,首次以前沿实验室身份发布了全新的AI模型系列——MiMo-V2.6。该系列包括两款原生全模态模型:功能最强大的MiMo-V2.6-Pro和在智能、效率与成本之间取得最佳平衡的MiMo-V2.6-Flash。此外,小米还推出了MiMo-V2.6-Pro-UltraSpeed,能够在保持相同质量的前提下,实现最高20倍的输出速度,满足极端生成速度需求。
小米此前并未被视为中国六大AI虎之一,此次发布的原生全模态模型令人眼前一亮,打破了既有格局。
透明度与训练细节公开
前DeepSeek明星工程师罗富利加入小米后,开始公开发布他们的最终强化学习(RL)训练过程,展现了内部指标的高度透明。
根据小米发布的技术报告,他们在强化学习计算上沿三个方向扩展:
- 更大批量与更高吞吐量:采用完全异步架构,每次更新处理1568个样本,支持最长100万上下文长度,每步训练3.5至3.7亿个token。
- 更多任务与丰富环境:多任务训练套件涵盖编码、通用代理、视觉与网络安全等多个领域,任务间相互促进能力提升。
- 更多评分计算:组内相对比较提供更精准多样的奖励信号,形成自我提升闭环,引导模型走更短路径,减少每个任务的token数量。
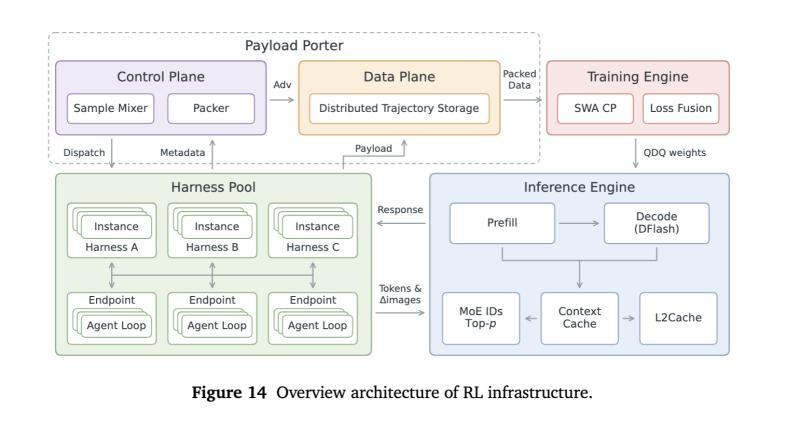
所有环境代码和训练配方将开源,但完整的7000+任务数据集尚未发布。开源内容包括:
- 编码/软件工程训练配方及数据加载器
- 网络安全漏洞复现环境及训练配方
- 通用知识工作环境及工具
- 视觉与网页开发环境及评分系统
- 音乐生成数据准备及评分器
- 可组合的小型训练模块配置
- 共享环境适配器
AI领域最新动态回顾
开源模型与中美竞争
开源模型依然是政策和市场的核心话题。多位专家指出,尽管前沿能力似乎在某些领域达到瓶颈,开源模型以10至50倍更低成本持续缩小差距。中国实验室发布节奏加快,多个团队推出了具备可信成本效益的前沿规模专家模型(MoEs)。
小米MiMo-V2.6及强化学习的新突破
MiMo-V2.6-Pro以1.02万亿总参数(活跃参数420亿)成为当前顶级开源权重模型,成本效率显著,且采用MIT许可证。强化学习堆栈和环境的高质量开源被认为是未来战略重点,强化学习训练仅耗时约130小时,使用75亿token,成本约260万美元,表明后训练强化学习成为提升模型性能的经济有效路径。
专用推理模型的回归
Jev等决策模型因其低延迟和高效能受到关注,适合路由、审批门控、工具选择等场景。生态系统快速扩展,支持多种应用和工具集成。
推理与系统优化
Hugging Face发布了新一代tokenizer,速度提升30倍,内存占用降低。Halo框架提升推理吞吐量近3倍。多项工程优化显著提升模型推理效率,包括KV缓存优化和视频解码加速。压缩与量化技术持续进步,腾讯混元等团队实现了大规模模型的高效混合精度量化。
代理系统与安全
计算机使用系统逐渐走向生产化,安全问题成为核心关注点。Meta等公司提出了防范提示注入攻击的设计理念。商业代理深入工作流,支持命令行直接访问虚拟机等功能。推理和代理基础设施正向测试时计算转移,要求全新架构支持。
近期热门推文精选
- SpaceXAI发布Grok 4.7,性能提升明显。
- OpenAI自动化训练流程大幅缩短实验周期。
- OpenAI数学顾问组成立,声称解决百余数学难题。
- Eidon AI开源大量机器人第一视角数据,促进社区发展。
Reddit社区热点
Qwen-Image 2.1及轻量级图像模型
Qwen-Image 2.1发布,7B参数,支持原生RGBA透明图像生成与编辑,支持多达10张参考图像,具备多区域本地编辑能力。该模型体积较之前20B参数版本大幅缩小,适合16GB显存GPU本地推理。许可方面,输出内容归用户所有,但模型本体仍有限制商业使用的条款,存在一定争议。
小米MiMo-V2.6-Pro的发布不仅展示了中国AI实验室的实力,也为全球开源模型生态注入了新的活力。强化学习训练的高效透明和丰富环境开源,预示着未来AI模型开发的新趋势。